UPTURN:在推理分岔处重开用户回合
紧张 token 预算下,保留正确前缀并改变后续推理,比重新采样更有效吗?
UPTURN 冻结推理模型,训练小型位置策略选择段落边界,再插入一个新的用户回合请求简洁求解。论文的重要性在于区分“沿原轨迹加反思词”和“真正重开对话回合”;收益主要出现在生成预算紧张时,不能概括为任意预算下都优于多采样。
图解主要方法
紧张 token 预算下,保留正确前缀并改变后续推理,比重新采样更有效吗?
- 1
筛出需纠正的轨迹
先生成16条候选,用独立正确性门控判断哪些需要重做。门控由冻结 Qwen3-0.6B 编码器与约66K参数头组成;无可解析答案时分数置零,默认阈值0.4。它不是能保证正确的验证器。
- 2
学习在哪个段落截断
位置策略只看问题和截至候选切点的前缀,避免读取将被丢弃的未来文本。在双换行处打分,以续写后正确率训练约133K参数头;编码器与推理模型冻结。30步、每步64个保留问题,多次采样截点及后续答案,不应把小头参数量当作全部训练成本。
- 3
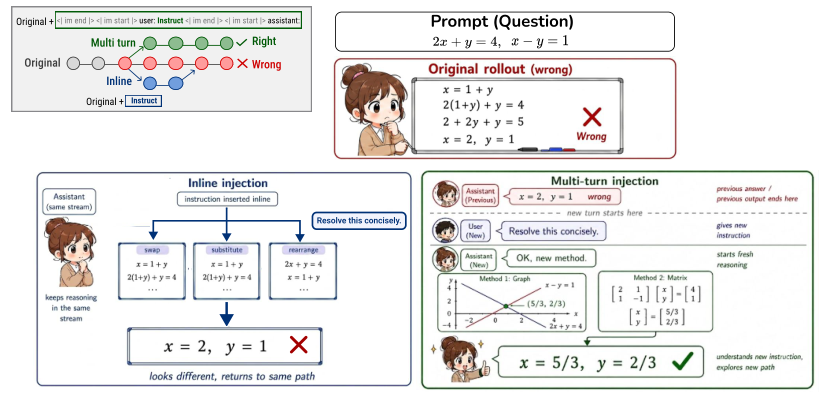
重开用户回合而非行内加词
保留选中的推理前缀,按聊天模板关闭原助手回合,必要时闭合思考标记,再插入请求简洁求解的新用户消息并重新开启助手输出。图1左半以同一错误推理展示两种干预的差异;图中例子是机制示意,不是单独的成功率实验。
- 4
在预算内替换并报告不同指标
每条需纠正轨迹只续写一次;原前缀加新后缀不得超过8192 token。16个最终候选中的平均正确率 Avg、任一答案正确的 Pass 和门控选单个答案的 GS 必须分开,不能把候选池收益误写成单次问答提升。
实验与证据
已阅读正文、HTML附录A–N及PDF附录O(第27–31页完整轨迹),核对实验条件与原图;未独立复现。
来源证据Base@32 对比 UPTURN@16:平均 Avg 37.1→55.3,Pass 53.5→71.3,GS 52.0→63.0。UPTURN 最多执行16次初始生成加16次纠正。 表1:四个推理模型、六个数学集合 ↗
我的解读这是允许生成次数及长度约束的比较,不代表每条路径实际 token、前缀处理或墙钟完全相同;短预算下完成答案的能力也贡献了提升。
来源证据两次计时均值:Base@32 为931秒,UPTURN为790秒;每题解码token245548→156619。均排除相同的32秒引擎启动。 附录E / 表12:一张 B200、Qwen3-4B、AIME24 ↗
我的解读解码量约降36%,墙钟只降15%;门控、位置编码和依赖的第二阶段抵消部分节省。不能据此声称所有硬件都加速15%。
来源证据空用户回合也有增益,默认文字进一步改善;段落边界只占2–3%位置,覆盖18–35%的高熵位置。预算扩到24K时,两个Qwen3基线追平或略超过UPTURN。 附录G–I:空回合、分岔点与更长预算 ↗
我的解读这支持聊天结构是关键干预,但边界不是覆盖全部有效切点。价值边界是预算受限纠正,而非无限制推理增强。
来源证据正文比较另有新token纠正预算协议,不能与表1原前缀+新后缀总预算混读。附录L的Qwen3-4B低预算Reflexion组合有负向单元,三种子与另外两种模型实验也报告了结果。 附录J–N:纠正基线、组合与种子 ↗
我的解读避免沿用“组合在所有模型必涨”的概括。另补读PDF附录O第27–31页:同一前缀的三种续写,新回合最终答80,另外两条未完成;单个成功案例不能代替表格统计,成功轨迹仍出现错误向量关系与反复尝试。
开放情况与使用许可
已核对论文正文与全部附录(含PDF中的完整轨迹);未发现可确认的官方实现或权重链接,不将论文公开标为代码开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
可把额外推理预算用于选择纠正位置,冻结底座也能改善数学短预算表现;附录明确报告墙钟和预算扩大后优势消失,提供了适用边界。
反方 · 哪些结论还不够
验证集中于可自动判分的数学和科学任务,不能外推到工具使用或开放问答;小头依赖额外编码器。多数模型共享词表体系,跨模型不等于跨架构通用。表1与纠正基线的token协议不同;未独立复现。附录O的单个纠错轨迹包含大量重复尝试,正确结论不等于每一步推导可靠。
综合判断
值得作为短预算推理纠错组件验证,不应宣传为普遍替代更长推理或更大候选池。
我会先做的验证
未执行的验证方案:固定总墙钟、实际token和候选池大小,对比随机切点、学习切点、空回合、默认指令及单纯增大预算;独立测门控错误纠正率和长预算退化。