U-Space:从模型内部追踪疑虑,但不要把疑虑当成错误概率
四条语义轴与预测熵组合;长度控制、白盒成本和代码差异决定如何解读
U-Space把表示歧义、信息缺失、证据冲突与一般疑虑的词语映射回模型隐藏状态,构造四维空间,再把推理结束处的方向信号与整段推理的平均预测熵相乘。它提供可观察的疑虑轨迹,但既不输出校准后的错误概率,也没有证明四种轴是真实错误原因的完备分类。
图解主要方法
如何区分可读出的疑虑、错误排序能力和真正校准的置信度?
- 1
用相反语义词簇指定四种疑虑
从已有研究词表中选不确定与确定词,再分入歧义、缺失、冲突、一般疑虑四类,并按模型分词器丢弃多token词。它定义的是可语言描述的轴,不是从错误标签自动发现的因果分类;不同分词器会留下不同数量的锚点。
- 2
把词表方向拉回中间层,再正交化
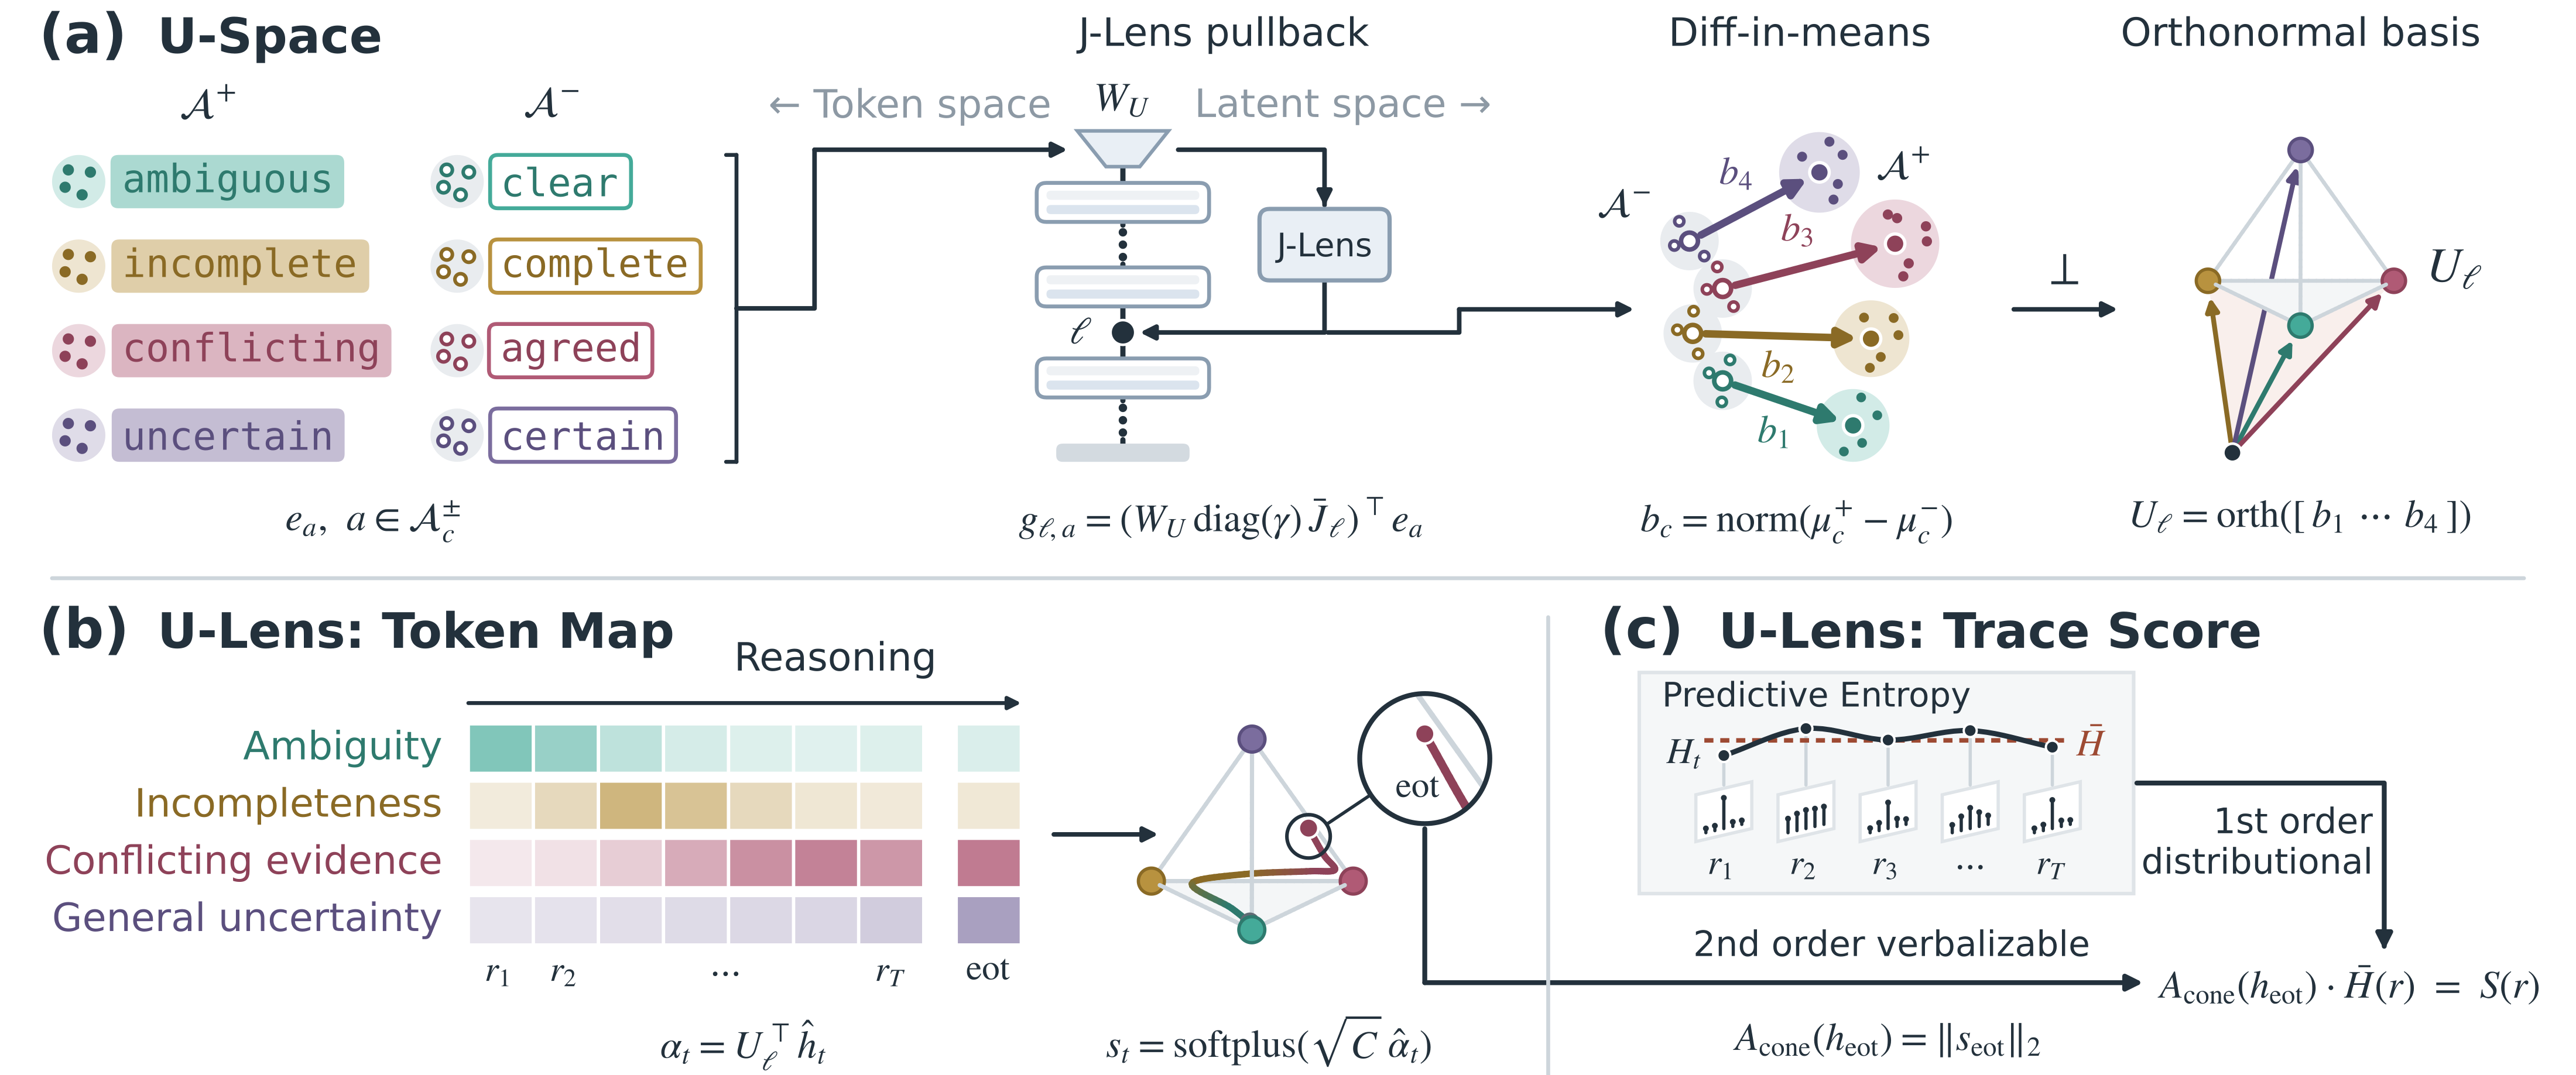
图2a用反嵌入矩阵、最终RMSNorm增益和平均Jacobian,将词语方向映射到残差空间。论文逐锚点归一化、分别求正负簇中心并归一化,再相减得到四个方向,最后对称正交化。正交是算法施加的几何约束,不代表四种心理概念独立;当前代码少了两极中心的单独归一化。
- 3
逐token读方向,保留轨迹而非只看关键词
图2b先投影归一化隐藏状态,再把四维坐标自身归一化,经softplus得到正锥信号。第二次归一化保留方向、抹去投影幅度;彩色轨迹可显示疑虑类别的相对变化,但归一化色块占比不是某种错误发生概率。
- 4
结合推理结束状态与整段预测熵
图2c只在结束思考标记处取正锥向量的范数A_cone,再乘以thinking段的平均预测熵。最终标量用于排序可能错误的回答;它没有概率校准。论文的单次生成不等于实验中没有额外前向记录,公开流程在生成后另有forward步骤收集状态。
实验与证据
正文及附录A–H全文已读;核对图2、公开实现、BSD许可及首发记录。代码核心运算与论文公式发现归一化差异,未运行复现实验。
来源证据Gemma-4-31B-it、Qwen3.5-27B、Magistral-Small-2507;每基准抽1000题,三生成种子41/42/43。MMLU-Pro、Omni-MATH、SuperGPQA、TriviaQA均剔除截断或无法解析输出。 第4节、附录B ↗
我的解读不同模型实际评分数并不总是1000,例如Qwen的Omni-MATH为926、Magistral为932;这种排除可能改变难题分布,不能把指标解释为完整请求流表现。
来源证据长度控制是在每模型/数据集/种子内划分10个输出长度分位箱,箱内计算指标后加权;三模型控制后AUROC为68.4/71.0/68.3。 表1–2、附录B/E ↗
我的解读它削弱长度相关性,但不是逐样本精确匹配或因果干预。表1的±是跨模型标准差,表2是生成种子标准差,两个误差条不能混用。
来源证据附录未控制长度时Magistral组合65.7、A_cone68.5;Gemma组合73.2、TokUR75.1。 附录E,表12及迁移表 ↗
我的解读乘预测熵并非所有模型和评估口径下都更好。部分监督探针同分布成绩更高但跨任务衰退,也不能据此否定所有监督校准。
来源证据H200上的读出增量小于每题0.001秒;Magistral镜头用100条WikiText-103提示估计,已有镜头可下载。 第4节成本、附录A/B ↗
我的解读读出时间不是端到端开销:不包含模型生成、准备Jacobian以及隐藏状态和logits收集。无需优化参数仍需要模型内部访问及前置计算。
来源证据公开核心代码的centroid直接返回已归一化锚点的平均值,basis随后对两个均值的差做unit;论文公式1先对两个均值分别做norm。 公式1;官方src/uspace.py,cce4d263提交 ↗
我的解读这是静态代码与公式对照发现,尚未执行两版本对比。它不证明主表错误,但复现实验应固定提交、明确采用哪一种基底。
来源证据附录用24道题和最长两万计数填充考察A_cone,另以小批提示或50token窗口定向注入疑虑方向。 附录G–H ↗
我的解读填充实验针对A_cone,不能直接证明完整熵乘积分数长度不变;定向注入改变文本态度,不等于提升事实正确率或覆盖部署分布。
开放情况与使用许可
2026-10-11核对官方仓库cce4d2633ed763ba9b33efb11c7099a361209129:含采样、生成、标签、前向、基底构建和评分流程,以及src/uspace.py、src/methods/ulens.py;并非空仓库。仓库提供Magistral镜头数组,Gemma/Qwen镜头运行时下载;模型和数据另受各自条款约束。
LICENSE代码BSD-3-Clause;论文采用arXiv非独占托管许可,不能将代码许可自动套用于论文原图。第三方模型、数据及Jacobian镜头保留各自许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
在三模型、四基准、三种子上,长度控制后的平均AUROC为69.3,原始为71.1;仅长度评分从68.6降至52.4,说明主要收益不能仅用长度解释。
公开实现含实际评分与数据流水线;词语未显式出现在输出中的子集仍有区分能力,支持隐藏状态读出并非简单关键词计数。
反方 · 哪些结论还不够
在未控制长度的Magistral结果中,组合分数AUROC65.7低于单独A_cone的68.5;Gemma的TokUR也优于组合分数,不能泛化为所有条件最优。
论文公式1分别归一化两极中心后相减;所核对版本src/uspace.py的centroid返回原始均值,两极直接相减再归一化。两种算法通常不同,尚未量化其影响。
小样本定向干预说明方向可改变疑虑表达,不证明其能提高答案正确性;按长度分箱也不等于消除所有混杂。
综合判断
值得关注的是把内部疑虑轨迹与长度控制一起研究,并公开了实际实现。当前最可靠定位是白盒分析与错误排序信号,尚不能作为经过校准的安全判定器。
我会先做的验证
建议实验,未执行:在冻结轨迹上比较论文与代码两种中心归一化,统一基线与U-Lens的thinking评分跨度;保留截断样本并分层报告,测AUROC、校准误差和拒答风险—覆盖率,同时分别核算Jacobian准备、前向记录和在线读出的成本。