LLM-as-Policy:Astra 直接选择机器人运动目标的能力与边界
独立评测中的仿真成绩,不等于可靠的真实机器人控制
研究将冻结语言模型放进动作闭环,让它读取图像与机器人状态、输出末端执行器目标,再由非学习式运动模块转成可执行命令。Astra 在 RoboDojo 仿真中明显强于同接口语言模型,但整体成功率仍低,真机试验还因设备损坏提前停止。
图解主要方法
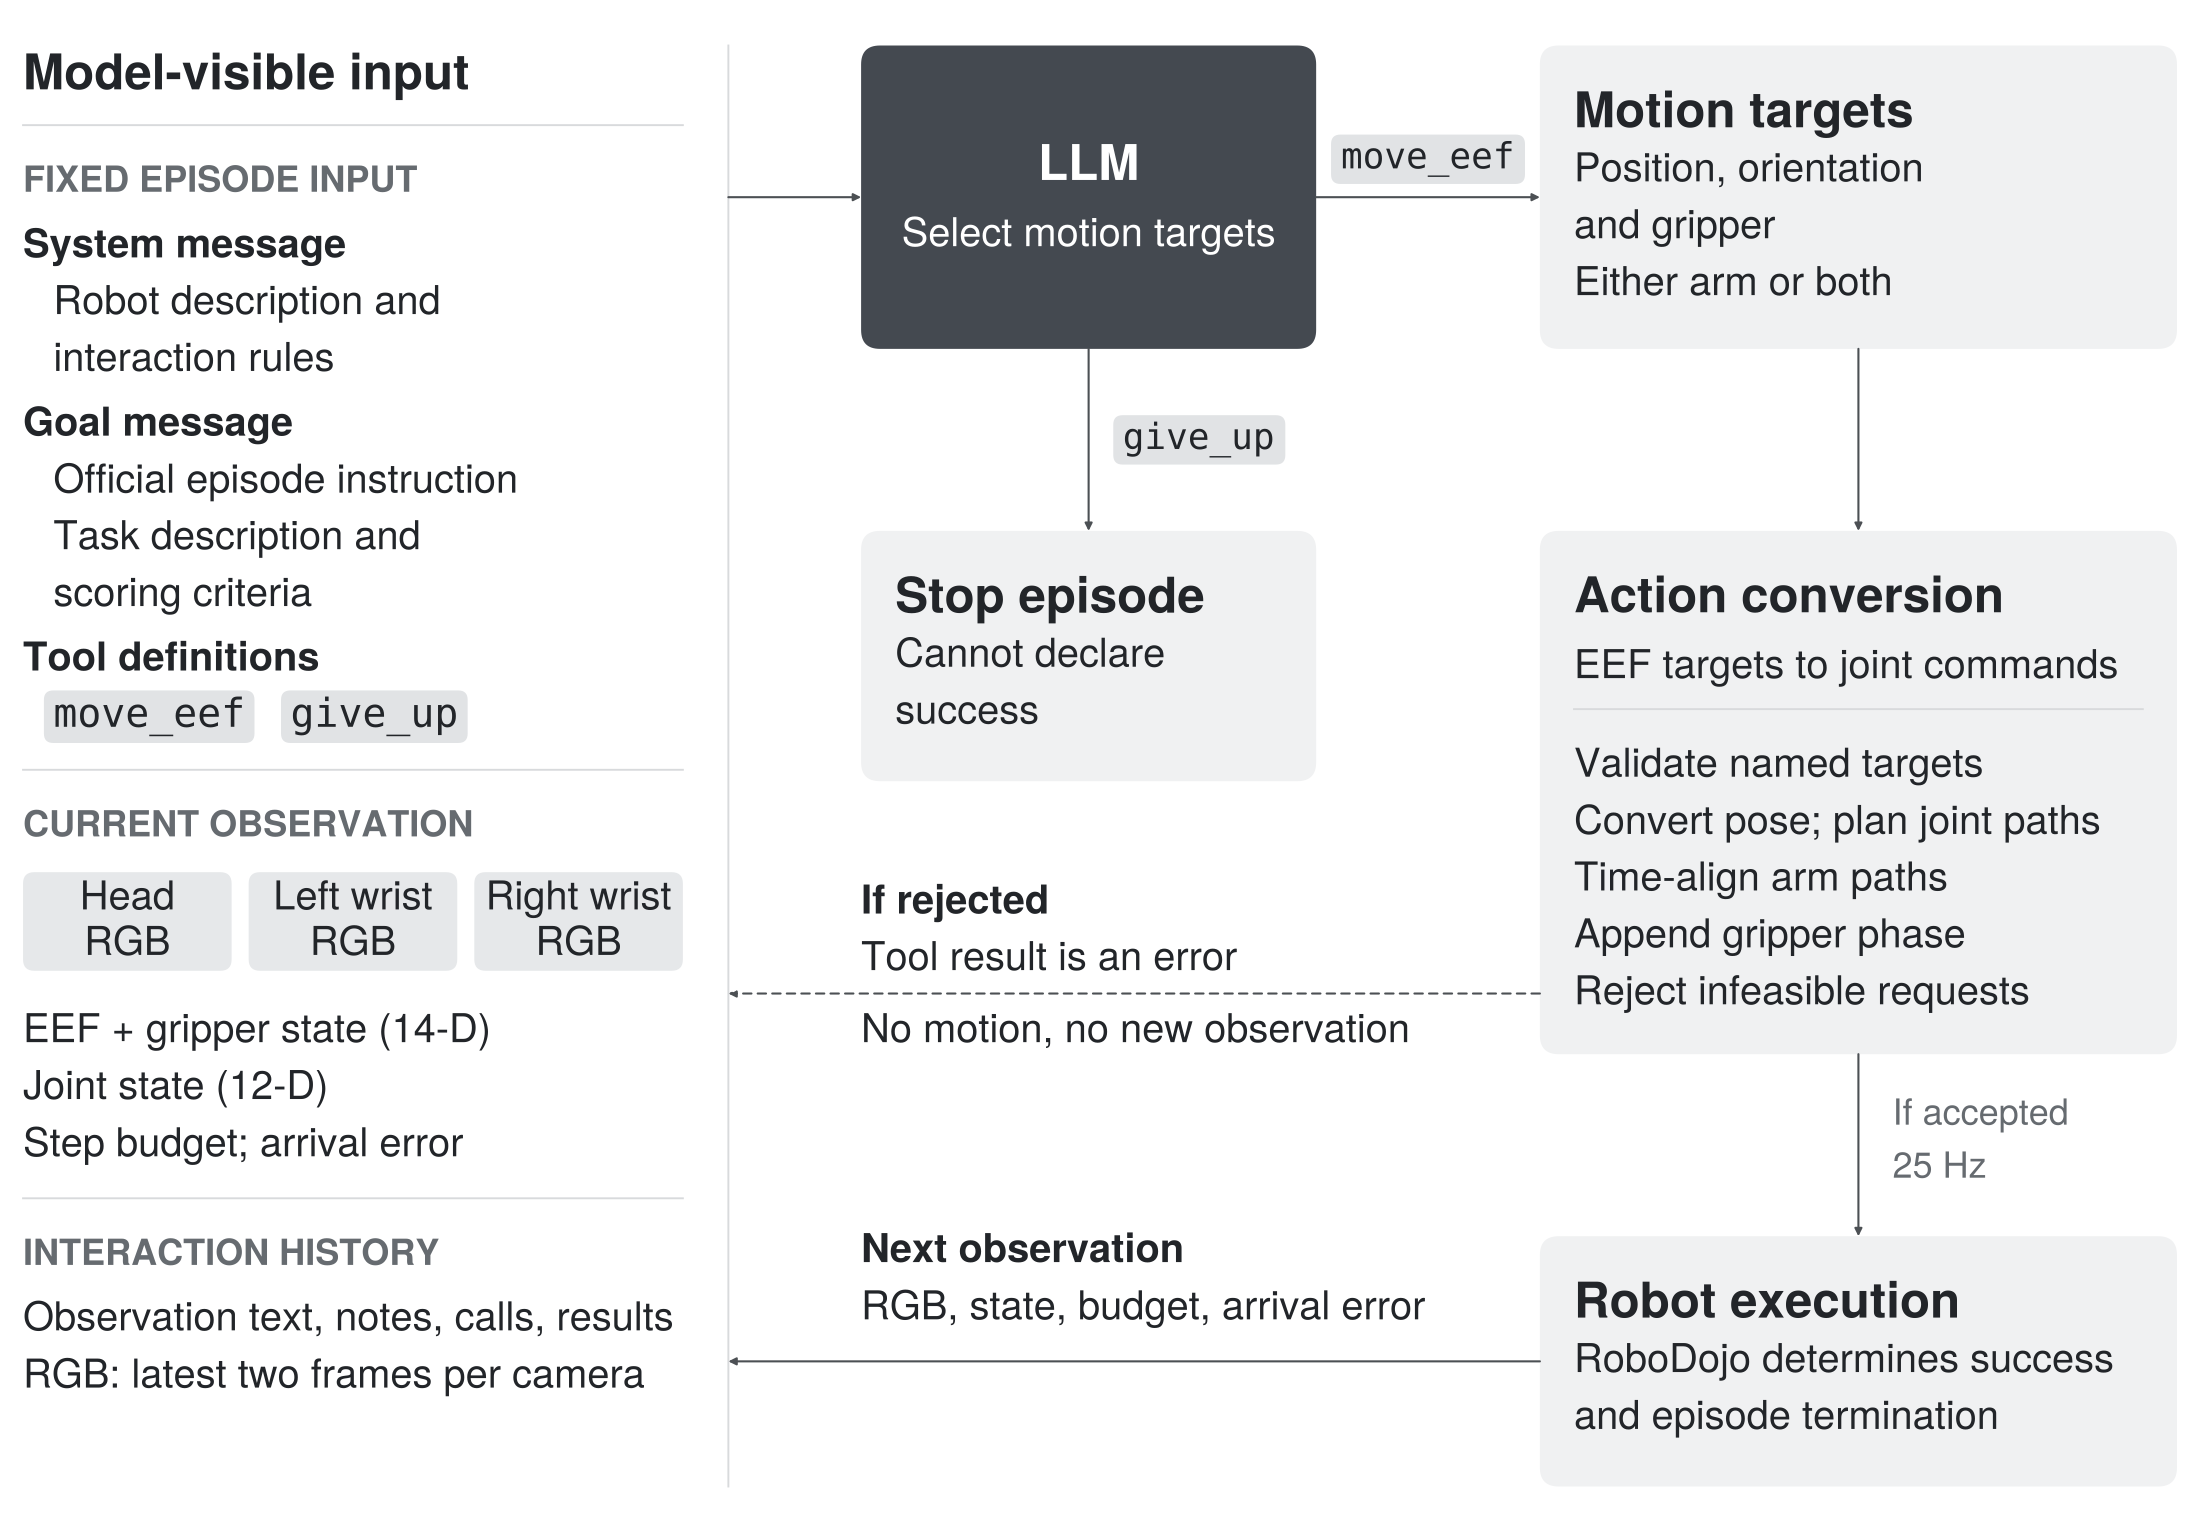
图 2 中由模型做出的决定,与运动转换器和环境判定分别在哪里?
- 1
给冻结模型一个明确的可见接口
左侧包含头部及双腕三路 RGB、每路最近两帧、14D 末端/夹爪状态、12D 只读关节状态及文字历史。任务资料与评分描述帮助解释目标,但不提供深度、物体精确位姿或奖励内部变量;人工任务 recipe 的额外上下文也应作为实验条件披露。
- 2
直接选择末端目标,再经非学习式转换
模型调用 move_eef 给出世界坐标下位置、朝向和夹爪目标,转换器做逆运动学、路径插值、双臂时间对齐及可行性检查。这里没有主实验中的预训练运动策略,但仍有大量非学习式执行支持,不能称模型直接生成电机扭矩。
- 3
按接受或拒绝分支更新闭环
不可执行目标被拒绝时不发生运动,也不产生新观测;可执行目标按 25Hz 命令执行,机械臂阶段结束后处理夹爪,再返回实际到达状态与误差。25Hz 是执行器命令频率,不是语言模型调用频率;give_up 也不能让模型自行宣布成功。
- 4
把仿真协议和探索性真机结果分开
主要评估固定环境布局与模型调用条件;其他排行榜系统来自较早快照,部分任务数量不同。真机、钢琴代码和人形行走属于不同接口或探索设置,不能混成一个统一闭环成绩。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【RoboDojo】Astra/GPT-5.5 使用 42 任务各 50 布局,DeepSeek 为各 10;主要运行单种子。Astra 综合 score/SR 为 28.97/22.48,对照 DM0.5 为 24.90/19.34。 仿真主表与协议 ↗
我的解读我的解读:相同语言模型接口的差距值得研究,但对历史榜单的比较不是全部系统在同一 42 任务、同种子重跑;22.48% SR 仍意味着大部分失败。
来源证据【能力分布与上下文】Astra 精密任务 SR 约 4%,长程任务约 8.25%;340 配对样本的一次示范条件由 22.9% 降至 17.9% 或 12.9%。 任务分项及示范消融 ↗
我的解读我的解读:通用推理优势没有自动转成精密操作。此处 ICL 退步依赖具体示范表示,不能推广成“机器人示范无用”。
来源证据【真机与稳健性】探索真机共 33 次、12 类任务,仅一次成功,因设备损坏停止;扰动布局先筛选成功条件,且无完整历史消融。 真机观察与布局扰动附录 ↗
我的解读我的解读:这些真机数据不是正式可靠性估计,却明确反驳了直接把仿真榜单当落地能力。扰动结果也受筛选条件限制。
开放情况与使用许可
09-21 首发,属于独立机器人评测而非模型厂商技术报告。RoboProbe 仓库有控制接口、结果与测试代码;评估还需外部仿真环境和模型服务,不包含 Astra 模型权重。
LICENSE当前 LICENSE 为 Apache-2.0,但 README 明示正式 release license 尚待冻结;第三方环境另有许可。论文原图版权归作者,不把代码许可套用到图片。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
公开末端目标接口及失败反馈回路,使语言模型的空间决策可以被独立拆解和复核。
反方 · 哪些结论还不够
任务上下文、非学习式运动支持和仿真条件是关键组成;低精密/长程成功率及真机损坏不支持无人监督部署。
综合判断
应作为直接空间决策能力的研究基线,先在仿真与受限运动接口中定位失败,再讨论真实操作适用范围。
我会先做的验证
未执行的验证方案:固定提示、任务资料、调用预算及运动转换器,在相同 42 任务布局上配对多次运行;逐项消融 recipe、历史和状态输入,分别报告拒绝目标、碰撞、任务成功与物理损坏,真机设置严格的力和工作空间限幅。