UCoE:让评分程序与代理记忆一起更新
开放任务没有标准答案时,怎样检查负责指导改稿的验证器?
UCoE固定模型权重,让可执行评分规则与短程序记忆随任务流演化。它用局部退化的回答对筛选验证器,只接受通过比较的新评分程序,再由程序指导一次修订。论文重点是验证器的行为测试,而非模型训练;局部对比集的可靠性仍决定其边界。
图解主要方法
开放任务没有标准答案时,怎样检查负责指导改稿的验证器?
- 1
建立局部对比与显式评分程序
从独立开发集的匿名回答对发现反复出现的质量要求,再对校准回答做遗漏、无依据主张或无关插入等单属性编辑。候选程序包含有锚点的语义评分项与有界聚合表达式;静态检查只证明能运行,不证明判断正确。
- 2
按最弱类别选择验证器
每类对比计算严格超过0.01边际的正确排序率p,取J=2p−1,再最大化最弱类别J;同分不算成功。driving capacity为最小J的四分之一。理论针对固定对比分布,不担保自然修订或尚未覆盖错误。
- 3
一次局部修订,再决定是否记忆
验证器选择草稿中最弱的相关评分项,给出局部证据与修复指令,演员只改一次;奖励提高超过边际才采用。回答返回后,接受的修订最多提炼一条通用程序,记忆总计12条,每次取最多2条,不带入当前任务答案。
- 4
在检查点审核评分规则更新
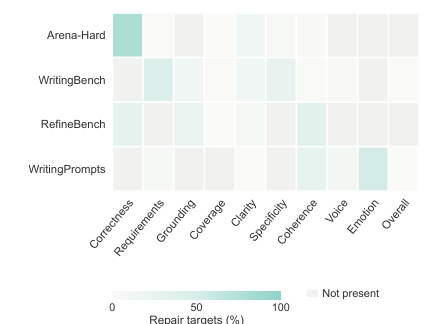
新候选由已完成任务诊断产生,必须提高选择集最弱项、在独立对比上赢多于输,且各类中心准确率下降不超过0.10。后者仍允许成功率下降5个百分点,不能描述成更新永不退化。图4a显示不同任务的修复目标分布。
实验与证据
已阅读正文1–6及附录A–E全部子节、理论证明、完整程序与成功/失败案例,核对实验条件与原图;未独立复现。
来源证据8B与27B演员平均偏好59.00%、57.19%,50%为持平;27B MultiChallenge 51.95%的95%区间为49.80–54.30。 表1、11:六基准,双顺序模型评审 ↗
我的解读偏好不是任务准确率,12组中有一组区间包含持平。最终裁判与部分关系发现使用同一模型家族,需要独立评审。
来源证据三项客观任务均值36.06→38.48,代码Pass@1保持21.62;Arena-Hard仅更新记忆50.8,完整58.3,无记忆56.7。 表2–3:客观端点与消融 ↗
我的解读主要收益来自当前修订,代码任务没有提升;基线均被适配为一次修订,不是复现其原有训练流程后的全面对比。
来源证据按标价估算每任务0.0142美元,较简单基线多2.2–2.8倍,不含最终评测;8B接受158份修订中99更好、33更差、26相同。 附录E.2、E.6:费用与独立Critic审计 ↗
我的解读免训练仍有额外推理成本;接受门槛会误收坏修改,也拒绝132份Critic认为更好的修订,不能替代外部质量验收。
来源证据75个表格任务精确匹配22.7%对17.3%;失败案例把正确推导删成答案,验证器却大幅加分。公开程序检查聚合表达式的有限探针。 附录D.8、E.7:代理迁移和失败案例 ↗
我的解读约4题差距的有限样本不能证明普遍代理提升;有限数值探针不等于所有输入下的有界证明,错误判断还可能污染长期记忆。
开放情况与使用许可
已核查官方仓库含src、配置、评测和测试,并读取实际验证器源文件;代码MIT,论文CC BY 4.0。所用模型和外部基准遵循各自条款,API模型不因此开放。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把验证器显式化并用独立来源的受控对比测试,比只用一句“请自我反思”更容易定位质量退化原因。
反方 · 哪些结论还不够
对比偏好方向本身是假设,删除高信息密度句不一定仅破坏一种属性;评分、接受和记忆由同一验证器控制,可能同源偏差。理论只覆盖固定已测分布,有限配额的置信界未用于实际接受。
综合判断
适合研究可审计的修订流程,价值在验证器测试与失败记录;不能把对比集改善写成开放任务自我验证已解决。
我会先做的验证
未执行的验证方案:用独立人工审查校准编辑是否只改变目标属性;等费用比较多样本选择,固定自然修订集测误收率,并在任务分布切换后测记忆污染与回滚收益。