UniWALM:让机器人把自己说过的话当记忆
语言、动作共同去噪之后,怎样防止“记得正确、执行错了”?
UniWALM 在视频骨干上增加从零训练的语言与动作专家,同步生成子任务、文本记忆和动作,并把文本带入下一次控制。真实找物任务中取得11/18成功,但记忆与执行的边界仍会出错;作者的按键案例表明,正确文字计数并不能保证正确物理次数。
图解主要方法
语言、动作共同去噪之后,怎样防止“记得正确、执行错了”?
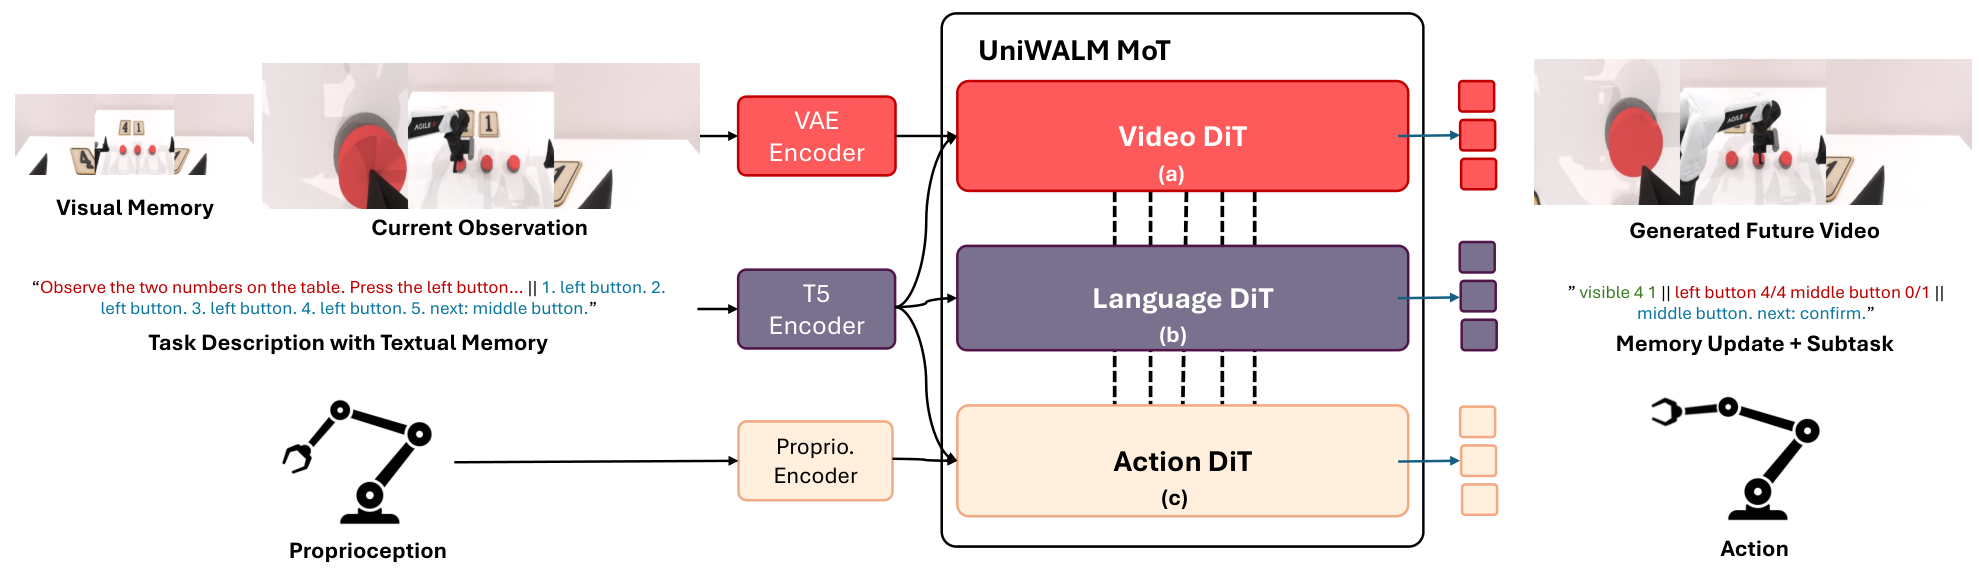
- 1
1 · 用共享注意力融合三条流
图2的video、language、action DiT在每层共享自注意力,再交叉注意任务和本体状态。视频骨干来自Wan2.2,动作约1B、语言约0.5B从零训练;视觉预训练仍然存在,不能表述为完全无预训练。
- 2
2 · 同步生成并回读文本
语言采用离散扩散,输出64token的子任务与记忆字符串,下一控制步重新作为提示。训练联合视频/动作flow损失与文本交叉熵;推理关闭未来视频生成,让语言与动作同步采样,避免独立AR规划阶段。
- 3
3 · 在需要时加入锚帧和完成门控
RMBench使用起始锚帧,RoPE坐标偏移避免与当前图像混淆;动作向量中的完成通道β在子任务结束时触发文本记忆更新。真实Find-the-Item及MolmoSpaces没有锚帧或β,因此各实验不能混用输入条件。
- 4
4 · 对动作去噪路径做局部纠偏
FMC将干净动作加扰动,再构造在Δt内回到原轨迹的速度目标,修正项为(1−t)ε₁/Δt,仅在t≥0.5分支施加。推理步数不增加,但这只训练局部动作扰动恢复,不是对真实机器人失败自动做DAgger。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据MolmoSpaces每任务1000个OOD场景,三项Pick&Place平均比FastWAM高约14.8个百分点;38K单任务消融31.0→语言35.9→FMC38.9→LoRA41.0。 表1、4 · 操作与组件归因 ↗
我的解读主结果含语言、纠偏和LoRA共同变化;只有逐项消融能辅助归因。短程Pick与随机相机Pick仍落后MolmoBot。
来源证据真实找物18次为61.1%(95%CI39.6–82.6),FastWAM11.1%;RMBench四任务各100次,平均34.5%,Mem-0带关键帧28.5%,WLA-0为56.5%。按键完整模型30K训练18%、100K为51%。 表2、3、5 · 记忆评估 ↗
我的解读小硬件样本区间很宽,不能称超过所有记忆系统;30K与100K结果也不能只归因架构。
来源证据附录出现β晚触发导致实际多按一次;动作块32、10去噪步时123ms,无语言76ms,而主评估配置另列20步。FMC算法示例s=0.2,附录所称主配置s=0.4。 附录B.5、B.6及速度说明 ↗
我的解读执行边界和配置差异都值得复现核对;不能把10步测速直接宣称为20步评估速度。
开放情况与使用许可
官方页提供论文及演示,未核得训练代码或权重下载。论文/原图为CC BY-NC-ND 4.0,完整原图保留;不能将论文可读等同于模型开源或商用授权。
LICENSE论文与原图 CC BY-NC-ND 4.0;实现与权重未核得
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
文本作为持续任务状态是可审计的控制接口,统一生成提供了比每步独立推理更明确的记忆实验。
反方 · 哪些结论还不够
真实任务仅58次总试验;锚帧、训练长度和语言机制共同影响结果。泛化数据主要同域,复杂抓取仍失败,文本意图可能与动作脱节;FMC尺度描述还需配置确认。
综合判断
支持“生成文本能帮助记忆”的有限结论,不证明语言记录是可靠的执行日志或安全保证。
我会先做的验证
未执行的验证方案:对同一检查点分别清空、打乱、延迟文本记忆,在等训练预算下检验因果贡献;逐帧对齐β、物理按键事件与文字计数,测长任务记忆错误累积。