UFM:多走几步真的能推理吗?关键在于训练整段隐空间轨迹
小型流模型的推理步数扩展;理论构造、实际训练与测试集选择需分开看
传统流匹配在随机噪声时刻训练单次去噪,未必教会后一步利用前一步。UFM从自己的隐状态轨迹反向传播,只在终点预测答案;长轨迹通过球面回缩控制尺度。它在图可达、数独与迷宫上显示更多积分步可带来收益,但尚未验证开放语言任务。
图解主要方法
重复使用同一个网络,怎样从更多计算变成更多有效推理?
- 1
将答案槽留在连续隐空间中反复更新
保持提示干净,只让答案位置的噪声状态变化;DiT预测隐空间终点,再按Euler系数更新。中间步骤不映射成词表概率,仅在最终状态用词表解码器监督,避免每步都被独立的一次去噪目标支配。
- 2
在训练中展开模型自己产生的轨迹
从随机起始时刻的噪声—答案嵌入混合开始,沿随机递增时间网格展开,最终只计算一次答案交叉熵。ProsQA展开五步并反传全部;长任务展开24步,只通过最后六步反传以节省显存。推理从纯噪声t=0开始,不能把训练答案提示当成推理输入。
- 3
用球面回缩稳定更新基底
数独和迷宫从第二步起,将更新的基底缩到半径sqrt(d);网络仍读取原始状态,最终一步直接输出预测终点。不是把所有隐状态始终锁在球面上,局部切空间分析也不证明t=1端点的整体收敛。
- 4
区分深度扩展与多轨迹选择
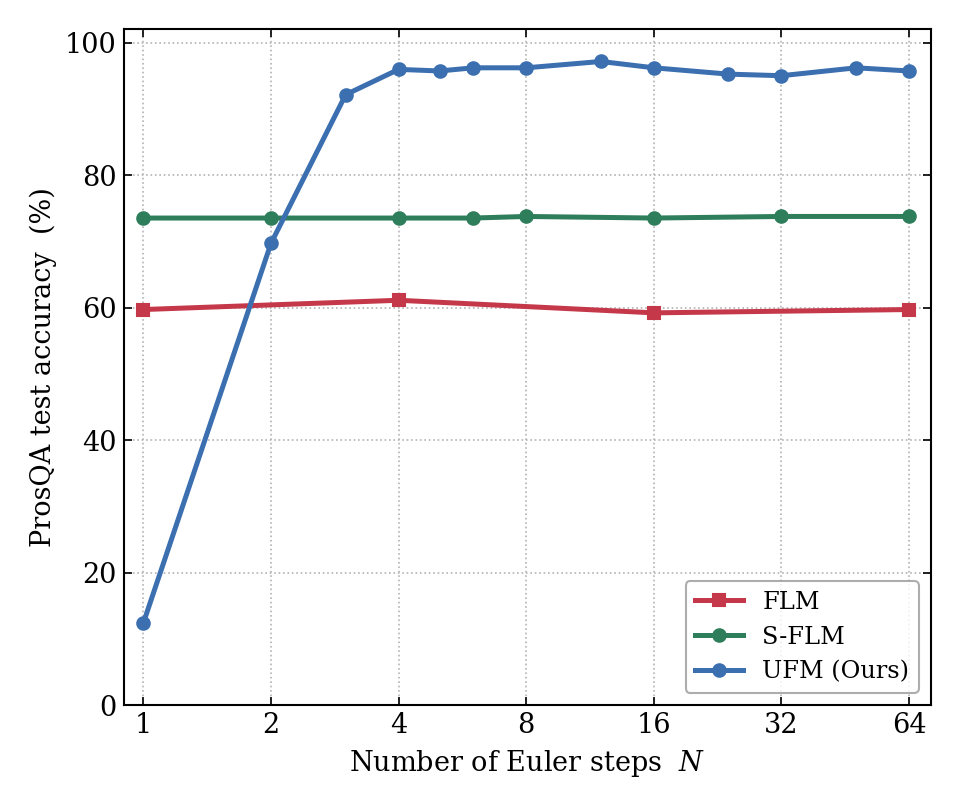
图2显示增大Euler步骤能使UFM学到的更新累积作用,随后约95–97%饱和,并非单调无限增长。另可生成100条轨迹,以各位置最大与次大logit差的均值选一条;长迷宫答案中大量非路径格子稀释分数,选优仍可能错过正确候选。
实验与证据
完整阅读23页对应正文及附录A–D、构造证明、采样算法和复现协议;检查官方实际代码、许可和原图。
来源证据理论构造先缓存有向边,再用线性注意力实现邻接算子;Euler N步只覆盖最远N跳,连续精确流在任意正时间已含所有可达节点的非零系数。 定理1、推论2、附录A ↗
我的解读“一步一跳”属于离散化支持范围,不是连续流本身的时间门槛;需正交词嵌入和固定最大图规模,且没有训练收敛保证。
来源证据ProsQA只保留答案距根不超过四跳:训练14785、验证257、测试419题。UFM约440万训练样本×五次展开,基线约2230万样本。 图2–3、附录D.2 ↗
我的解读按网络求值次数近似匹配,批量和架构并不完全相同;中间logit图支持类似可达集合的现象,却不证明训练模型实现了构造算法。
来源证据Sudoku-Hard48k训练、2k报告,UFM另用2k验证;主比较A100训练1.14小时约19.7k步,基线选30k步约1.61/1.68小时。 表1、表6、附录D.4–D.6 ↗
我的解读时间只计训练并按稳态速率估算,不含评估;基线在报告集选最佳检查点而UFM用独立验证,此差异反而有利基线。22小时UFM达99.8%是另一个预算,不能混入主表。
来源证据Sudoku-Extreme422786题单轨迹74.4±0.0%,Maze-Hard1000题89.3±0.5%;主检查点关闭DiT时间输入,时间仍进入更新系数。 表3、附录D.5、官方README ↗
我的解读±0.0是四舍五入后的噪声种子标准差,不代表训练完全确定。迷宫没有独立验证集,最佳测试结果须保留选择偏差说明。
来源证据在不同于主表的恒定学习率消融中,64步数独测试有回缩67%、无回缩55%;252步诊断中后者原始范数增至初值约44000倍。 附录B ↗
我的解读这验证回缩与稳定性有关,但两个模型分别训练且配方不同,不能把12个百分点直接解释成主表全部收益;原始状态范数仍可变化。
来源证据100轨迹选择:数独2000题子集Pass@100为98.65%、选中98.6%;迷宫Pass@100为95.0%、选中92.0%。 表5、附录D.1 ↗
我的解读正确候选存在与系统最终选对必须分开。额外128×100网络步骤的成本不能与单轨迹混为一谈;迷宫900格平均margin对关键路径差异不敏感。
开放情况与使用许可
官方仓库98336a53b789900b3c2142634c525a0a5e3613f1包含训练、评估、数据构建、ProsQA及多轨迹选择代码;README标为持续整理。未在所检查目录和说明中发现论文预训练检查点下载。
LICENSE论文原图CC BY 4.0;代码主体MIT,部分来源于S-FLM/HRM的文件保留Apache-2.0声明;数据需遵守各来源条款。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同为约15.7M两层模型,ProsQA的UFM由一步约12%提高到长轨迹约97%,两种流基线基本不随步数增长。
Sudoku-Hard中8.4M UFM为86.9±0.9%,28.6M FLM/S-FLM为51.9%/50.9%;同一数据下显示终点轨迹训练的实际价值。
反方 · 哪些结论还不够
主表±是固定检查点五个推理噪声种子的波动,官方README明确所有论文结果只有一个训练种子。
Maze-Hard所有比较方法均用测试集选择检查点;同样协议不消除测试选择偏差。
数独100轨迹选优98.6%只在2000题子集测量,而单轨迹74.4%覆盖422786题;两数不能当作同样预算同样测试集的直接提升。
综合判断
它提供了一个可复现的研究方向:用终点监督训练协作的隐状态更新。当前更适合看作推理机制实验,不能宣称已替代自回归大模型或实现无限步数的持续收益。
我会先做的验证
建议实验,未执行:用独立迷宫验证集、多训练种子和相同端到端算力预算,分别消融终点损失、回缩、截断反传和采样选择;再测超出训练图深度与非结构化语言任务,检查步数增加后何时饱和或退化。