Value as Memory:让机器人记住“刚才进行到哪一步”
历史价值预测帮助区分外观相似、进度不同的操作状态。
一张图像未必能区分机器人正在开始任务、重试还是从失败中恢复。VaM 将过去价值网络的进度估计压缩成策略记忆,并通过在线数据和历史人工介入持续训练。三类真实操作显示明显收益,但其记忆有效性依赖价值估计,训练也并非全程无人。
图解主要方法
历史价值预测帮助区分外观相似、进度不同的操作状态。
- 1
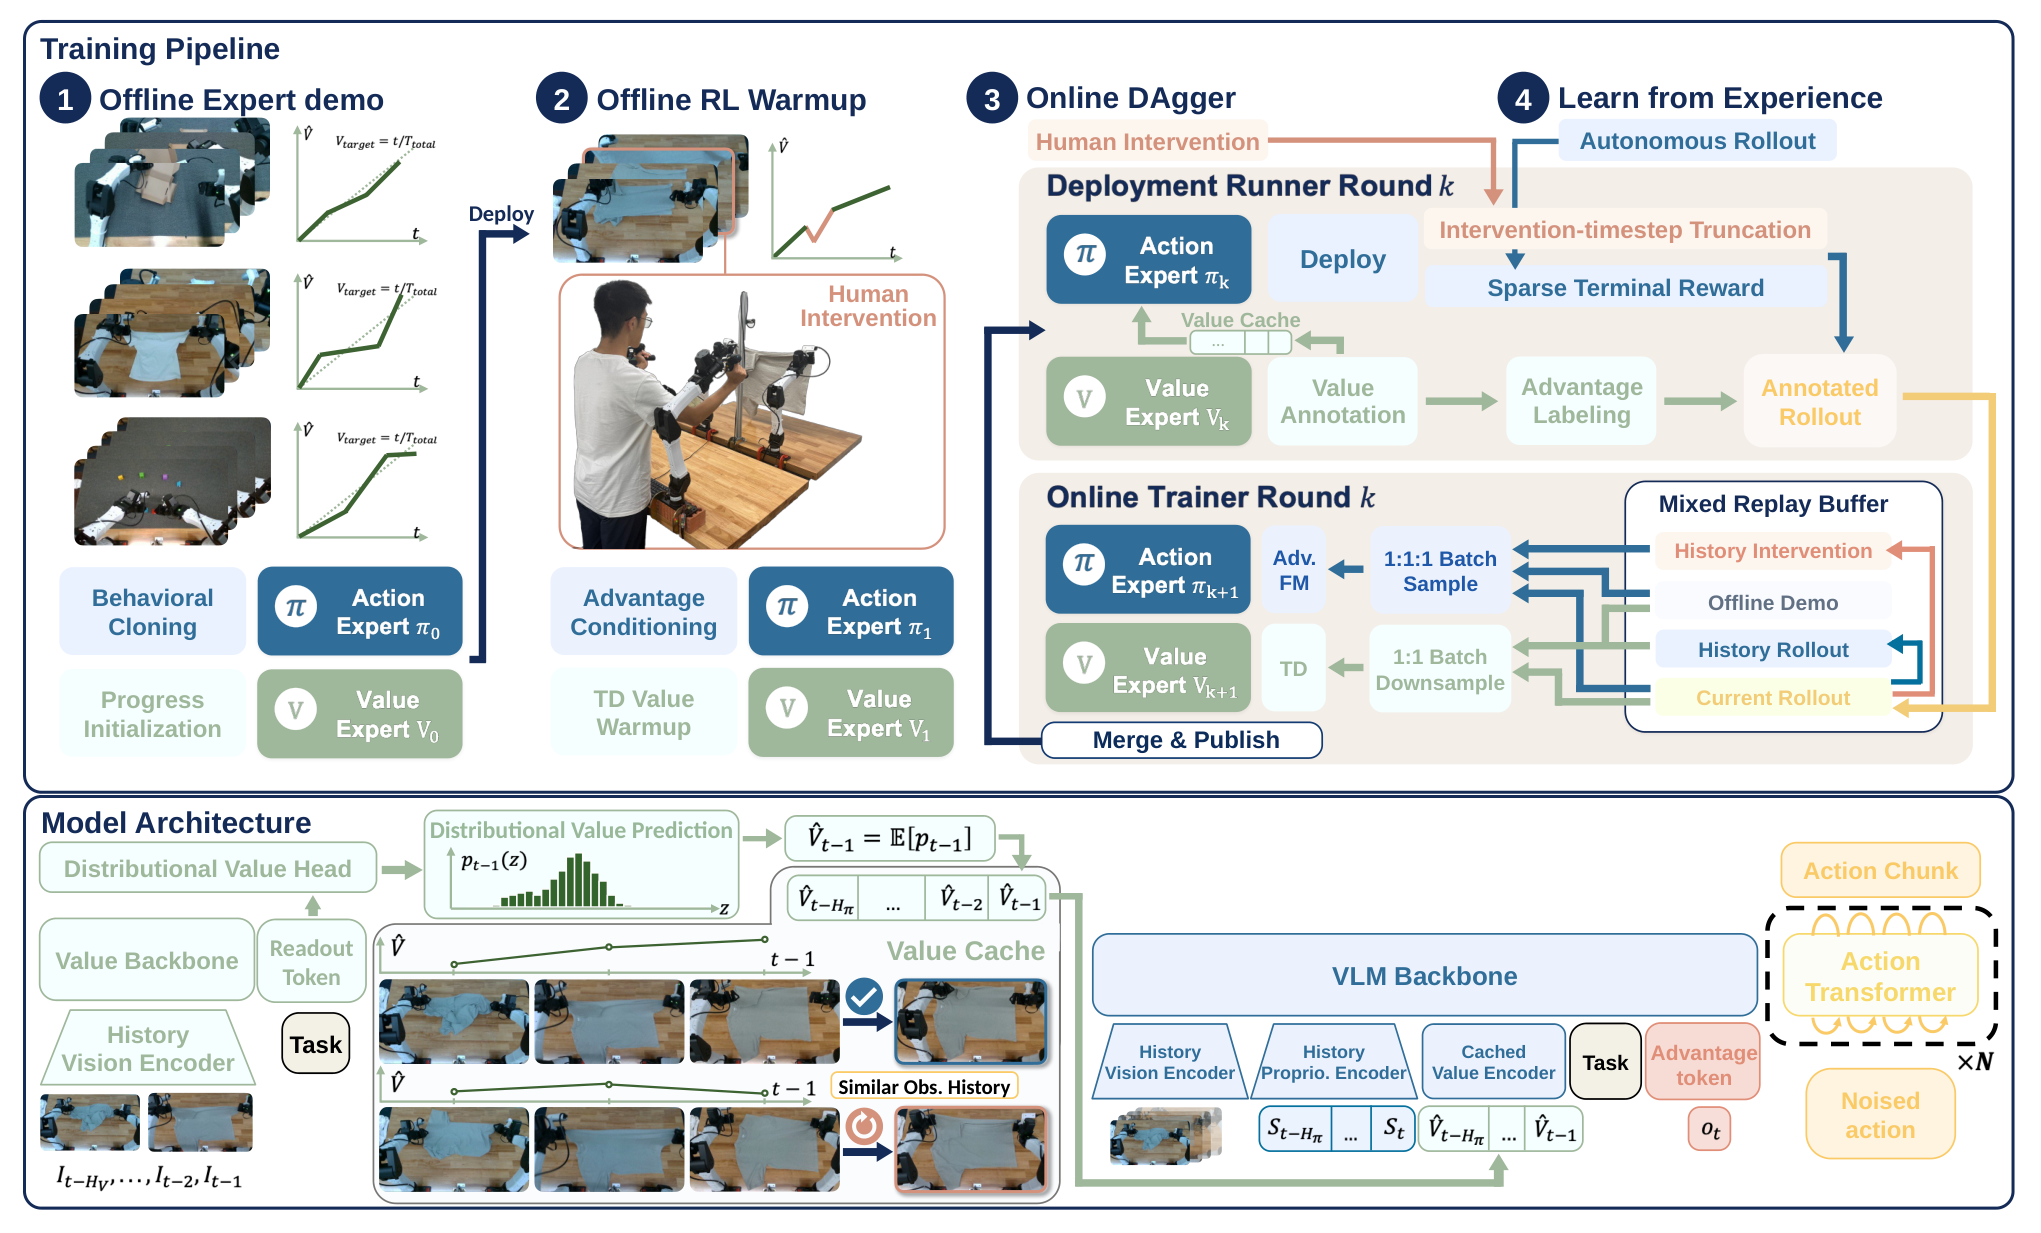
图2:先建立动作与进度估计
用成功示范行为克隆初始化策略,以归一化时间 t/T 的高斯分布监督价值网络,价值输出为[0,1]上256个离散原子。示范进度是初始化代理信号,不应等同所有状态的真实成功概率。
- 2
把失败和人工恢复同时保存
热启动收集 rollout 与人工接管。接管前缀以零终止,完整轨迹保留恢复后的稀疏结果;相似观测可能同时对应失败和恢复目标,分布式价值有助于表示这种混合。之后无新增接管的 LfE 阶段仍保留历史人工数据。
- 3
只把过去的价值送入策略
策略读取前一轮价值模型产生的历史缓存,经 GRU 与本体状态融合。异步预测使当前时刻价值尚未可用,因此使用 t-H 到 t-1;策略历史长度4,价值图像历史2、步距30,100Hz控制、100步动作块。这里没有访问未来观测。
- 4
动作与价值并行更新
价值回放按示范及历史数据与新数据1:1混合,动作按示范、历史介入、当前数据1:1:1混合;二值优势按70百分位划分,并用引导强度控制动作生成。论文给出减少状态混叠的条件性距离分析,不是对神经网络最优策略收敛的证明。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据盒子、衣物、公交模型操作的 VaM 成功率为96.7±2.9、88.9±10.2、76.7±5.8%,无缓存为81.7±2.9、48.9±30.1、43.3±5.8%。均值和波动来自末3个检查点。 表1:三项真实任务 ↗
我的解读平均提高29.4个百分点,但检查点并非独立训练种子。任务限时分别120、240、300秒,不能忽略其执行条件。
来源证据衣物恢复38/44对30/51,公交模型5/15对2/27;盒子24/44对35/70。采用盲标注,但分母是遭遇的恢复事件。 恢复事件分析 ↗
我的解读事件不是独立完整任务,策略不同也改变遭遇失败的难度;不能把这些比值直接当成统一随机化恢复试验。
来源证据匹配梯度和数据预算的在线方案平均高约32.8个百分点;报告并行流程用时低57.8%,盒子约6.514小时降至2.516小时。 效率与训练消融 ↗
我的解读加速来自更新并行和迭代组织,不是样本效率提高8倍。实验使用200/90/30条示范及100/50/40条热启动 rollout,仍有明显前期监督。
开放情况与使用许可
作者 Virlus/vam 仓库已包含训练、部署和历史编码代码,根许可 Apache-2.0;比论文所述“将发布”更进一步。本次未确认三项任务的完整训练数据和最终策略权重可下载,代码开放不等于全链路可复现。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
冻结动作策略后替换价值历史仍影响表现,支持记忆信息本身发挥作用;真实任务和恢复分析也比仅仿真成功率更接近操作系统问题。
反方 · 哪些结论还不够
仅一套双臂平台的三类任务;价值网络若把停滞当进展,缓存可能放大误判。人工热启动与历史介入仍重要,末检查点误差无法量化跨训练随机性的可靠性。
综合判断
值得尝试作为长程动作策略的轻量进度记忆,但应与视频历史、显式阶段状态和独立训练重复比较,不能称作已经解决通用自主恢复。
我会先做的验证
未执行的验证方案:在相同示范、接管和计算预算下,比较价值缓存、等参数视觉 GRU 和人工阶段标签;注入价值偏置及延迟,报告完整任务成功率、独立种子区间和单位人工分钟收益。