VersaCamVLA:换相机时,让策略仍读同样大小的场景表示
固定的辅助token接口缓解视角变化,仍依赖标定与原生视觉输入
VersaCamVLA把数量可变、带内外参的RGB视图压成固定场景token,再作为π0.5的辅助视觉条件。训练时利用腕部相机运动和目标视图的RGB、语义、边缘监督学习表示;部署时丢弃渲染解码器。主要收益出现在改变相机位姿的测试,不能推成对任意未标定相机通用。
图解主要方法
不重训策略就增减相机,稳定接口需要保留哪些几何与原生视觉条件?
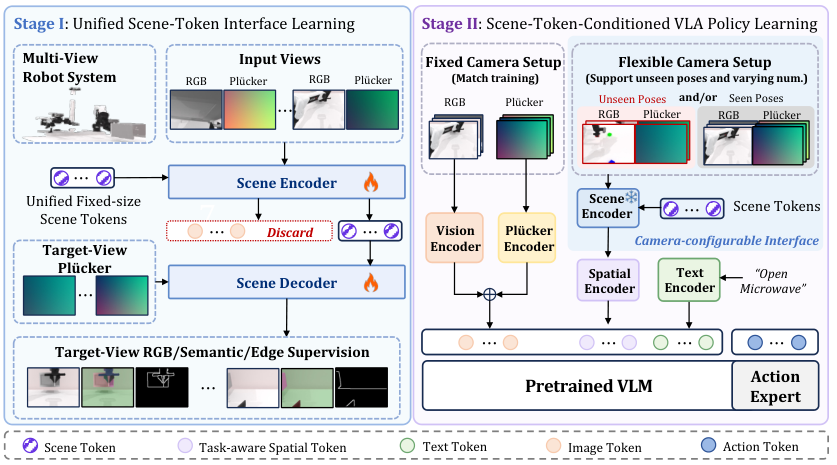
- 1
把像素和相机射线一起编码
每幅224×224图像按8×8切块;RGB与六维Plücker射线合成9通道输入。数量随相机变化的源token与3072个可学习场景token共同经过Transformer,只保留固定场景输出。固定的是输出长度,前端输入计算仍会随视图数增加。
- 2
用腕部运动形成不同源视图子集
每帧随机选至少一个静态视图,每个腕部视图以0.5概率加入源集合;目标仍包括该帧全部可用视图。这样既重建已见视图,也预测未输入视图,并借腕部自然运动获得位姿多样性,而非额外合成机器人动作演示。
- 3
用三个目标训练场景接口
图2左侧训练专用解码器接收目标相机射线,预测RGB、语义及Canny边缘。仿真语义来自分割传感器,实机来自在机器人数据上微调的SAM3;这些监督并非部署时额外获得的真实深度。
- 4
压到192个辅助token再学动作
第二阶段冻结场景编码器、移除解码器与预测头,卷积把3072 token压到192。辅助token与π0.5原生图像、语言、本体感知共同预测50步动作块;灵活相机入口与基础策略的固定视觉入口同时存在。
实验与证据
阅读全文与附录A–C,核对相机数、标定噪声、逐任务回退、真实机器人样本量与效率条件。
来源证据RoboTwin选择16个精细任务,每任务50条Clean演示、每设置100次试验;三视图Clean52.56%、DR23.00%,π0.5分别35.88%、21.63%。 表1、附录A.1 ↗
我的解读主要Clean收益不能直接当作相同幅度的外观随机化收益;逐任务退步说明需要按目标任务验收。
来源证据四视图测试按方位±90°、距离0.8–1.2倍、俯仰25°–75°扰动相机,并仍朝向工作区中心;两方法共享试验相机配置。 表3、12、13与附录C.5 ↗
我的解读大位姿变化表现稳定有意义,但不是任意朝向、完全看不到物体时仍可工作。高斯标定噪声每回合固定,也不代表动态漂移。
来源证据实机三任务每条件20条测试轨迹;四视图已见/未见位姿平均53.33%/58.33%,五视图65.00%。附录训练为每任务50条演示。 表15、16与附录A.3 ↗
我的解读主文“20 trajectories”容易与训练量混淆;这里按附录区分训练50、测试20。增加视图有帮助,但插试管五视图也只有45%。
来源证据单4090、batch 1,四视图231.20ms对π0.5的230.93ms;四增到六视图分别增加7.06ms和29.47ms。 附录B.8、图5 ↗
我的解读策略侧token固定降低增量成本,并非总成本不随相机数变化。此处是推理延迟测量,不能补足五六视图基线的任务成功率缺项。
开放情况与使用许可
官方仓库提交403f8d052535c4944a2e01dd51e2cec504adc974仅README与三个演示GIF;README写明实现即将发布,未发现模型权重或代码许可。
LICENSE论文arXiv非独占托管许可;仓库当前没有代码许可文件,不把公开演示等同于开源实现。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
匹配四视图时,RoboTwin相机扰动后π0.5由48.88%降至32.88%,VersaCamVLA由53.44%变为52.63%。
同一策略可测试3–6视图,成功率52.56%–55.63%;WAPS消融的未见位姿得分由48.79%升到52.63%。
反方 · 哪些结论还不够
三视图域随机化均值只从21.63%升到23.00%,Stack Blocks Three却由50%降至3%;标准LIBERO95.9%与基线95.8%基本相当。
摘要的任意相机表述应限定为辅助通道、已标定且仍有足够可见信息;五六视图的成功率表没有对应π0.5基线。
综合判断
固定接口与腕部视角采样的设计值得关注,论文较有力地支持受测视角变化下的鲁棒性;全配置通用、无标定或原生相机可任意移除并未得到验证。
我会先做的验证
建议实验,未执行:固定策略,在同一初始场景依次移除辅助相机、原生相机,并增加不同步和时间漂移;分别统计完整成功、碰撞、逐任务回退及不同相机数的端到端P95延迟。