VioLA:让人类动作直接监督人形机器人的身体与手部潜在动作
冻结控制器承担关节协调,任务策略学选动作;零样本不等于未见任务类型
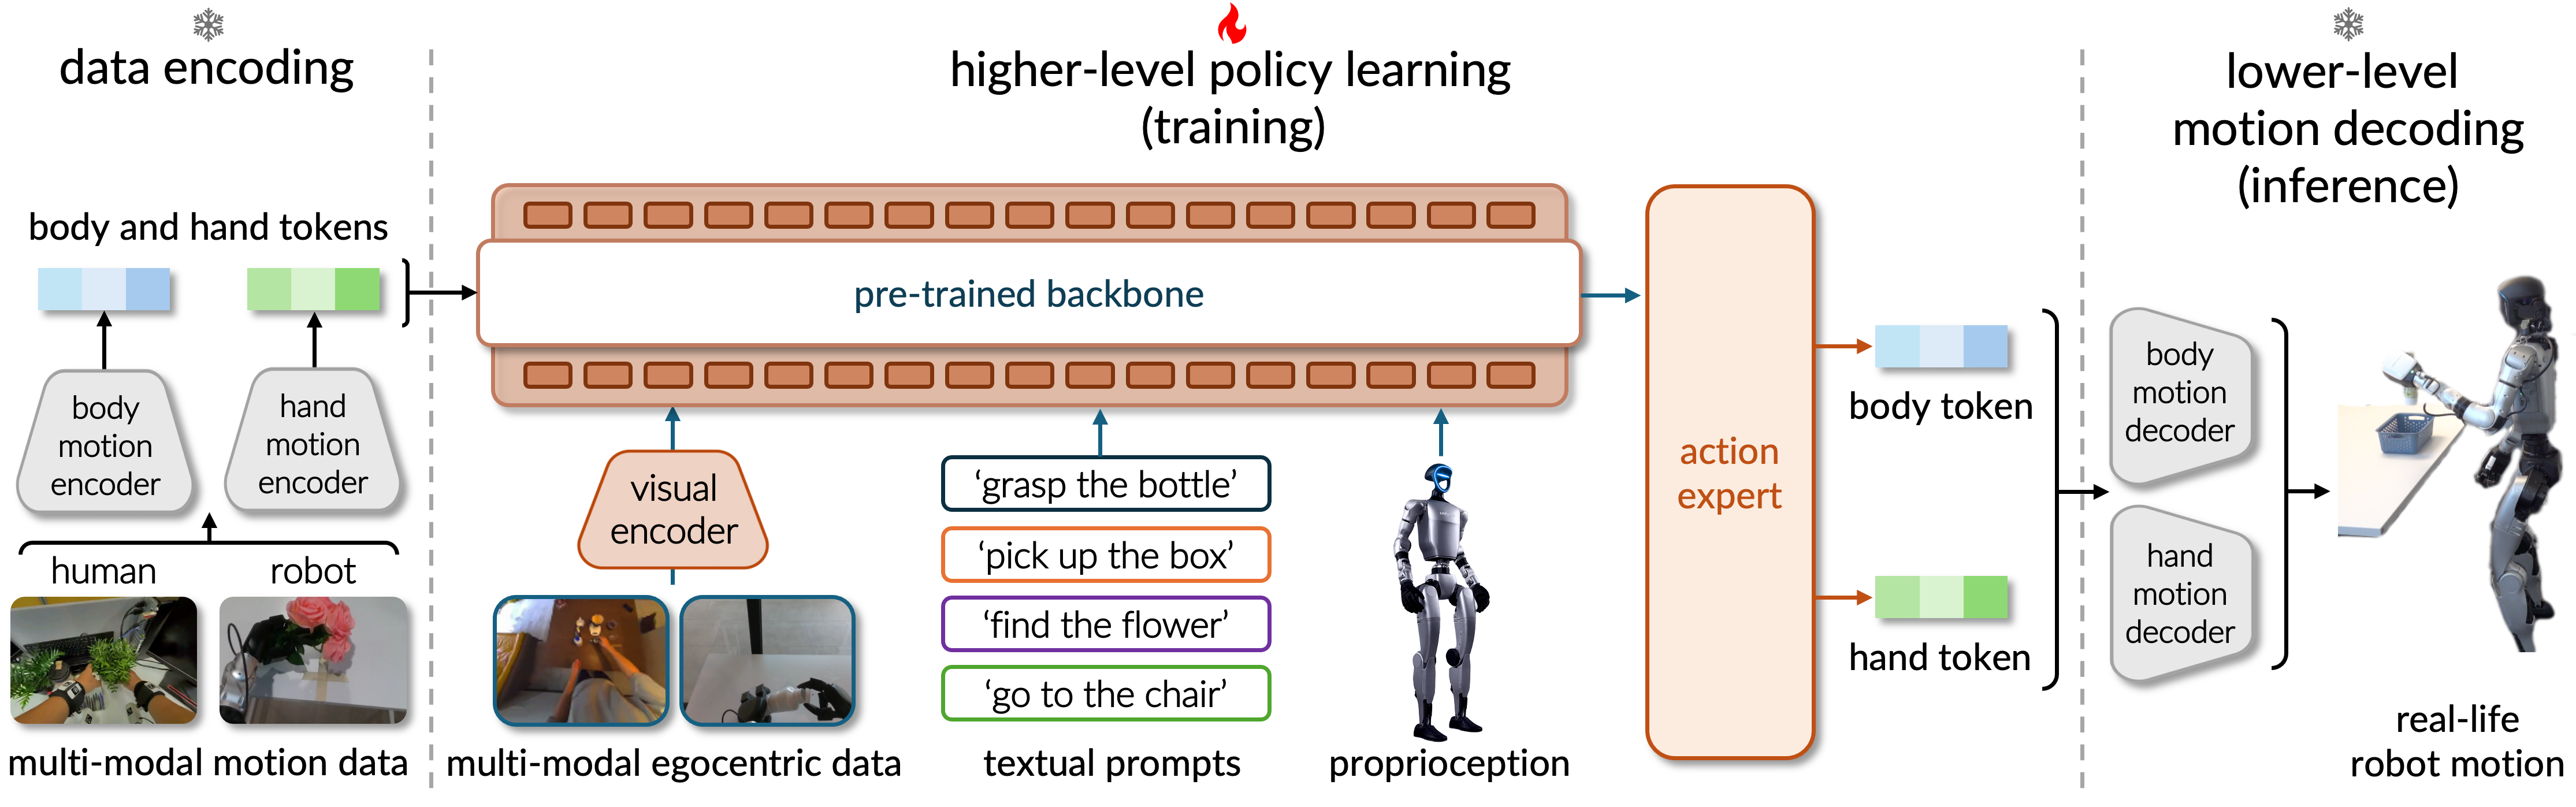
VioLA把高层策略的输出改成身体与手部各64维的共享动作表示,由冻结控制器执行。配套编码器把人类和机器人动作映射到同一空间,人类原始图像与指令因而能直接监督部署时使用的动作输出。真实G1无需任务专门微调即可完成多类动作,但抓持和行走的组合仍明显受限。
图解主要方法
人类示范如何直接监督机器人最终执行的动作,同时让预训练控制器承担全身关节协调?
- 1
把身体和手部变成可执行的共享动作
冻结SONIC身体编码器/控制器,加单独预训练的手部编码器/解码器。每个动作由64维身体与64维手部组成;编码目标位于FSQ网格,高层策略连续预测这些坐标,部署不是从有限命名技能列表选择。
- 2
用闭环仿真补齐人类示范的机器人状态
人类身体标注经SMPL、手经MANO拟合。冻结控制器在仿真追踪示范,按当前机器人朝向重编码下一步目标,以免假设机器人完美跟随人类;模拟状态与原人类图像、指令对齐。机器人示范仍保留实测本体状态。
- 3
在同一动作头上学习两类数据
GR00T动作专家用flow matching学习动作块,身体/手部模块不更新,不提供显式人类/机器人来源标签。缺手标注的数据只监督身体;150k步人类预训练后50k步在五语料间等概率采样。
- 4
以50Hz控制执行异步高层动作
身体控制器每20ms结合最近十帧本体历史更新29关节;Inspire手解码输出12指关节,选择重建窗第六帧并做五tick平均。高层GR00T预测40步,另外两骨干50步,并非高层本身50Hz完成推理。
- 5
在潜在空间衔接动作块
RTC把推理期间已承诺执行的旧块前缀作为新预测条件,减少交接跳变。该连续性依靠部署时序与低层反馈共同维持,不能从一次平滑潜在曲线推出所有接触任务稳定。
实验与证据
完整阅读84446字符全文与附录A.1–A.10,视检图2原图并核对官方项目的发布状态、失败任务及采样口径。未运行训练或硬件试验。
来源证据六行走/姿态任务每个5次,VioLA30/30,已发布GR00T5/30、Ψ0 0/30;七主操纵任务31/35。 图3、第4.1节 ↗
我的解读zero-shot定义是无任务专门微调;任务家族来自训练语料,留出的是episode、实验室和物体实例。对照是发布模型而非同样数据重训的关节输出消融。
来源证据额外搬瓶任务所有VioLA骨干与机器人数据变体均0/5,主方法纳入该任务后31/40=77.5%。 附录A.7、图10 ↗
我的解读失败涉及握持时机、开始行走及竖直释放;主图88.6%没有包含这一移动操纵任务。
来源证据人类单独训练12/30行走成功;机器人单独200k步24/30,人类后混合200k步30/30。操纵机器人单独33/35,混合31/35。 第4.5节、图6 ↗
我的解读人类数据补充身体动作,但当前日程并未提高所有抓取任务。human-only只指高层策略示范,仍继承预训练骨干和控制器。
来源证据转换池140572312帧、780.96小时,其中人类131010575帧、727.84小时;20680人类episode保留,5702被过滤。 表1、图9 ↗
我的解读统一50Hz帧数不是独立动作样本数。93.2%人类帧占比与150k+50k采样日程对应的约80%曝光不同。
来源证据相同数据和更新预算下,GR00T/π0.5/DiT4DiT行走100/66.7/100%,操纵88.6/45.7/25.7%。 图7、表2、附录A.3–A.4 ↗
我的解读骨干状态输入46/110/32维、块长度40/50/50和损失归一化不同,不能把结果完全归因于VLA对WAM架构类别。
来源证据高层平均预测延迟160.2/208.6/248.5ms,重规划间隔559.9/608.4/648.0ms;控制器50Hz。 表3 ↗
我的解读延迟统计用161/83/57段部署记录,超出计分试验数量,且按episode等权平均;不要混作五次任务试验均值。
来源证据站立/抬臂各RTC开关一段5.1秒记录,最大潜在步差0.332→0.064、0.455→0.070。 图8、附录A.9 ↗
我的解读按时间选首段而非按效果挑选,但仍仅四示例,且开关时延不同,不是重复试验平均或任务成功率消融。
来源证据旋椅平均60身体/31手token,关笔记本82/43;阈值按84校准、21留出episode的解码误差设置。 图5、附录A.10 ↗
我的解读token是执行后把相近连续预测分组的分析,不是实际压缩执行;手误差用Dex3指尖代理,非部署Inspire全轨迹误差上界。
开放情况与使用许可
官方viola.is.tue.mpg.de明确显示Code coming soon,并说明代码与检查点将于发布后链接;本轮未核实实际代码或权重开放。
LICENSE论文为arXiv非独占托管许可,原图2仅用于方法评论;待发布代码、检查点及动作模块许可不能由论文公开推断。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
机器人与人类示范共用部署动作输出,human-only策略在真机完成12/30行走姿态试验,支持人类动作标签能转移。
同200k更新的机器人数据对照及三骨干比较揭示不同数据和动作表示的实际收益边界。
反方 · 哪些结论还不够
93.2%是可用帧占比而非训练采样占比,实际期望人类样本曝光约80%;不能把大数据池比例当训练剂量。
机器人数据单独训练的操纵成功率94.3%高于混合88.6%,人类数据对所有能力的单调收益不成立。
额外搬瓶任务0/5,纳入后操纵成功率77.5%;手指无接触力反馈,抓持与移动衔接仍是弱项。
综合判断
可执行共享潜在动作提供了一条把人类示范接入人形控制的清晰路径,证据支持已见任务类型在新环境实例上的无专门微调部署。它尚未证明通用新任务迁移、跨机器人可靠性或稳定的移动操纵。
我会先做的验证
建议实验,未执行:按任务类型、环境和物体同时留出,固定样本曝光与计算比较人类比例;给所有操纵统一超时,加入搬运任务并测接触反馈,报告多机器人、多训练种子和失败后恢复。