VLA-Rolling:复用未执行动作,按置信度去噪
上一次预测的动作尾部,能否省下下一轮控制计算?
VLA-Rolling 保留动作块中尚未执行的尾部,用轻量置信度估计器判断其在新观测下是否仍有效,再决定重新加噪和去噪步数。四模型乘四基准的16组实验都减少动作块推理时间,14组成功率上升;真机优势则只来自20次试验中的一次额外成功。
图解主要方法
上一次预测的动作尾部,能否省下下一轮控制计算?
- 1
第一步:对齐旧动作尾部与新规划窗口
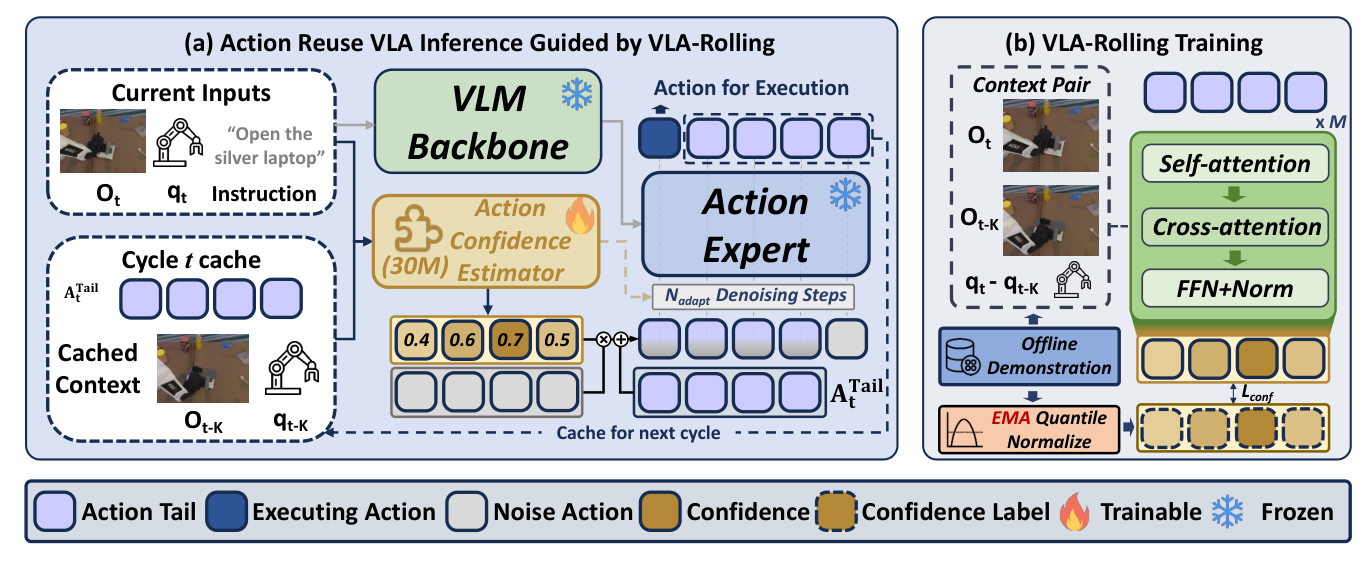
图4左侧缓存上一轮动作和视觉上下文。通常预测H=50步、执行K=10步,留下L=40步,下一轮把这40步平移到对应位置;X-VLA采用不同的30步窗口。新进入窗口的位置仍从噪声开始,旧动作不直接原样执行。
- 2
第二步:学习逐动作置信度
约30M参数的ACE读取当前视觉特征、与缓存观测的变化、本体状态及动作尾部。用对齐示范动作的对数误差构造目标,经10%/90%分位数EMA归一化,并对过度自信给予更大的非对称L1惩罚。底层VLA冻结,只训练这个复用判断器。
- 3
第三步:置信度同时控制加噪和计算预算
图4中的置信度c把旧动作与噪声按c和1−c混合;整段尾部的最小置信度决定约ceil((1−min c)×10)步的有界去噪预算。还要从匹配的中间流时间开始细化,而不是把部分去噪的状态当全噪声。少加噪与少步数必须配套。
- 4
第四步:执行前缀,再循环更新
只执行本轮前K步,再观测并重新评估尾部。复用建立在场景变化可被ACE识别的条件上;若动作误差或分布外变化导致置信度失准,节省的计算可能变成控制误差。论文中的置信度不是经过安全认证的失败概率。
实验与证据
已阅读v1正文与全部公开附录,并逐项核对v3全文修订差异及表1勘误;未独立复现。
来源证据LIBERO、MetaWorld、LIBERO-Plus和RoboTwin 2.0合计16组:动作块耗时均下降5.00–32.52%,14组成功率上升。MolmoAct2在LIBERO由291.34到196.61毫秒;SmolVLA在LIBERO-Plus成功率20.74到35.82。 表1,四模型×四仿真基准 ↗
我的解读这是动作块推理耗时,不包含机器人整条任务的所有成本。X-VLA两组成功率略降,因此速度改善不能直接写成所有控制任务全面提高。
来源证据π0.5在MetaWorld为67.22→67.88,差值是0.66个百分点;v1该格误植为+9.32,10月21日提交的v3及当前官方README均已修正为+0.66。朴素尾部复用在LIBERO-Plus有−4.89个百分点退步。 表1的数字核对及消融 ↗
我的解读本刊核对v1与v3全文差异,保留首发日期并采用已修正差值,不把旧版误植说成当前版本未解决的问题。复用本身不是充分条件,重新加噪、流时间和预算分配的协同才是方法要点。
来源证据Piper两类盘子各20示范,共40条;20次试验成功由14次变15次,块推理227.28→176.50毫秒。ACE训练使用4000步、batch64。 真机与附录A–F ↗
我的解读真机只多一次成功,不能据此判断小幅成功率改善稳定显著。长执行前缀下置信度相关性变弱,动态干扰、机器人平台变化还需测试。
开放情况与使用许可
2026-10-25核查官方仓库有ACE训练与评估脚本,当前在线rollout封装主要支持PI05;Hugging Face存在真实.pt检查点。仓库根目录及模型卡未核实到明确发布许可证,因此仅标代码/权重可取得,不宣称可自由商用;依赖模型和模拟器另有条款。论文及原图CC BY 4.0。
LICENSE论文及原图 CC BY 4.0;资源许可另见开放说明
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:把未执行尾部视为可重用计算而非垃圾,抓住了滚动控制中的实际冗余;冻结主模型也降低接入成本。
反方 · 哪些结论还不够
ACE需要与动作误差相符的校准,极端场景变化可能让它过度信任旧动作。16组加速是有力证据,但小样本真机成功差异和两组仿真退步不支持无条件增益。
综合判断
适合先在允许回退到完整去噪的控制系统中测试;将推理效率与成功率分别验收,避免只优化平均步数。
我会先做的验证
未执行的验证方案:保持主策略和硬件不变,以固定10步、固定少步、直接尾部复用、完整Rolling四组对照;增加中途移动物体和遮挡,各任务至少100次,报告成功率区间、P95块延迟、置信度误校准及回退频率。