WISD:用弱化副本找到值得强化的推理 token
量化与剪枝如何提供自蒸馏信号,为什么弱化过头反而失效?
从原模型与弱化副本对相同轨迹的概率差构造训练目标,无需更强教师。剪枝版在五模型、五基准的25种设置平均提升5.5个百分点;数学与代码分别训练,且论文附录的评测预算存在不一致。
图解主要方法
量化与剪枝如何提供自蒸馏信号,为什么弱化过头反而失效?
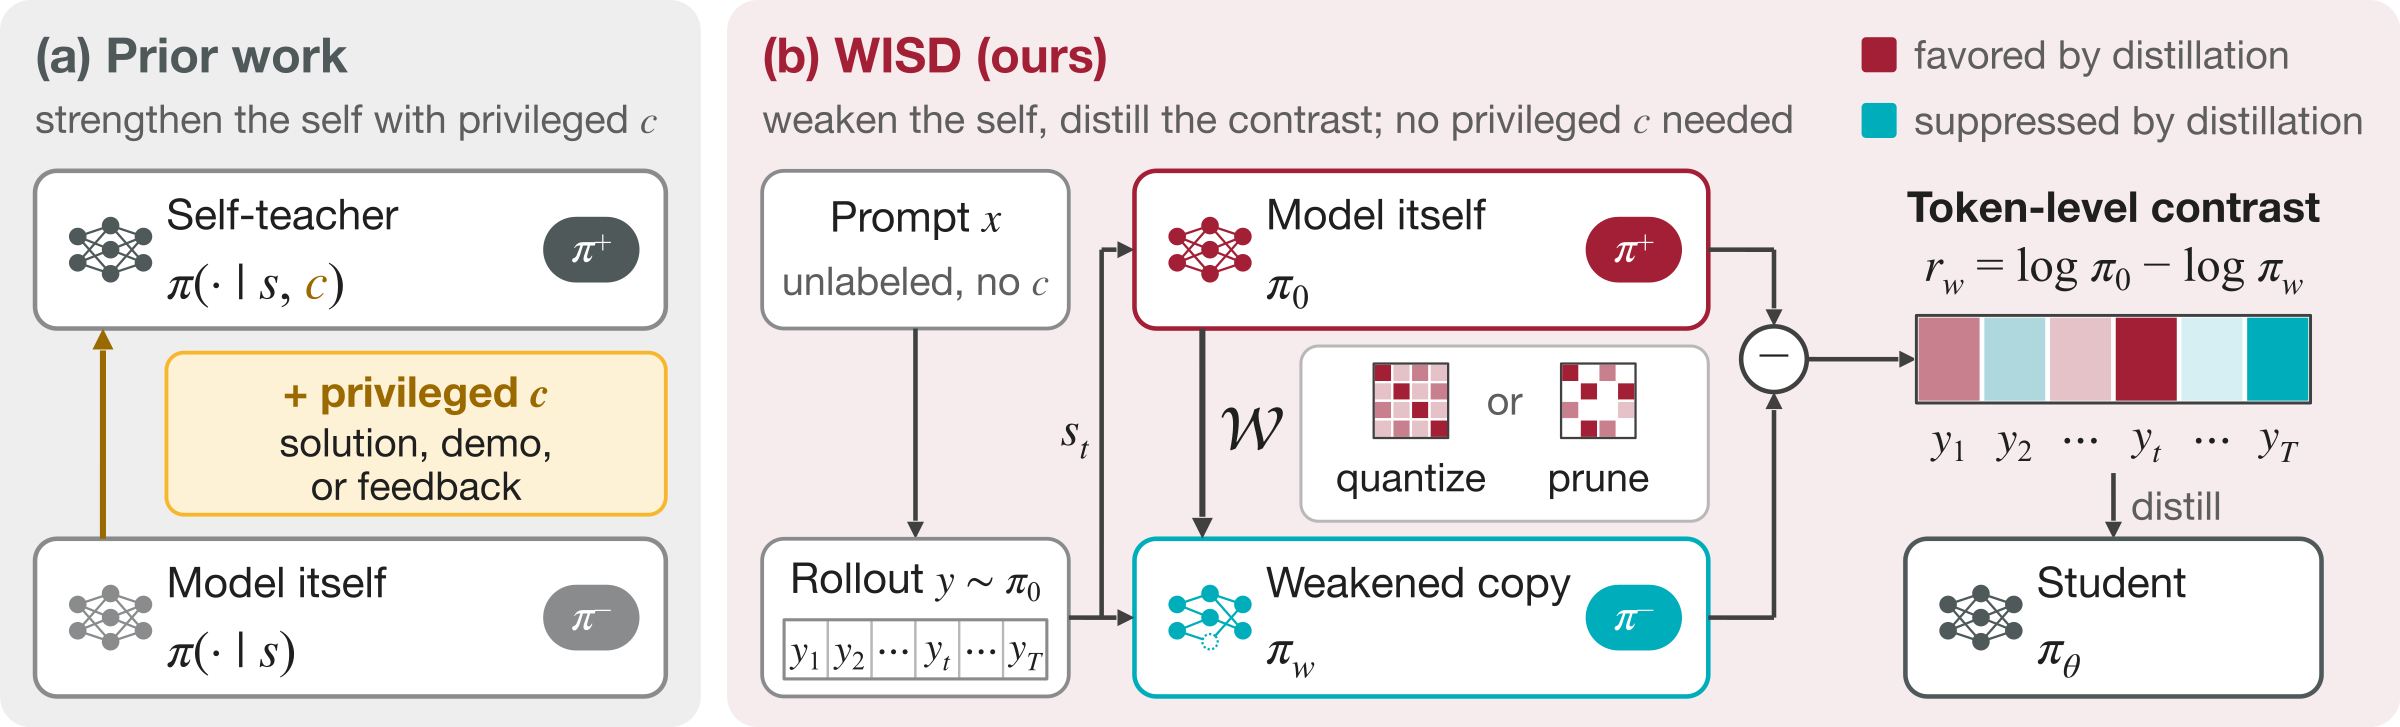
- 1
图2左侧:制造冻结的弱参照
对注意力和前馈投影施加3bit、组大小128的RTN量化,或按组内最大绝对权重的1/6剪去小权重并恢复每行L2范数。嵌入、输出头、归一化与路由器保持原状。弱模型只负责评分,学生并不是最终部署的3bit压缩模型。
- 2
图2中部:在同一前缀上计算差异
原模型在每个领域3200个提示上各采4条轨迹,共12800条;原模型与弱副本随后冻结。对相同状态与候选token计算r=log p原−log p弱,强调原模型掌握而弱化后丢失的偏好。公开实现保留原模型Top16支持集、全词表归一化和零奖励OTHER桶。
- 3
图2右侧:离线蒸馏而非不断重采
目标分布q正比于原策略乘exp(r/α),α=2;学生从原检查点初始化,以反向KL相关的离线DOPD目标训练200次更新,batch64、学习率1e-6。标题中的on-policy指初始轨迹来源;训练使用缓存,并非学生每轮重新生成。数学、代码学生各自训练。
- 4
弱化强度决定信号质量
弱化不是越重越好。Qwen3.5-4B的HMMT上,2bit量化49.9低于3bit的68.33;剪枝阈值1/2为49.58,1/6为70.52。过度破坏会让概率差不再定位有用能力,这与单纯增加训练量的解释不同。
实验与证据
已阅读全文正文与附录A实验配置、官方实现说明,核对实验条件与原图;未独立复现。
来源证据剪枝版25种模型—基准设置中23种提升,量化版21种;Qwen3.5-4B HMMT57.7→70.5,LiveCodeBench v6 39.1→56.7;但Qwen3.6-27B量化版五基准平均76.58→76.29。 正文主结果与消融 ↗
我的解读我的解读:机制有跨模型支持,但存在退化,不能说自蒸馏总能改进。平均提升是百分点,数学Avg@32也不是pass@32。
来源证据附录A.2写数学32次采样、40960输出上限,A.3又写64次、32768;仓库默认Avg@32、40960。AIME24参与开发;部分外部基线来自不同采样预算的已发表结果。 附录A与仓库评测说明 ↗
我的解读我的解读:保留预算冲突,仓库默认值不能反向证明表格用的究竟哪套。应以同预算原模型对照判断,不能据此排列跨论文榜单。
开放情况与使用许可
已核实jet-ai-projects/WISD含弱化算子、缓存评分、训练与评测实现,Apache-2.0。完整弱评分适配以Qwen3-4B为参考,Qwen3.5与OLMo训练适配不等于五架构全流程已验证。最终学生权重未核实;基座与数据另有许可。
LICENSE论文及原图 CC BY 4.0;代码与权重许可另列
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:冻结的弱参照把模型自身的不稳定能力转为低成本训练信号,尤其适合已有检查点但缺乏高质量标签的团队;弱化强度消融给出了可检验的机制线索。
反方 · 哪些结论还不够
概率差不等于正确性;训练提示分布和评测选择仍能贡献收益。只有固定初始轨迹,不能外推为持续在线自我改进;评测预算冲突尚未消除。
综合判断
值得复现Qwen3-4B的完整参考流程,先统一采样预算,再讨论跨架构收益;不能把训练代码公开等同于五个最终学生全部发布。
我会先做的验证
未执行的验证方案:固定未参与开发的数学与代码题集,分别比较原模型、等步数无弱参照蒸馏、RTN3与剪枝1/6,各跑三种种子;统一输出长度和采样次数,报告准确率、训练成本、退化题型及置信区间。