WeVisOne-VL:把语言定位接到像素级抠图
同一个视觉语言模型怎样输出框、掩码与透明度,而不把所有像素序列化?
WeVisOne-VL 在 Qwen3-VL 2B/4B 上统一检测、指代、计数和 OCR,再用对象令牌与框引导的轻量解码器输出掩码和 alpha。优势来自统一接口与共享视觉特征;抠图成绩中使用真值框的实验,不能等同于文本到抠图全链路表现。
图解主要方法
同一个视觉语言模型怎样输出框、掩码与透明度,而不把所有像素序列化?
- 1
第一步:把对象表示接入语言输出
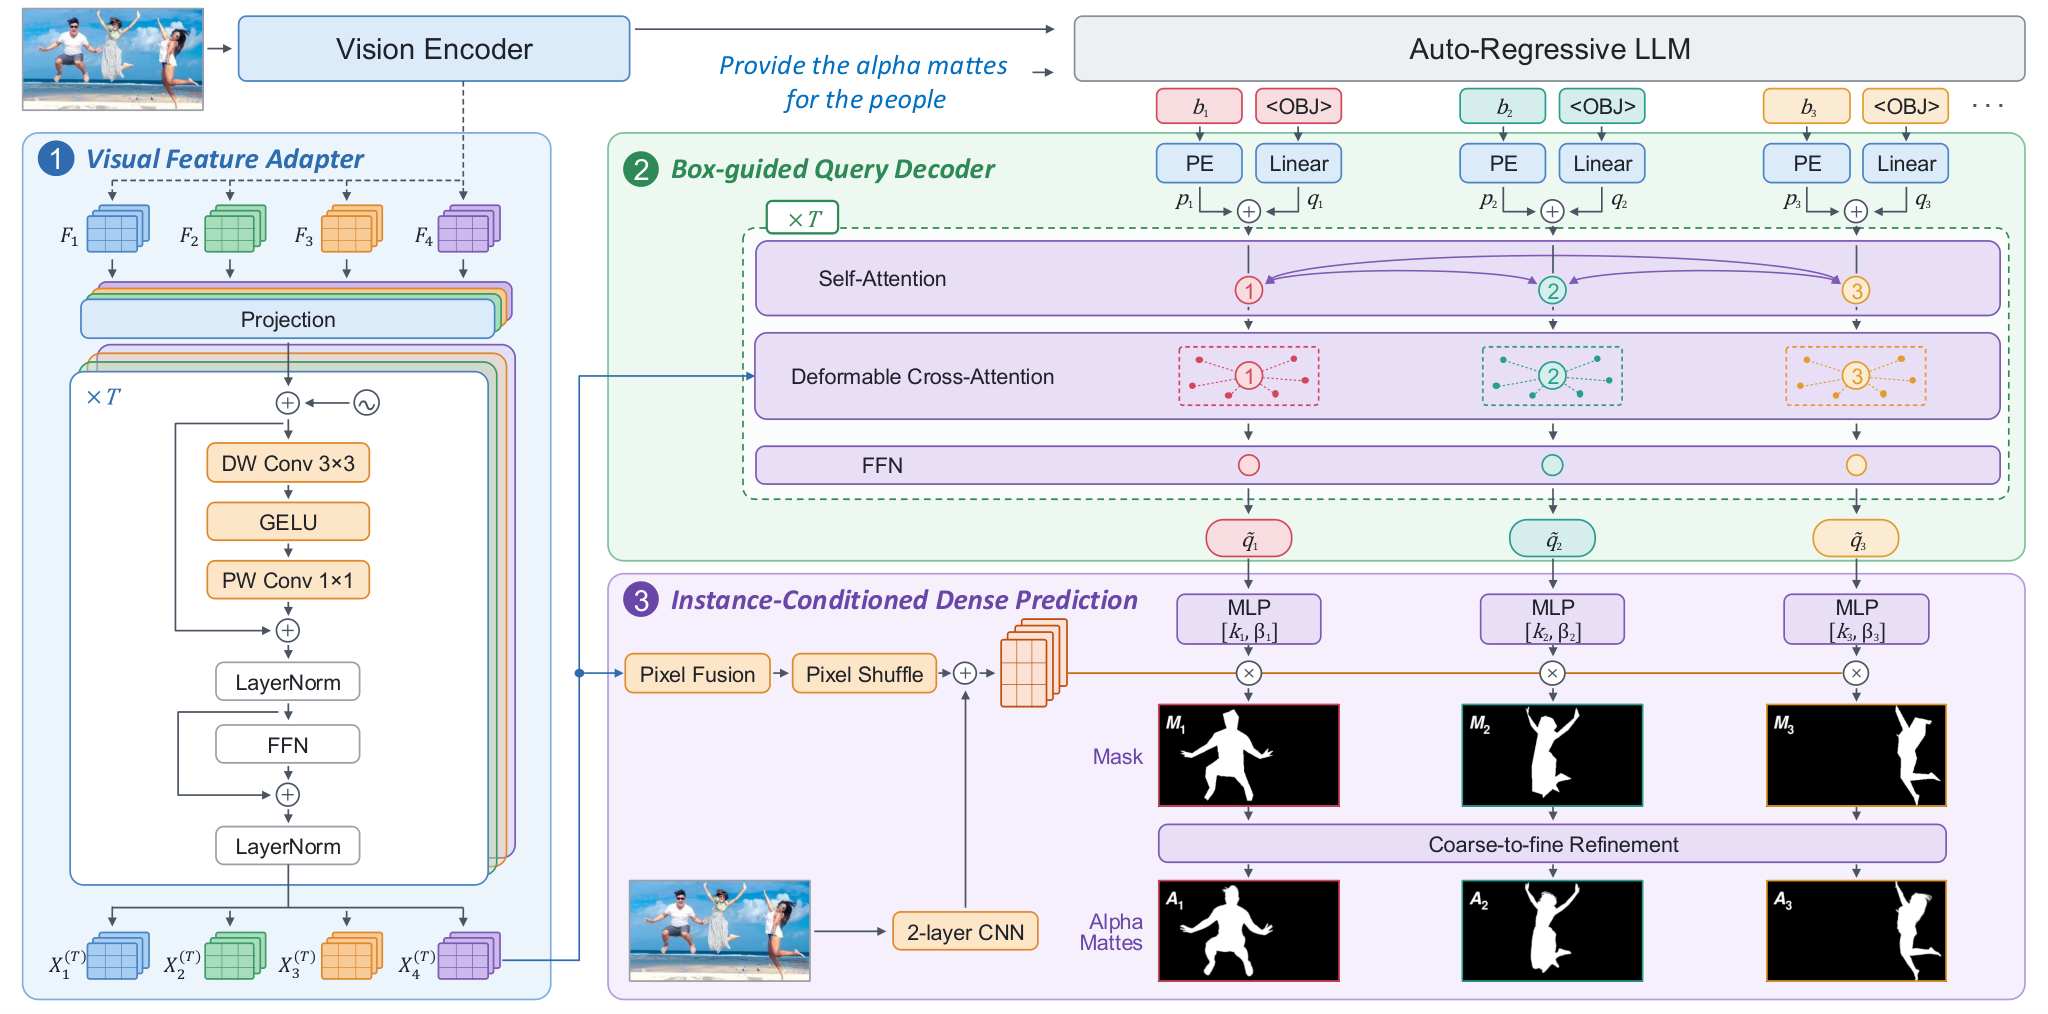
图4顶部的自回归模型先读取图像和任务指令。训练加入1001个坐标令牌和对象令牌 <OBJ>,让检测、指代与点定位使用统一输出格式;<OBJ> 的隐藏状态随后成为像素解码器的对象条件。它输出的是结构化对象位置,不是让语言模型逐个生成掩码像素。
- 2
第二步:共享特征,按框解码对象
图4左侧视觉特征适配器投影多层 ViT 特征,并补充约9.6M参数的 RGB 细节分支。中间6层框引导解码器用对象查询、自注意力和可变形注意力聚焦目标区域,再由动态预测头产出实例掩码。框的位置约束降低全图密集查询负担,也意味着上游定位错误可能传给像素输出。
- 3
第三步:从粗掩码细化到 alpha
图4底部把低分辨率对象特征、RGB 细节及粗预测融合,逐步恢复毛发、边缘等连续透明度。alpha 是图像覆盖度,不是材质透明率或三维表面属性;同一接口支持分割和抠图,但不能据此推断 PBR 材质或多视图一致性。
- 4
第四步:分阶段训练,不把框奖励说成抠图奖励
WDE 数据引擎汇集约1亿图像、36亿框,结合专家伪标注与人工抽查。SFT先预热解码器,再重置视觉语言主干而保留对象令牌,继续多任务学习;三个阶段报告90.2M、40.5M、41.8M样本。随后 GRPO 每题8次采样,以框 IoU 的立方等信号训练;像素掩码本身没有直接获得这一框奖励。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据作者使用128 GPU进行SFT、160 GPU进行RL;评测使用1960视觉令牌和贪心解码。4B在Dense200上的平均F1为71.3,对照LocateAnything为58.7。 §4–5,训练与检测表 ↗
我的解读这是特定输入预算下的F1比较,不是COCO AP。训练集包含VisDrone、CLOC、MixCount及OCR相关训练数据;只有文中明确标出的COCO/LVIS设置可按其零样本定义解读。
来源证据4B的拒答率86.0、cIoU72.2;2B为62.4、73.4。P3M抠图MAD中4B为7.3、2B为6.6,越低越好。 §5,Ref-ZOM与抠图表 ↗
我的解读更大模型提高不存在对象的拒答能力,却并非所有分割或抠图指标都改善。抠图表含真值框条件,排除了预测框错误,不能直接宣传为端到端文本抠图质量。
来源证据全文描述单轮任务模板、统一坐标表示及多来源数据配比,未给出通用推理能力保持或复杂多轮编辑的完整评测。 附录A–B,任务和数据细节 ↗
我的解读统一感知接口有工程价值;是否牺牲原模型对话与推理能力、细碎目标上是否稳定,仍需另外测试。
开放情况与使用许可
2026-10-25核查:官方GitHub有推理、评测与像素解码实现;微调代码仍列为待发布。官方Hugging Face的2B、4B均有model.safetensors,模型卡标Apache-2.0,腾讯自有代码亦以Apache-2.0发布,第三方组件保留各自条款。论文/原图为CC BY 4.0;未确认WDE完整1亿图像训练集合公开。
LICENSE论文及原图 CC BY 4.0;资源许可另见开放说明
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:对象令牌把可解释的位置输出与像素解码衔接起来,共享骨干避免为每项感知任务维护独立系统,适合需要定位、分割和抠图统一接口的视觉工具。
反方 · 哪些结论还不够
核心反证是评价条件并不统一:真值框抠图绕过了上游定位,规模扩大会改变拒答与分割的取舍;大规模伪标注也不能自动保证长尾精度。论文没有证明多轮编辑或通用推理能力不退化。
综合判断
值得作为统一视觉感知组件试用,但应分别验收框定位、条件抠图和文本端到端抠图;不把三者的最好分数拼成单一能力宣称。
我会先做的验证
未执行的验证方案:固定200张包含透明物体、毛发、拥挤与目标不存在情况的图,分别输入真值框、预测框和纯文本;记录框召回、alpha SAD/MAD、拒答率及延迟,并和原Qwen3-VL做通用问答保持对照。