WideSWE:一个需求跨仓库,成功要看整个系统
120个真实任务中最佳配置完成42.5%;改对一个仓库仍可能整体失败
前端、后端、SDK往往必须一起改变,单仓库榜单难以验证接口一致性。WideSWE从关联PR构造120个跨仓库任务,让agent处理共享请求,并要求所有目标仓库通过隐藏测试;结果揭示遗漏仓库、错误共享表示和修复后退化三类问题。
图解主要方法
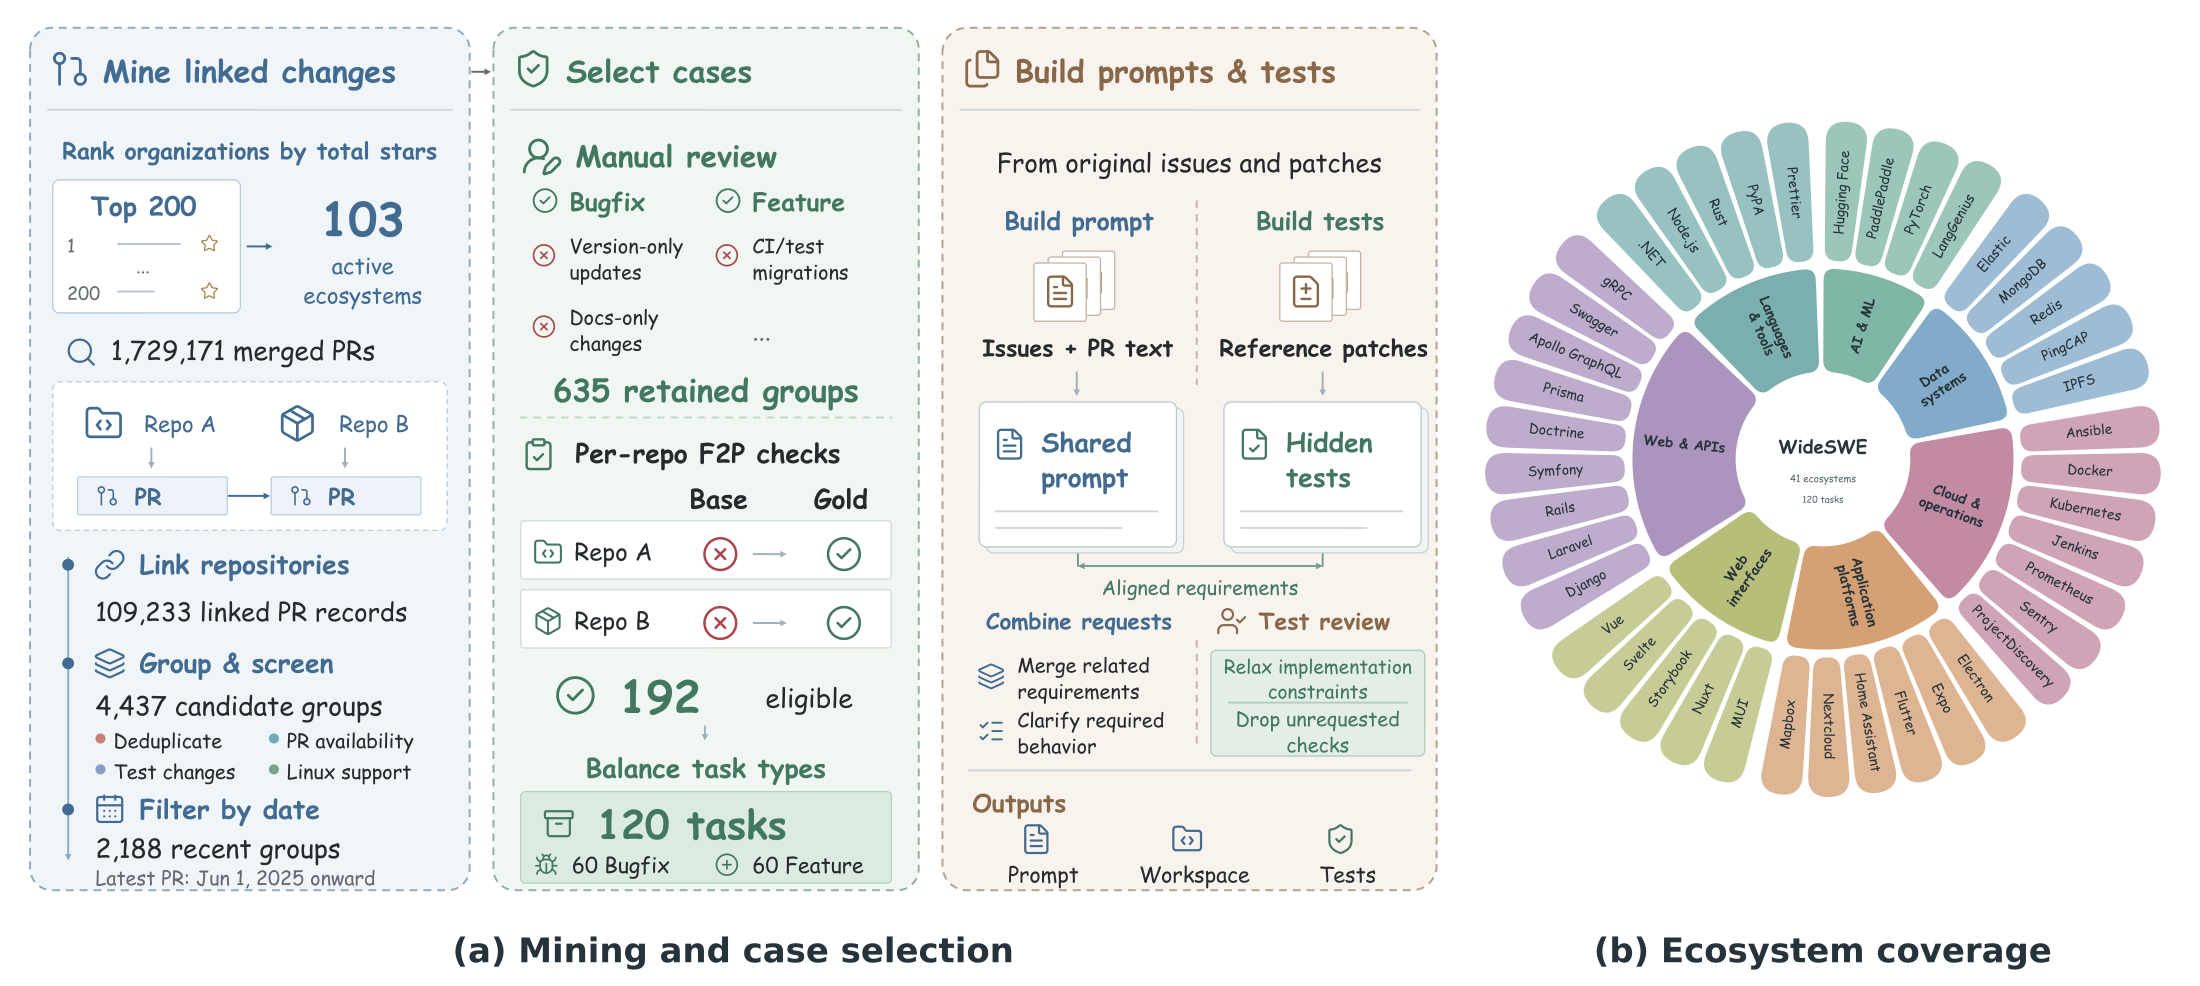
图2如何从关联PR得到可复现任务,又怎样避免测试只接受原作者那一种实现?
- 1
挖掘关联改动并人工收紧范围
从103个生态约173万PR中得到109233条跨链接,筛到4437组候选、2188组较新改动,再人工保留635组、192组合格,最终平衡为60修复与60功能任务,覆盖41生态253目标仓库。选择流程带有公开项目和可运行测试偏好。
- 2
恢复历史工作区而非提供答案
每题包含2或3个目标仓库及0至20个上下文仓库,目标从PR基础提交恢复,上下文不晚于最早目标基础时间;给原始需求与关联信息,隐藏参考补丁。可编辑上下文不等于这些仓库自动计为目标完成。
- 3
用全目标测试约束接口一致性
所有目标的fail-to-pass与pass-to-pass必须同时通过才计成功。作者复核88题,87题放宽过度绑定实现的测试,16题移除未请求检查,存在交集;仍保持旧版失败、参考改动通过。测试通过仍不代表线上所有消费者兼容。
- 4
分开比较系统配置和组织方式
主表同时改变模型及agent脚手架,测的是完整配置。另在89个相同提示任务上比较联合工作区与逐仓库独立运行;后者每个目标各有一整次运行,预算并不相同,不能把结果简单读成“多agent无效”。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【主表】120任务中最佳配置42.50%整体成功,单目标仓库成功63.64%,至少一个目标成功83.33%。同模型换脚手架整体为32.50%。 表1、任务级与仓库级统计 ↗
我的解读我的解读:跨仓库完整交付明显比局部修复困难;脚手架影响很大,不能把榜单当纯模型能力排名。
来源证据【组织对照】89题联合36/89=40.45%,独立32/89=35.96%;独立API成本约296.6对94.7,为3.13倍。 RQ3及相同提示子集 ↗
我的解读我的解读:在该协议下共享上下文更划算,但修复和功能任务方向不同,也没有等总预算比较。
来源证据【失败诊断】此前未编辑目标后续恢复12/20,已编辑但仍失败目标仅5/53。 失败分析与恢复实验 ↗
我的解读我的解读:漏改相对容易补救,但这是不同失败群体的描述统计,不是随机干预的因果结论。
开放情况与使用许可
已核实官方仓库含120题定义、评测脚本、agent适配器、容器定义与构造流程;未在本机运行其研究评测。
LICENSE根目录未见LICENSE,仓库再利用许可未确认;各上游仓库仍保留原许可,论文CC BY 4.0不替代代码授权。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把多个仓库的接口契约和完整交付作为评测单位,直接补上单仓库编码基准的盲区。
反方 · 哪些结论还不够
只覆盖Linux下2–3目标仓库、公开项目与有限隐藏测试;模型和脚手架、独立运行预算均存在混杂。
综合判断
适合作为复杂软件需求的验收补充;关键是所有相关组件保持共同语义,而不只是每个仓库各自测试变绿。
我会先做的验证
未执行的验证方案:固定模型、脚手架及总token和时限,比较联合、独立与显式接口契约协作;加入跨进程端到端测试,报告遗漏、协议不一致、回归及每成功任务成本。