WM-VS:训练机器人判断动作是否真正接近目标
世界模型用于训练动作后果,部署时仍是实时闭环策略
WM-VS 不以视频逼真度训练世界模型,而把动作之后的视觉变化对齐到目标误差。冻结该模型后,策略通过短程想象学习误差收缩。真实机械臂的证据重点是到达目标后能否保持,而不是最好一帧有多准。
图解主要方法
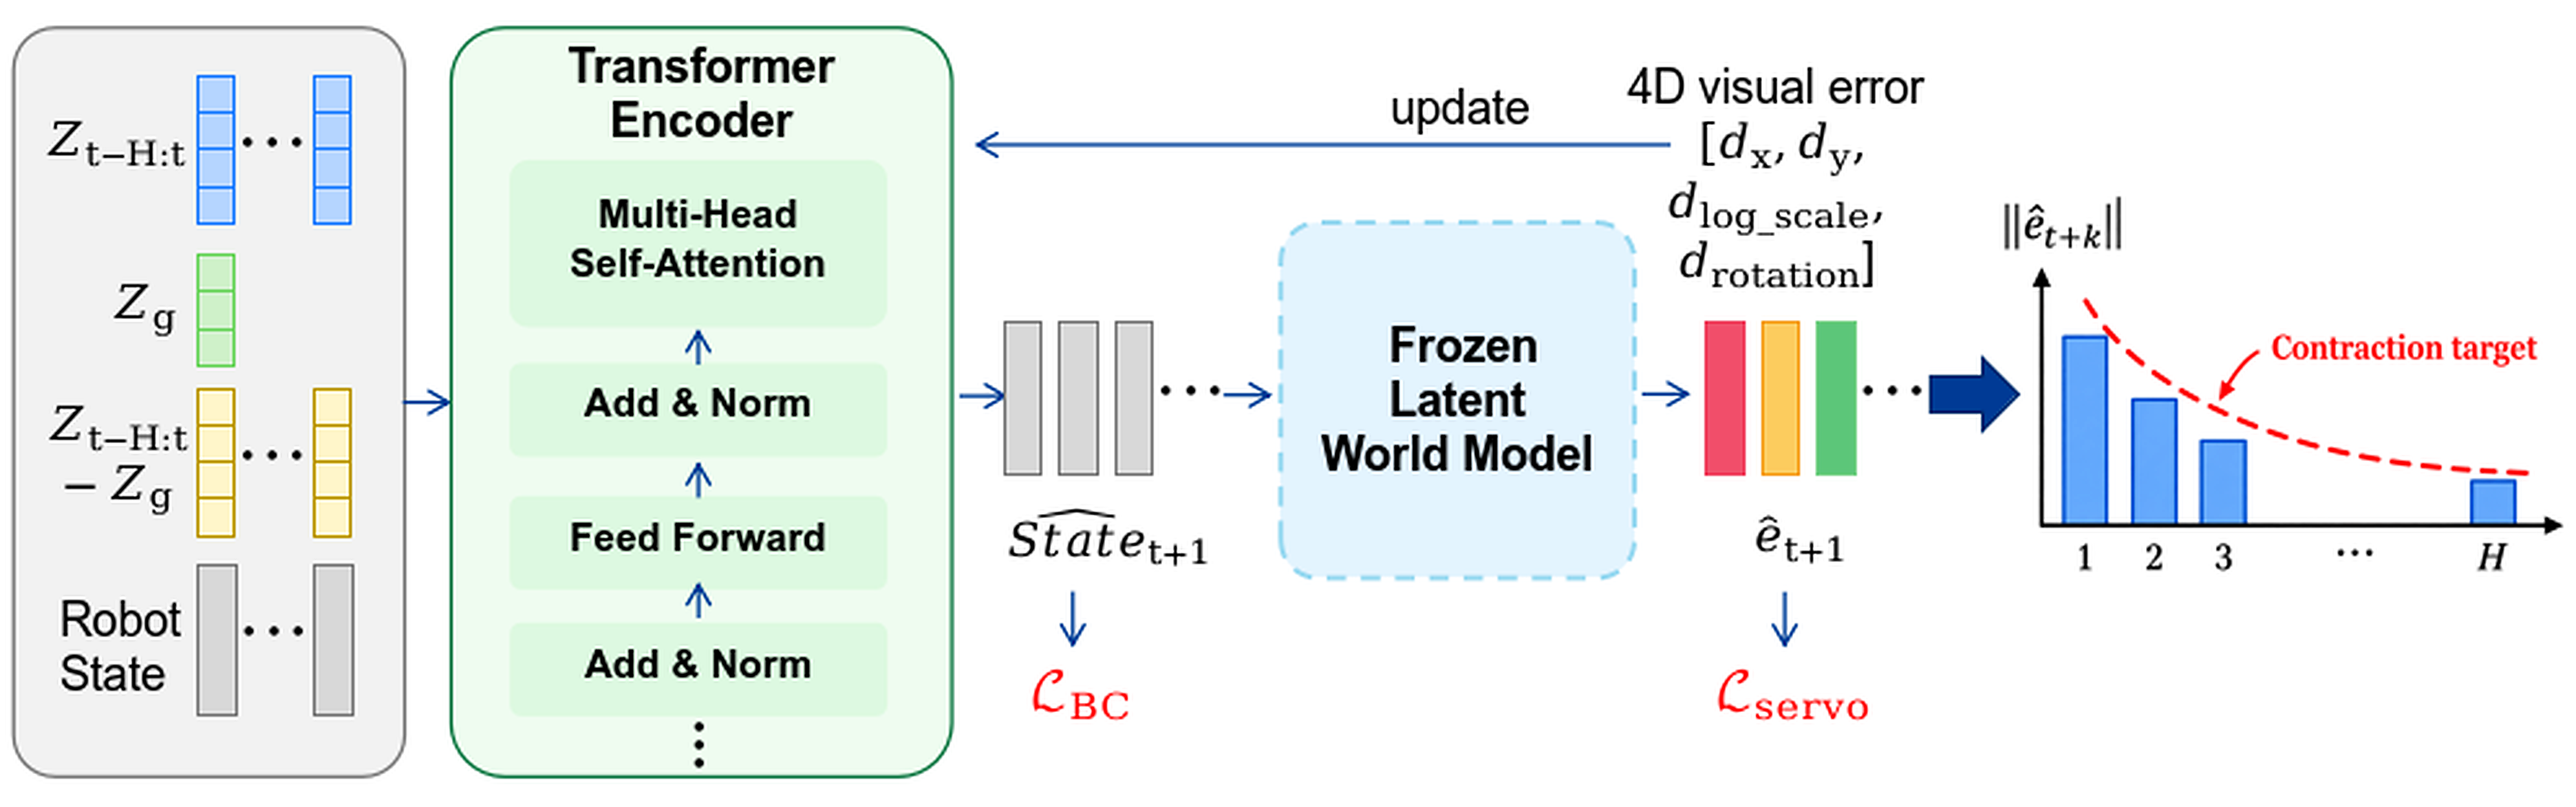
图 2 如何把动作模仿变成动作后果监督,为什么“到达”和“保持”不同?
- 1
先离线构造带方向的四维误差
在当前与目标物体区域上做 DINOv2 特征匹配,用互为近邻过滤与 RANSAC 相似变换得到横纵平移、对数尺度和面内旋转差。各分量按训练集尺度归一化。它为进展提供监督,但不是完整六自由度物理状态;AprilTag 不参与这些训练目标。
- 2
第一阶段:让潜在转移能够读出未来误差
冻结视觉骨干,融合目标区域、关节状态和历史动作;世界模型根据动作预测下一潜变量。除潜变量预测损失,还要求当前与未来潜变量解码出相应四维误差。未来误差监督让“预测了什么”与“离目标更近了吗”联系起来。
- 3
图 2 中部:冻结世界模型,约束策略动作
策略输出七关节速度,通过固定世界模型得到想象后果。行为克隆把动作留在示范附近,再对齐示范下一步误差;由于策略动作不完全等于示范动作,这个下一步目标只是局部正则,不能当成精确的 on-policy 真值。
- 4
图 2 右:连续三步要求误差收缩
对策略自身的三步想象惩罚超过 ρᵏd(e)+ε 的误差,ρ=0.9、ε=0.02;近目标动作惩罚减少无谓运动。这是训练约束而非闭环稳定性的数学证明,模型误差仍可能误导策略。
- 5
部署时每次重新看当前图像
策略约 5Hz 更新,底层插值最高 30Hz;用 RGB 与机器人本体反馈,不用深度或在线轨迹优化。论文使用 AprilTag 筛选采集端点并做外部评价和停止监督,因此 RGB-only 描述的是学习控制器输入,不是整个实验从未使用标记。
实验与证据
以下实验均为作者报告,本站已阅读论文正文及可用附录,未独立运行研究实验。实验条件、观察结果与编辑解读逐项分列。
来源证据【§IV】7DoF RealMan、固定眼在手外相机,1000 条轨迹按 700/150/150 划分,避免同轨迹邻帧跨集合;每方法 30 次真机试验。 §IV-A ↗
我的解读这是特定伺服平台与目标设置,尚非多任务抓取或通用操作能力。初始误差较大,10%标准也随每次起点变化。
来源证据【表 II】完整方法 30/30 曾达到初始角点 RMSE 的 10%以内,但最后有效帧保持为 25/30;去掉未来误差监督后保持率降至 26.67%。 §IV-C–E,表 II ↗
我的解读到达率和最终保持率必须分别报告。消融支持动作后果监督的贡献,但不等于无限时间稳定或任意扰动下安全。
来源证据【表 III】两个未见 3D 目标的最佳帧 TCP 平移误差减少 86.48%/90.27%,仍残留约 45.66/31.88mm。 §IV-H,表 III ↗
我的解读相对降幅很大不代表绝对精度达到装配要求;新目标结果是最佳帧 TCP 指标,不能与标记目标的最终像素误差混用。
开放情况与使用许可
论文明确称代码与数据将发布;本次未核实可下载正式实现,按待公开处理。
LICENSE论文 CC BY-NC-SA 4.0;代码与数据许可尚未核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
未来误差监督的消融与独立外部误差信号相互补充,解释了保持精度的实际价值。
反方 · 哪些结论还不够
想象中的误差收缩不是实际系统稳定性保证;标记筛选、停止监督和基线传感器差异都应纳入复现。
综合判断
控制目标明确、真机证据具体,适合继续验证,而非泛化为通用机器人世界模型。
我会先做的验证
未执行的验证方案:固定起点和时长,对照 BC-only 与完整模型,在遮挡、反光、对称目标和延迟下连续运行;同时报告最后一帧、整段最大误差、失稳次数与所有失败试验。