WorkFactory:先把工作环境造对,再训练办公智能体
合成任务如何避免缺资料、错依赖与把答案直接写进输入?
从职业意图构建隐藏的信息支持图,生成文件环境,再由看不到答案规划的探针实际执行并修复。112686个任务训练WorkPilot,多个办公基准提升;当前仓库仍是发布占位,论文中的数据和模型开放承诺尚未落地核实。
图解主要方法
合成任务如何避免缺资料、错依赖与把答案直接写进输入?
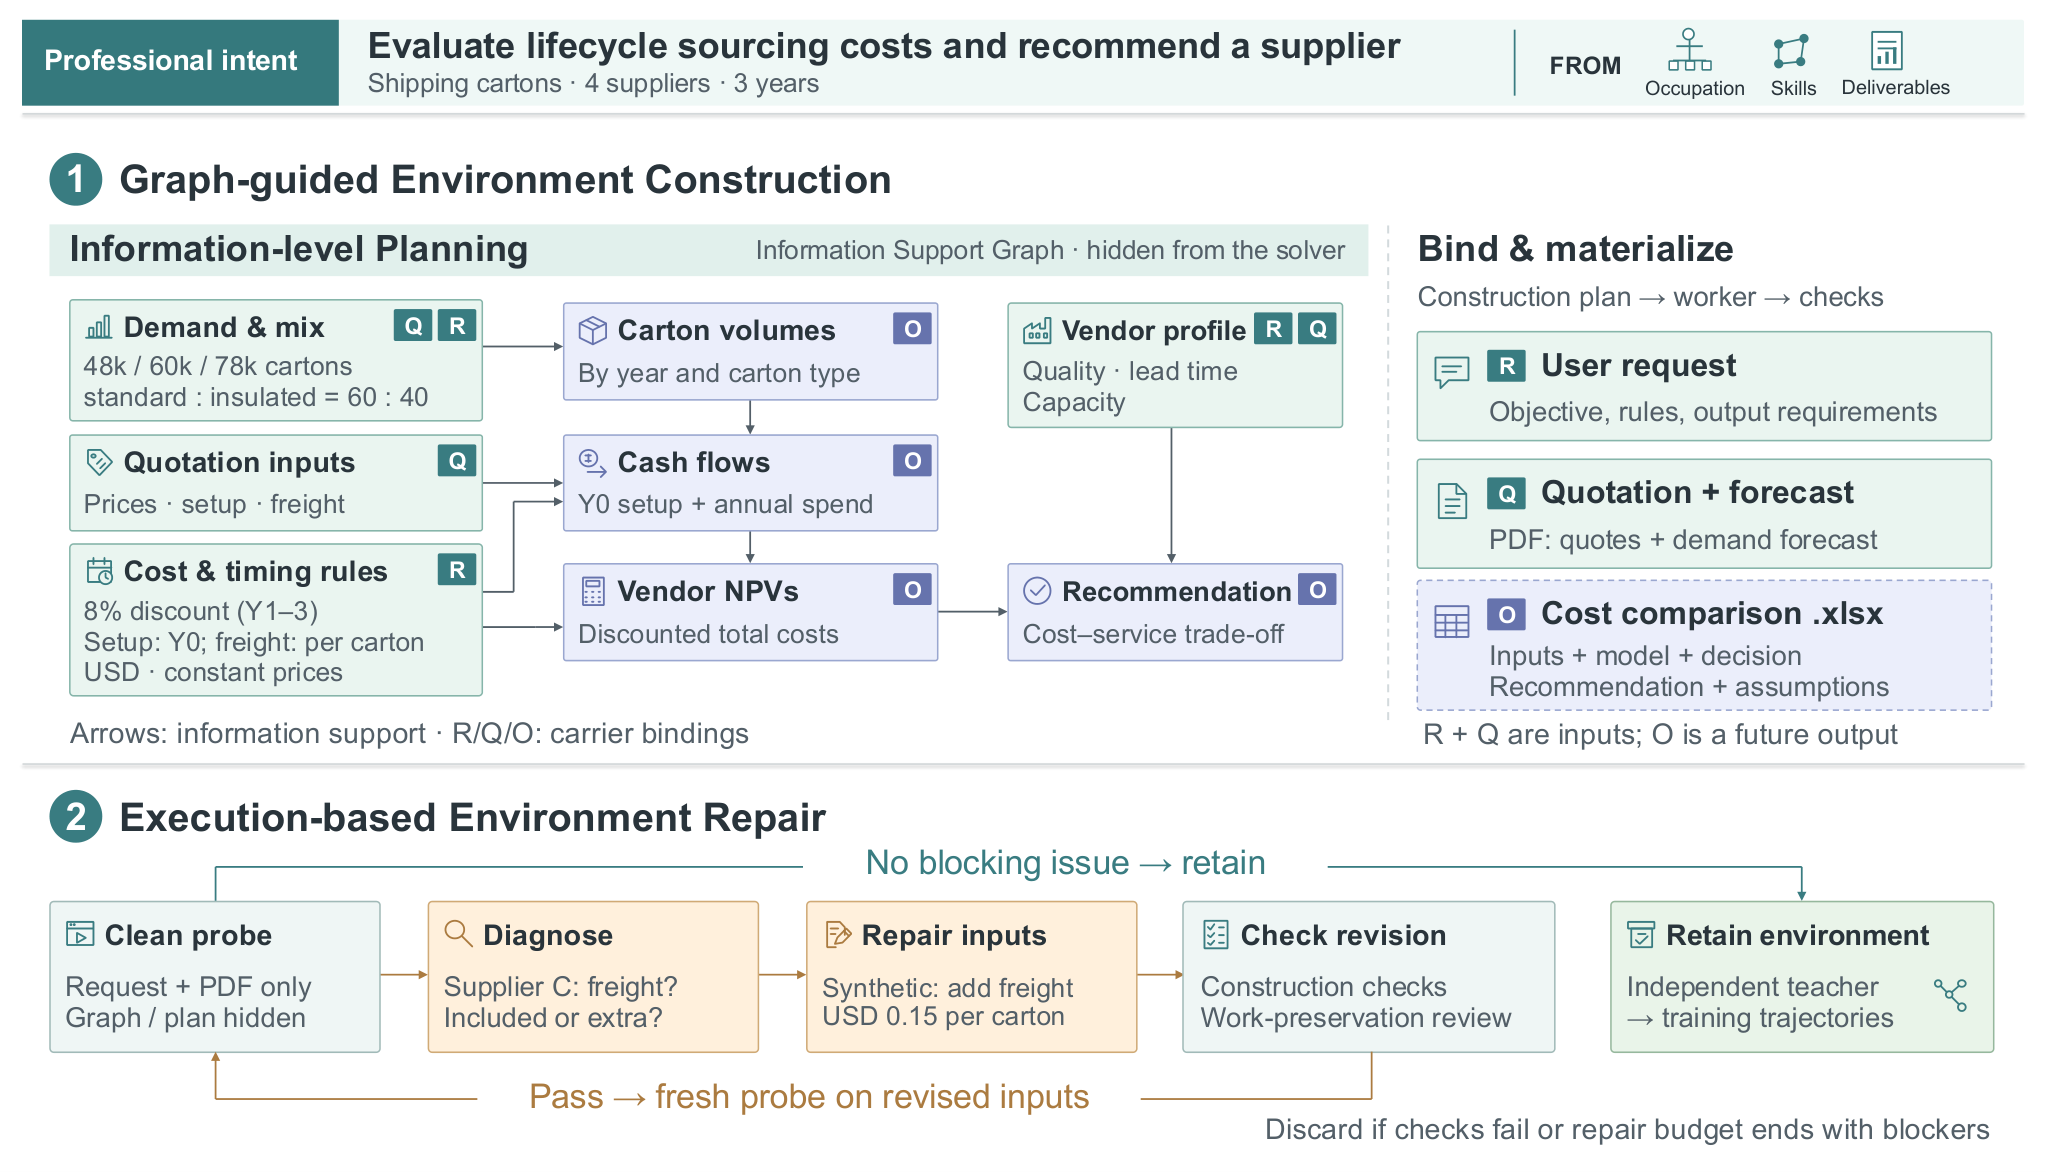
- 1
图2上层:反向规划信息支持图
从交付物倒推需要的事实、约束与推导关系,将信息节点与PDF、表格等载体节点分离。区分已提供、外部可取、应由执行者计算以及内部规划信息;例如供应商报价可提供,最终成本比较须留给模型完成,防止环境把目标答案泄露出来。
- 2
把图实现为真实可操作文件
按无环依赖计划生成多格式材料并检查文件、关系与约束。任务意图来自职业、技能和交付物线索。图只用于构造者,执行模型看到的是请求与材料;工作难度不应靠损坏文件或缺失必要输入人为制造。
- 3
图2下层:干净探针与保难度修复
每次探针从全新沙箱出发,不接触内部图、规划和旧运行日志。发现阻塞后修复输入,再检查是否保留文件种类、依赖与实际工作量;正常需要推理的选择不能算环境错误。反复仍不能消除阻塞的任务被丢弃。
- 4
独立教师轨迹与有边界的筛选
GLM-5.3在干净环境完成任务,得到平均57.36轮、62.95工具调用的长轨迹。全体只做轻量完整性过滤,最长5%再与固定基线交付物比较,最多四次独立尝试。SFT训练四轮、256K序列;失败工具调用的token不监督,但失败上下文保留以学习恢复。
实验与证据
已阅读全文正文、局限及附录D.3和E评测协议,核对实验条件与原图;未独立复现。
来源证据5000任务对照中,普通材料、信息图、再加执行修复的局部Elo为1245/1293/1326;坏推导24.86%→6.86%→3.26%,答案泄露1.92%→3.36%→0.84%。 正文消融与附录D ↗
我的解读我的解读:信息图本身不能保证不泄露答案,执行修复才补上这一环;不能把全部环境都称为已证明正确。
来源证据WorkPilot-35B-A3B的GDPval局部估计879→1565,95%任务bootstrap区间1539–1589;JobBench28.91→62.35、Workspace47.12→56.53、Office7.14→21.18。每任务三轮;执行模型均为纯文本输入。 正文结果与附录E.1 ↗
我的解读我的解读:1565来自两锚点Bradley–Terry拟合及固定映射,不是官方提交成绩;区间不包含裁判和标尺模型误差。视觉裁判可看文档渲染,不代表学生得到视觉输入。
来源证据任务覆盖612职业、23组,平均4.15文件;75K→110K任务仅再增13Elo,web-fetch失败仍约40–48%。成本估算固定缓存命中率99.2%,不含工具、裁判、沙箱等。 规模、失败与成本口径 ↗
我的解读我的解读:长轨迹能力改善不等于工具可靠性问题消失,估算推理费不能当真实办公工作流总成本。
开放情况与使用许可
官方IQuestLab/WorkFactory仓库目前仅README、图片等;数据与模型链接仍是页内占位。根目录Apache-2.0不能证明代码、112686任务或WorkPilot权重已开放。本次不将其计作开源。
LICENSE论文及原图 CC BY 4.0;代码与权重许可另列
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:先验证任务能被合理完成,再蒸馏执行轨迹,能把环境缺陷与模型缺陷分开,适合构建企业内多文件流程数据。
反方 · 哪些结论还不够
多数轨迹并未做交付物正确性强验证;教师偏好会传入学生。公开材料不足以独立检查112686任务的覆盖与泄漏,合成任务收益还需在企业真实材料上验证。
综合判断
方法和消融值得借鉴;当前应归为公开论文、待发布实现与数据,不能称为完整开源办公智能体。
我会先做的验证
未执行的验证方案:抽取100个真实但脱敏的办公流程,盲分原材料、信息图构造、执行修复三组;专家独立检查缺件、泄漏、交付物正确性,统一工具预算测基座与SFT模型,另外计入沙箱和人工修复成本。