工作记忆读出瓶颈:看见正确信息,仍可能答错
N-back 的错误究竟来自注意力定位不准,还是干扰内容进入决策?
研究在三类共15个预训练模型中,用逐试次注意力、线性探针与因果干预区分定位失败和读出失败。结果更支持干扰解释,但已知目标位置的抑制实验只是机制诊断,不能直接成为通用长上下文修复方案。
图解主要方法
N-back 的错误究竟来自注意力定位不准,还是干扰内容进入决策?
- 1
构造可区分机制的错误
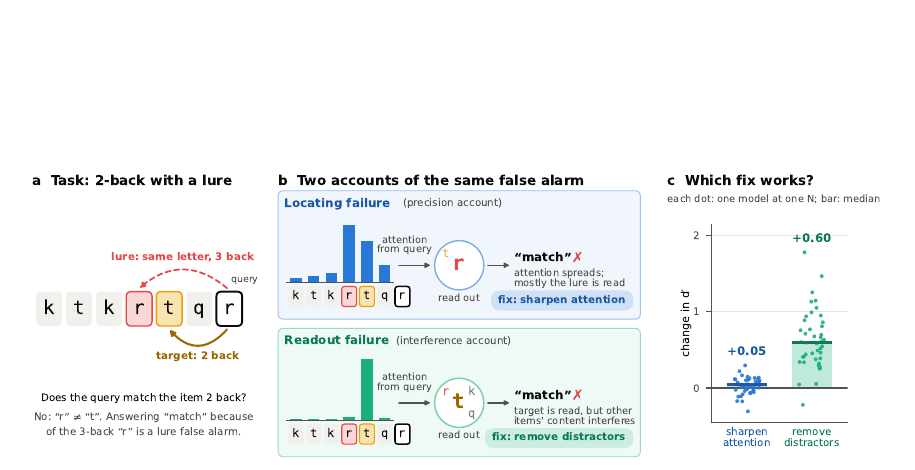
图1a把当前字母、N步前目标和邻近位置的相同字母诱饵分开。每条24字母序列来自20个辅音,含4个诱饵;提示给3条示范并显示此前正确答案,避免把早期生成错误累积误认成记忆失败。用200条序列校准回答阈值,再在独立1000条测试序列上测d′,并分别统计命中、诱饵误报和普通误报。
- 2
同时测定位与可读信息
用只替换目标字母的成对输入做激活修补,找到承担任务的头。前5个重要头对目标整行的注意力与邻行比较;残差流上用按序列分折的逻辑回归探针,判别匹配发生在目标还是诱饵位置。必须区分:多数漏报仍关注目标,而诱饵误报通常关注诱饵;不能把后者也描述成注意力始终正确。
- 3
用两种干预建立因果对照
图1b–c比较前3头温度锐化与非目标内容抑制。后者从校准集20类字母均值建立19维子空间,在各残差位置去掉非目标整行的一半字母分量,保留目标。随机等维子空间、抑制目标和重要头消融提供对照;每种干预重新校准阈值,使用2000次按序列配对bootstrap。
- 4
用最小模型限定理论适用范围
单层、无残差、线性读出只能通过注意力权重的内容依赖性比较字母;固定精准关注当前和目标也不够。加入第二层、残差及合适位置编码后可先复制再比较。附录证明与720个单层检查点的干预用来检验这一边界,不是把简化线性读出模型当成预训练网络权重的精确推导。
实验与证据
已阅读正文§1–8及附录A–D(证明、方法、架构对照和完整结果表),核对实验条件与原图;未独立复现。
来源证据Pythia七种、GPT-2四种、Qwen2.5四种,70M–14B;机制分析采用逐行提示且此前答案为真值。小模型最多30000训练步;整个项目约51 GPU小时。 §2、附录B:实验设计 ↗
我的解读覆盖多个家族,但这不是现代超大模型或自然语言多轮记忆的直接证据。
来源证据N=2/3时模型区分匹配与诱饵的中位AUC为0.63/0.58,最佳深度探针为1.00/0.98。漏报中注意力离开目标的中位比例为16%/7%,诱饵误报却有91%–96%偏向邻行。 §4、图3、表5:定位和探针 ↗
我的解读可线性解码不等于模型实际使用;漏报和诱饵误报必须分别解释。
来源证据剔除2个基线d′<0.3的单元后,43个模型×负荷单元中42个受益于半强度干扰抑制,中位增益+0.60;前3头τ=0.67锐化仅+0.05,随机子空间−0.03,移除目标中位−1.54。 §5、图4、表3:干预 ↗
我的解读方向性因果对照强于相关探针;42/43不是所有条件都提高,也不是准确率提高60个百分点。
来源证据单层位置间隔与诱饵误报相关ρ=−0.03,不支持一个具体精度预测;两层残差模型在各N上d′可达4.5–7.8,结果随位置编码而异。 §6、附录A/C:边界 ↗
我的解读作者保留不支持的理论预测;不能简化为softmax无关或两层必然解决任意工作记忆。
开放情况与使用许可
论文与原图为CC BY 4.0;本次全文未找到可确认的作者实现或新检查点发布链接,不能把所用公开基础模型等同于本研究实现已开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
用同一任务上的定位、解码与干预三条证据定位故障,比只展示注意力图更有解释力;随机子空间与抑制目标对照有助于排除一般性扰动效果。
反方 · 哪些结论还不够
只有合成字母N-back;先前答案为真值,目标位置预先已知;最佳层探针不代表可部署读出器。最大14B,任务在更大模型中更分散。理论模型不解释半强度为何优于全抑制,也未证明与人脑存在相同机制。
综合判断
这是可复用的机制诊断设计,而非已经验证的长上下文增强算法。对产品的启发是评测“信息存在但未被决策使用”,而不是仅增加检索命中率。
我会先做的验证
未执行的验证方案:在固定上下文预算下加入真实文档干扰、取消此前真值答案,并用独立验证集选择探针层和干预强度;比较定位准确率、回答准确率和错误类型,同时测试不提供目标位置的可部署替代方案。