世界模型接入VLA:预测什么、接在哪里,结论会翻转
未来预测监督为什么有时提高机器人成功率,有时却破坏原有策略?
研究把四种未来预测接入方式、六类表征及两类骨干放到共享训练协议下比较。DINOv3等语义表征较稳健,解耦未来专家常有优势,但加入世界模型不保证每项任务变好;这里预测的是演示轨迹下的未来视觉特征,不是任意反事实动作的完整模拟器。
图解主要方法
未来预测监督为什么有时提高机器人成功率,有时却破坏原有策略?
- 1
固定基础策略与预测目标
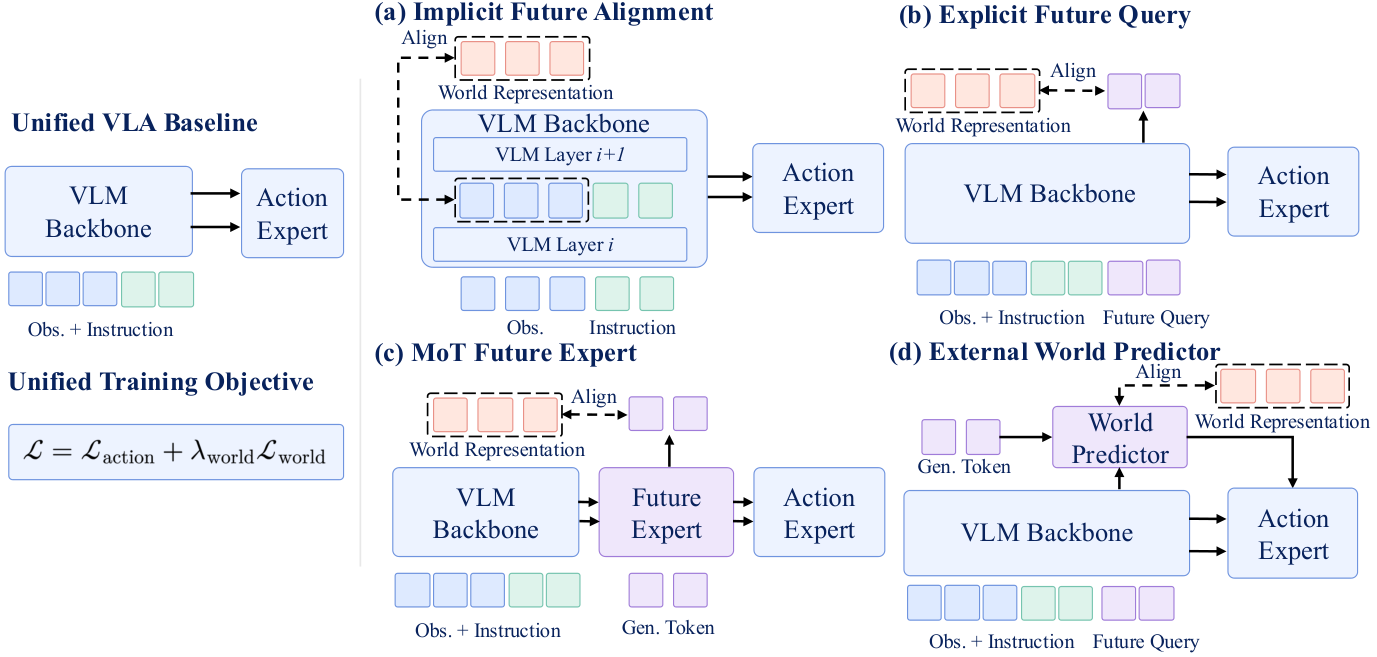
图2左侧使用视觉语言骨干和交叉注意力动作专家,通过流匹配预测动作块。冻结编码器提取t+4、8、12、16四个未来时刻的监督表征,训练损失为动作损失加0.1倍余弦世界损失;编码器覆盖像素、2D语义、3D几何与视频动态。
- 2
直接约束骨干或添加查询
图2(a)在视觉中间层上增加投影头与未来特征对齐,部署丢弃投影;(b)加入16个未来查询,动作头读取它们,训练时解码稠密目标,部署丢弃解码器但保留查询。二者较省推理计算,却直接改变共享表征。
- 3
把未来预测解耦为专家
图2(c)增加28层未来专家,64个生成token由当前DINO特征初始化,只读取VLM,动作专家逐层读取未来专家;(d)采用12层外部预测器,由8个查询通过AdaLN调制,动作头只读取预测结果。两者推理时保留预测模块和视觉编码器。
- 4
用消融分开额外输入与预测监督
解耦方式同时新增当前编码特征与未来损失,因此更换编码器会同时改变两者。附录比较同样架构下无世界损失、当前帧目标和未来帧目标,并做当前/未来编码器交叉组合,避免将额外视觉输入的收益全部称为“预测能力”。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据Qwen3-VL-2B配置50k步、8张H100,LIBERO每模型2000回合、Plus10030回合。三种子基线71.4±0.4、WM-MoT76.4±1.0;同架构单次消融无世界损失73.6、当前目标74.0、未来目标76.2。 LIBERO-Plus:主配置与三种子复核 ↗
我的解读我的解读:未来监督的贡献有受控证据;跨范式容量与算力仍不相同,不能把整个差值归因于单一机制。
来源证据RoboTwin三种子Clean2Clean:基线69.0±0.8,直接对齐63.5±1.5,MoT71.4±1.1。较小损失权重可减轻直接对齐退化,已测范围仍低于基线。 预训练π0.5出现负迁移 ↗
我的解读我的解读:不能从Qwen骨干的收益直接推广到机器人预训练骨干;两套系统还同时有容量、视觉编码器与动作头差异,不能单独归因于预训练。
来源证据25% LIBERO数据下查询式70.1低于基线84.9。Franka四任务每项50演示、40评测,MoT平均73.8对基线45.0;单H100四步流解码端到端延迟136.1ms对103.3ms。 数据量、实机与推理成本 ↗
我的解读我的解读:低数据时查询瓶颈可能适得其反,真实收益伴随在线计算开销。DOMINO最好成功率仅15.5%,不能包装为动态操作已解决。
开放情况与使用许可
论文CC BY 4.0,作者项目页可访问并提供实验展示;本次项目页未给出可核实的方法代码或权重下载,不计作开源。
LICENSECC BY 4.0(论文与所引原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:这类统一框架比较比堆叠新模块更能指导实际选型,尤其暴露未来监督对既有机器人表征的干扰。
反方 · 哪些结论还不够
共享超参数不等于各方法分别调优后的上限,推理容量不同;大表主要单种子、关键结论另有三种子;真实任务只有四项。
综合判断
可优先把语义未来专家作为候选方案,再按实际延迟和示范量选型,不应默认更精细3D表征或更多未来token一定更好。
我会先做的验证
未执行的验证方案:在目标机器人上固定示范、训练GPU时和在线延迟上限,复测四种接法;把当前特征与未来目标分别置换,评估低数据、运动目标与语言扰动的独立收益。