XConf:用过去答错的记录校准今天的自信
回顾补收:独立评分、经验检索与再次反思
XConf 先记录回答时的自我反思,再以外部评分建立经验库。新任务同时读取相似经历的命中率与具体失败教训,从而调整置信度;LLM 参数冻结,但检索几何仍使用带标签的历史拟合。
图解主要方法
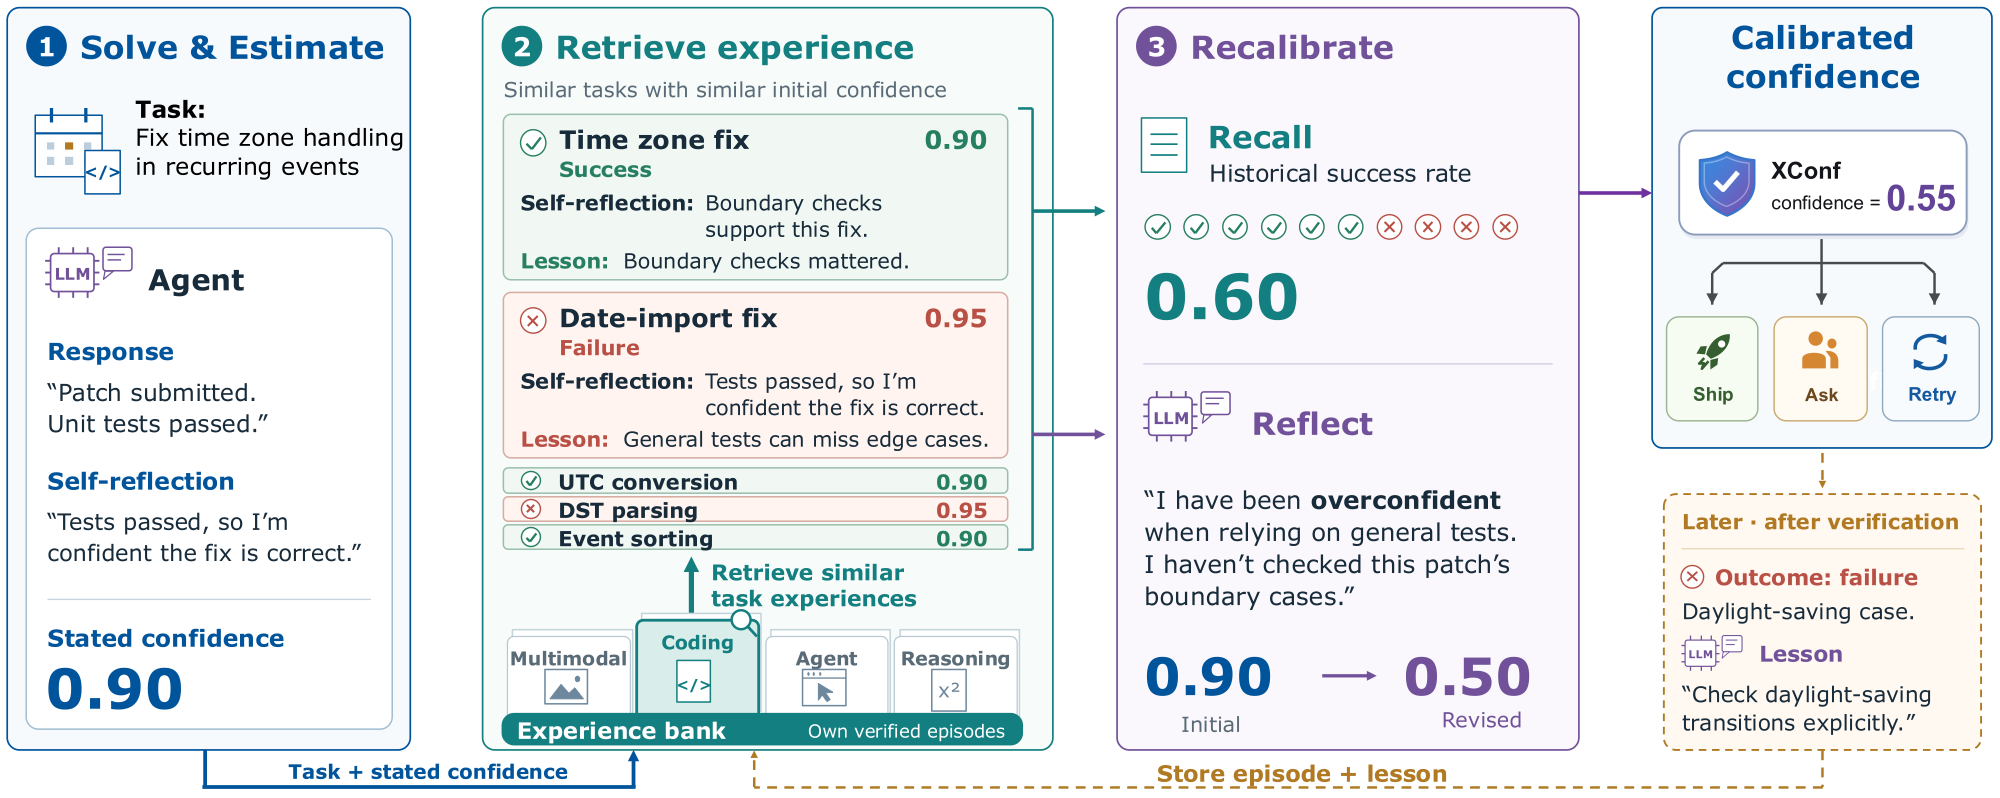
图 1 如何避免把当前答案的评分提前泄露给置信度估计?
- 1
先回答和反思,再取得评分
当前任务产生答案、反思和初始置信度,此时不知道真值;外部评分之后才能补写教训并进入经验库。评分后的教训不用于当前任务的检索键,保持回答前后信息的边界。
- 2
Recall 按相似经历计算命中率
最小键由任务嵌入与初始置信度组成;完整实现另含反思嵌入和长度。每折仅在训练数据拟合 PCA 与逻辑探针,以探针绝对权重缩放特征,再做余弦检索,取 50 个邻居并按置信度差异加权。LLM 不微调不代表没有标签监督。
- 3
Reflect 阅读具体失败案例
向模型展示最近邻经验卡、评分和事后教训,要求先识别反复出现的失败模式,再重估当前答案的置信度。冻结提示使用八张卡,不能把检索的 50 个邻居都理解为进入提示;最终与 Recall 等权平均。
- 4
把排序能力与校准误差分开
AUROC 衡量对错排序,ECE 衡量置信度与频率的一致性;将所有分数压到平均正确率就可能降低 ECE,却破坏排序。因此报告同时检查 AUROC、风险覆盖和 Brier,弃答后的准确率还须配合覆盖率。
- 5
区分离线折分与真实时间流
主实验随机五折,保证当前题不进自己的库,但不是严格时间先后。附录 H 另按 LiveCodeBench 比赛月份做只用过去的滚动实验。经验可以逐步积累;模型升级后自身错误模式漂移,旧记录需要重新验证。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【九基准、四模型】六类推理任务的 24 个比较中,相对十次自一致性,作者报告 21 胜、2 平、1 负;主要模式关闭思考。 主表与附录 A/K ↗
我的解读我的解读:这不是所有任务绝对占优;智能体任务没有同样的十次投票对照,代码一致性也用代码相似度而非重复执行结果。
来源证据【独立评分】弱独立评委与真值一致率约 0.911,经验库仍有帮助;模型自己的伪标签则会把自信错误再写成成功。 附录 C ↗
我的解读我的解读:收益依赖可获得的独立反馈,不能由自我反思闭环无成本替代。
来源证据【时间顺序】经过 150 条热身,四模型滚动 Recall 比同题随机五折下降 0.006–0.020 AUROC。 附录 H ↗
我的解读我的解读:支持在这一代码任务上按时间积累;不能据此宣称所有领域漂移已解决。
来源证据【成本】最大库 11999 条,CPU 检索约 0.20 ms;嵌入请求中位 570 ms,Reflect 另一次模型调用。 附录 L ↗
我的解读我的解读:“一次回答生成”不等于一次总 API 调用,历史评分、键拟合与建库成本也要计入。
开放情况与使用许可
已读完整正文及附录 A–N;未在论文中确认本研究的正式实现或经验库下载入口。上游模型及嵌入服务不是 XConf 开源制品。
LICENSE实现、经验数据及服务条款分别待核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将置信度连接到独立验证的历史错误,使重试和人工复核有了可审计的依据。
反方 · 哪些结论还不够
主实验主要是随机折分和同模型历史;标签获取、冷启动与模型版本漂移仍限制部署,等权反思在部分任务反而不如纯 Recall。
综合判断
适合有可验证反馈的长任务系统;先把置信度用于分配复核预算,不能当作正确性保证。
我会先做的验证
未执行的验证方案:严格按上线时间构建库,在模型升级前后分别测风险覆盖、Brier 与错答漏检;将评分、嵌入、反思和重试全部计费,比较独立评委与自评伪标签。