Xiaomi-Lens-0:让语言模型回答它指的是哪些像素
共享视觉编码器的掩码输出,如何与文字推理对齐?
Lens-0在Qwen3.5-4B上增加轻量掩码头,将定位、分割和细粒度问答合在同一模型。它利用语言上下文决定分割对象,但掩码本身没有重新作为视觉输入送回语言模型,不能等同于主动放大观察。
图解主要方法
共享视觉编码器的掩码输出,如何与文字推理对齐?
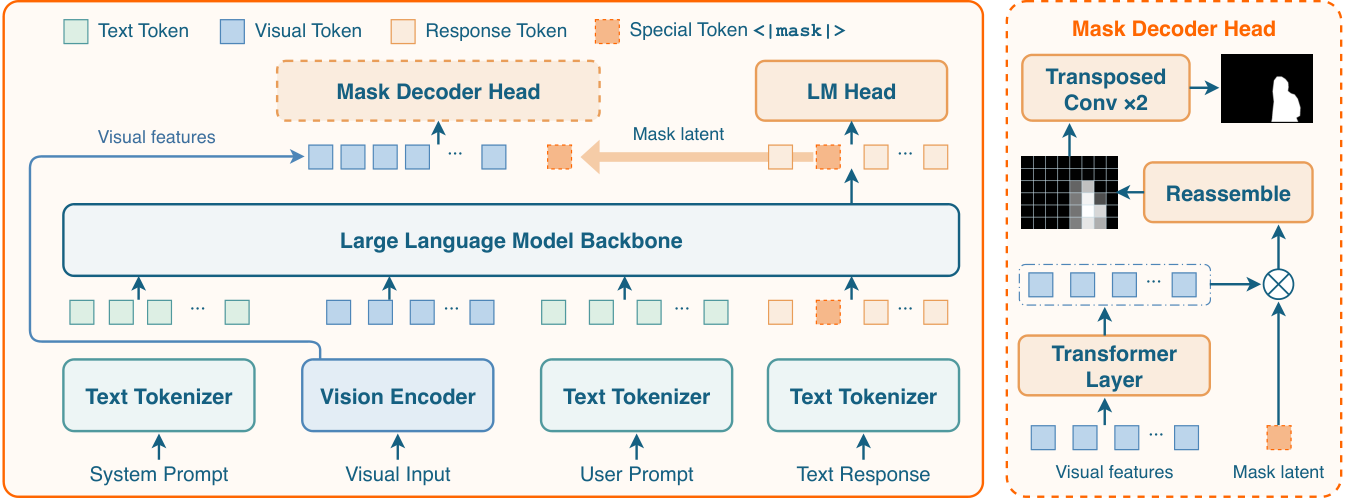
- 1
保留合并前的空间特征
图2左侧视觉编码器既供语言模型使用,也保留细粒度patch网格。掩码头只对整幅图计算一次共享Transformer特征,避免为每个目标重跑视觉编码器。
- 2
用语言状态查询目标
语言流生成特殊mask token,其上下文化隐状态经过投影,与patch特征进行兼容性计算,再重排为二维响应并通过两层转置卷积上采样。不同mask token可以对应不同对象,文字推理决定查询,像素头负责边界。
- 3
分阶段学习联合接口
第一阶段冻结主干训练解码头;第二阶段解冻,以文本预测、BCE和Dice共同训练。合成问答经过重新定位核查,LensBench完整单元人工复核;主结果是三个检查点平均,不是三个独立训练种子的置信区间。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。另核对v2正文修订,原图和主讲解引用v1。
来源证据8个REC划分平均提高5.6点;RES为81.4,对QwenSeg为78.6。 技术报告:定位与分割 ↗
我的解读说明联合接口有效,但框监督已贡献较多增益,不能把全部进步归因于掩码。
来源证据显式指代cIoU71.4、隐式54.7;通用部分63.9低于Qwen的74.2。 LensBench:1200组配对单元、4800指令 ↗
我的解读隐式语义和非专门任务仍有明显边界,并非全能视觉升级。
来源证据加入mask后感知约增0.2–1.4点,推理定位增0.1–0.6点;计数43.8升50.6。 消融与细粒度计数 ↗
我的解读增益存在但量级有限,计数仍接近一半不正确;没有mask反馈或裁剪闭环,不宜宣称获得主动视觉搜索。
开放情况与使用许可
官方GitHub含实现、Apache-2.0许可;Hugging Face模型卡声明Apache-2.0,实际列出3个safetensors分片。论文CC0与模型许可分开,第三方组件仍遵守各自条款。
LICENSE论文 CC0;代码与模型 Apache-2.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同一语言上下文输出文本与像素级对象,有利于把视觉问答的指代变成可检查结果。
反方 · 哪些结论还不够
隐式对象、多个同类目标与计数仍困难,合成数据验证不能保证全部正确;未给出完整工业数据成本。
综合判断
适合作为可定位视觉助手的候选底座,仍须单独验收语言答案与分割边界。
我会先做的验证
未执行的验证方案:对真实资产和机器人视角建立人工mask真值,分别测文字正确率、指代IoU和误选目标率,并比较框监督、mask监督及真正的裁剪反馈。