Youtu-Parsing-Omni:把图像、声音和视频变成可追溯记录
同一个感知编码器怎样同时读页面与定位音视频事件?
5B 解析模型把十类任务统一为带空间框或时间戳的 JSON。重点不是让模型多说几句,而是先把原始媒体转成可供文本智能体重复检索的证据记录;总分提升不能掩盖转写与几何关系上的退步。
图解主要方法
同一个感知编码器怎样同时读页面与定位音视频事件?
- 1
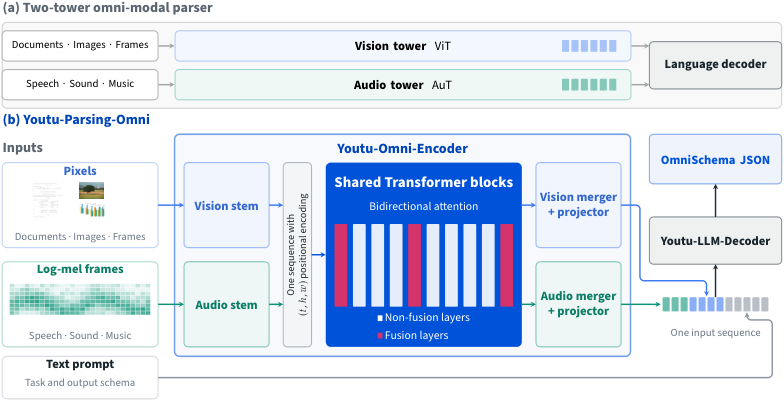
图3:共享的是感知主体,不是取消模态差异
图像切块与音频 log-mel 分别经过轻量输入层,再进入共享双向 Transformer。视觉与声音仍有独立的合并器和输出投影;共享主干由文本模型初始化,以已有符号能力辅助读字。单独的语言解码器生成解析记录,输出仍是文本。
- 2
把时间对齐放到编码阶段
位置编码分配 T/H/W 频率段,图像使用帧与空间坐标,音频使用时间而令空间坐标为零。少数融合层在短音视频窗口中跨模态交互,其余层分别处理帧或音频块;长时间依赖仍交给解码器。空间框归一化到0–1000,时间戳只有秒级,不能当作采样级同步。
- 3
先学合法格式,再纠正自己生成的内容
四阶段预训练后依次进行 SFT、按任务路由的 GRPO 奖励和 OSAD。OSAD 让学生在自己的输出前缀上学习,同一初始模型的冻结教师额外看到参考答案;内容 token 用 JS、结构 token 用前向 KL,并有全 token 项。仅通过 JSON、框语法与重复检查的轨迹进入蒸馏。
- 4
六轮更新教师,但没有凭空产生新真值
每轮只训练学生 LoRA,轮末合并权重并刷新教师,再给学生新适配器。参考解析一直只进入教师,学生推理时没有参考答案;这属于有参考数据的自蒸馏,不是无需标注的自主知识发现。
实验与证据
已阅读正文、训练方法及关键评估协议与消融,核对实验条件与原图;未独立复现。
来源证据OmniDocBench v1.6 的1651页得96.96,另一系统96.91;OmniParsingBench用作者工具重评,平均75.08对Logics的72.26,Gemini为77.44。文档基线多取排行榜,不能称所有基线均在同一机器重跑。 表1–4:数据集与评分协议 ↗
我的解读0.05分的文档领先没有多种子显著性支持;真正值得跟踪的是统一输出及音视频分项,而不是榜首标签。
来源证据音频 ASR 项77.94低于比较系统,几何总分74.33低于Logics的76.34;ChemOCR实际计分990例,指纹完全匹配54.2;乐谱800张,CER22.73优于LEGATO23.30,但SER/LER较差。 表8–12:精确转写仍有明显边界 ↗
我的解读指纹相同不是逐字符SMILES完全相同;合法JSON也不意味着字段可靠,临床、化学与乐谱用途需要独立校验。
来源证据控制编码器试验在300B训练token下,文本初始化比随机初始化OCRBench高130.6,但BLINK低9.5;OSAD六轮贡献SFT后1.99分中的1.75。 图8–9:初始化与后训练消融 ↗
我的解读读取符号的优势并未同步转化为空间关系优势;消融设置不等于全规模训练的因果归因。
开放情况与使用许可
官方HF可见模型权重与模型卡,链接TencentCloudADP/youtu-parsing的omni推理实现;采用自定义Youtu-Parsing许可,并非仅凭公开下载即可认定宽松开源。完整训练数据与训练复现范围未确认。 已读取LICENSE:含欧盟地域限制,属于带额外限制的自定义授权,不能写成Apache/MIT式开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
统一锚点记录有助于智能体把结论返回原始区域或时间段核查,且论文提供了跨模态分项和训练阶段消融。
反方 · 哪些结论还不够
评估包含修复后的解析率、不同来源排行榜与作者评分器;秒级时间戳、ASR和关系推断不足,尚未验证真实智能体全流程收益。
综合判断
值得作为可审计感知层试验,不能以“统一”替代每个任务的准确性和成本评估。
我会先做的验证
未执行的验证方案:固定包含重叠说话、密集公式与几何图的100份材料,分别统计原始JSON合法率、修复率、锚点误差和字段事实错误,并比较重复查询时的总时延与token成本。