zip2zip++:动态合并 token 后,如何少损失推理能力
容错编解码、数字保护与位置对齐共同修复动态词表接口
在已有BPE之上用LZW建立输入相关的超token词表,一步可生成多个基础token。新工作针对动态词表破坏输入输出几何、位置和字典同步的问题逐项修复;压缩率与模型质量仍存在明显取舍。
图解主要方法
容错编解码、数字保护与位置对齐共同修复动态词表接口
- 1
把输入与输出的超token编码器解耦
LZW词典前缀闭合,同一输出位置的候选经常共享首token,输出向量因此偏重前缀;输入表示却应较均衡保留各组成部分。分别训练两个编码器,避免一套参数同时承担冲突的几何目标。
- 2
从预训练向量平稳起步并保留跨度位置
超token向量等于首token嵌入加零初始化残差,防止随机编码器输出尺度冲击。RoPE取该跨度最后一个基础token位置,使未合并token的相对距离不被前面压缩连带改变;主配方使用无参数末端索引。
- 3
容许模型漏合并,保护脆弱数字
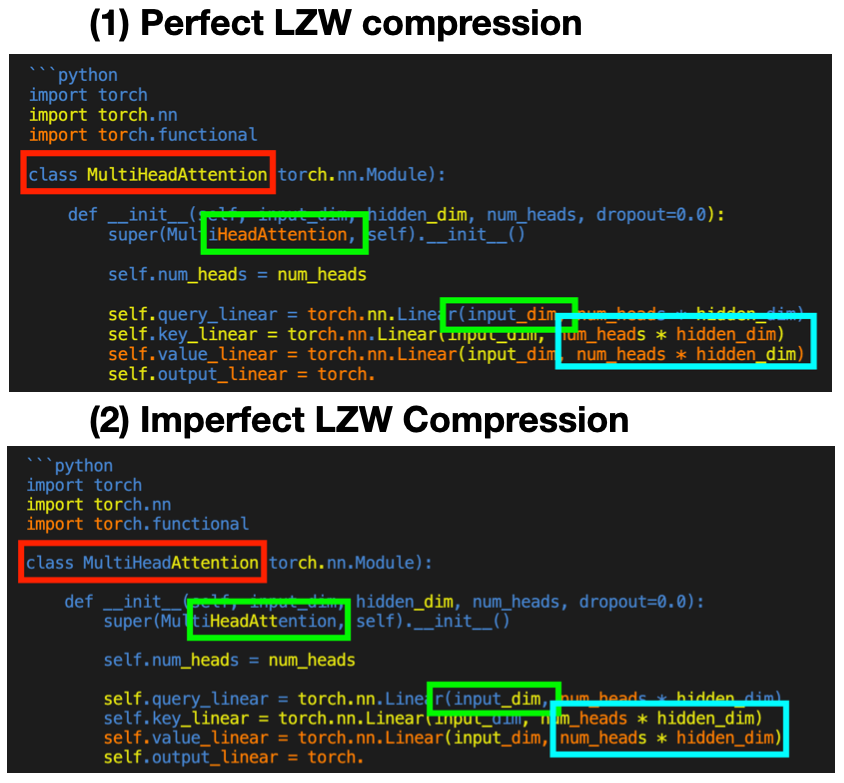
图4c上下是同一代码的不同合并方式,文本可以相同而编码路径不同。FT-LZW仅在新组合尚不存在时插入字典,遇已有组合继续吸收,避免漏合并导致重复插入和字典错位;数字及特殊token直接输出并重置缓冲。
- 4
将等价分词概率相加,但限定评估范围
对目标超token的所有合法展开路径求和,树形注意力隔离兄弟分支。它对固定规范前缀下的当前目标精确,不是对全文所有前缀分词全局边缘化;更宽松的首token上界会夸大质量恢复。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据四模型LoRA rank32、8000步、每步32768解码位置、2048窗口,4张H100。未压缩约见262M基础token,压缩约375M;压缩率超过2的约6.5%窗口被过滤。 附录C、D.7 ↗
我的解读对照只匹配更新数,不匹配基础token、可训练参数或保留窗口;没有同过滤窗口的未压缩对照,存在数据混杂。
来源证据Phi-3.5 GSM8K由旧配方0.36到0.68,未压缩0.75;生成压缩由1.53倍降到1.25倍。WikiText少14%token,短多选提示仅少约7%。 表3、表8–9 ↗
我的解读质量恢复部分来自少合并数字,不能宣传无代价40%通用节省;论文未测墙钟解码速度。
来源证据14B HumanEval旧配方0.36、新0.31、未压缩0.57;IFEval0.43、新0.40、未压缩0.49。长上下文用推理期LongRoPE,未做长上下文训练。 表3、附录D.8 ↗
我的解读改进集中于数学与困惑度,代码和指令遵循未显著恢复;不能把小困惑度当作整体质量等价。
来源证据GSM8K优先抽取####后的数,否则最后数字;严格格式分明显更低。第二训练种子少1.8点;精确多视图只解释29–36%规范评分差距,首token上界则会误显74–97%。 附录C.2、D.3–4、F ↗
我的解读分清算术正确与格式遵循,也应避免把不到两点的单种子阶梯增益当独立显著发现。
开放情况与使用许可
官方仓库含训练评估目录与发布工具,主训练代码和Rust压缩库MIT,运行时子模块Apache-2.0。README列出四套检查点及hf分支,但模型文件页本轮访问失败,权重与底座许可需逐项复核,未独立运行。
LICENSE论文 CC BY 4.0;主代码 MIT;子模块与底座分别适用自身许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
针对词表变更的接口问题给出可检验的机制和负结果,容错字典尤其贴合神经生成不遵循贪心压缩的实际情况。
反方 · 哪些结论还不够
保留明显代码、格式和上下文质量损失,保护数字降低压缩收益;训练数据过滤与预算不完全匹配,额外编码器和codec成本未做速度实测。
综合判断
是动态词表适配的扎实工程改进,尚未实现质量无损或实测端到端提速。部署应同时看生成质量、实际基础token压缩和耗时。
我会先做的验证
未执行的验证方案:固定相同基础文本与过滤窗口、总FLOPs和多种子,对比分词质量、严格格式、KV显存、首token及逐token延迟;对数学、代码与多语言分别测,而非只报平均压缩率。