3DCodeVerse:把3D内容写成代码,再用几何检查推动修订
规模统计、执行成功和资产质量为什么必须分开看?
3DCodeVerse整理可执行三维程序,并用规划、构建、测量、渲染和修订形成反馈流程。附录明确“2M”是约203万导出行,目录约27万个唯一程序;训练提高可执行率,但运行成功仍不是可交付资产质量。
图解主要方法
规模统计、执行成功和资产质量为什么必须分开看?
- 1
01 · 统一程序与执行环境,但不混淆数据单位
将CAD序列转CadQuery、内联专用函数、打包源文件与资产,保留来源和检查记录。目录269597个程序、训练768596对、统一导出2028286行属于不同层级;同一程序多种描述和多pass着色器展开会增加行数。
- 2
02 · 把空间计划映射为文件与部件
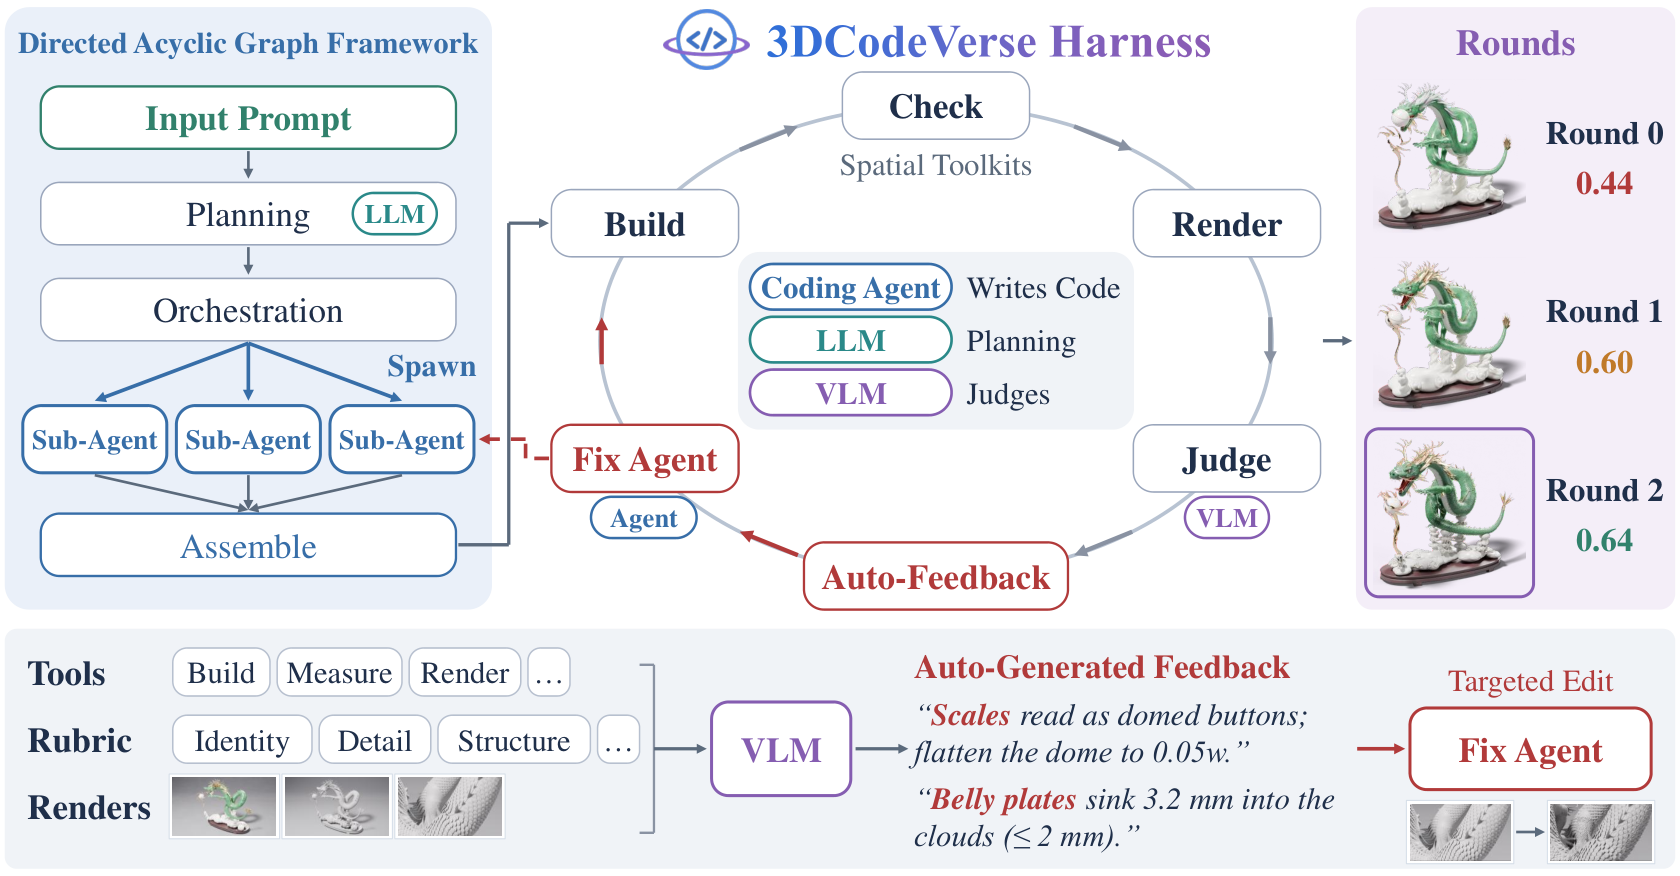
图3先规划尺寸、材料、连接和验收条件,再按依赖图分配文件范围,独立部件完成后装配。关节资产同时需要网格与URDF,验证静止姿态坐标一致,再在多个关节位置检查碰撞;代码可编辑性来自这些显式结构。
- 3
03 · 构建、测量和视觉判断分工
构建失败先修程序,几何工具返回部件间隙、碰撞和尺寸误差,并将修正向量转回作者坐标系。VLM只看请求、渲染和测量,不看生成者推理;确定性检查可以限制评分,防止好看的视图掩盖已测出的结构问题。
- 4
04 · 保存版本并从已验收候选中选择
修订先处理几何错误、必需条件,再处理外观建议;一般最多4轮、60分钟,保存源代码、渲染和日志,再选择评分较高版本。轨迹也可用于SFT/DPO,但数据集中并非每个来源都通过同样的视觉与几何门槛。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据目录约27万个程序主要来自DeepCAD与Shadertoy;约203万是多描述和多表示导出行。数据整体CC BY-NC-SA 4.0,来源还有逐项约束。 附录B:规模与许可 ↗
我的解读不能宣传成203万个唯一3D资产或无条件可商用程序;代码框架Apache-2.0与数据权利不同。
来源证据805个固定任务、温度0.7单种子;9B在3DCodeBench执行0→84.9%,27B为51.9→92.9%。9B原始失败大量来自Blender5 API漂移;27B无条件F(阈值0.05)从0.214升到0.374。 表2、附录C4:执行与形状 ↗
我的解读部分收益是API及输出格式适配;失败计零后几何均分也受执行率驱动,不能全归于空间理解变强。
来源证据60个对象提示中Flash加流程评分86.6、原生61.3;执行100%对93.3%。平均API等价成本约3.312美元对0.035美元,评测调用另计。 附录C3与表7:效果和资源 ↗
我的解读不是等预算对照;人类90%偏好是特定Claude Design比较,不能描述为所有任务成功90%。主文100提示与不同附录30/60子集需要分别理解。
来源证据部分Sonnet图形任务平均评分下降,6对重复生成分数差标准差0.202。12例机器人场景几何轮廓检查代码12/12、UWM7/36,而静止末帧同样12/12。 附录C–D:反例与边界 ↗
我的解读流程不是每种模型和任务都改善;轮廓保持不能单独证明动态预测或交互物理更正确。
来源证据主表9B SFT的Three.js执行74.5%,附录列出的270K混合模型为32.5%,未见两者清晰对应说明。 附录表2与表10核对 ↗
我的解读该具体数字存在配置/表格口径未解问题,本站不把74.5%作为可复现统一结论,建议以公开配置逐项重测。
开放情况与使用许可
2026-10-18已核对GitHub目录含harness、toolkits、finetune与eval实际实现,代码Apache-2.0;HF有大量parquet/tar等实体和申请访问字段,数据CC BY-NC-SA 4.0且逐来源许可仍适用。未下载全量数据或验证每条程序,未确认所有微调权重发布。
LICENSE论文原图 CC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
可执行源代码、几何反馈和版本轨迹把资产生成变成可检查流程,关节扫描及坐标修正比只做VLM美观评分更具工程意义。
反方 · 哪些结论还不够
计算投入明显增加,部分指标存在配置口径问题;确定性门槛也有限,可能误否决视觉缺陷。未系统检验UV拓扑、纹理接缝、PBR交换、去光照和引擎重光照,代码能跑不等于生产资产验收通过。
综合判断
值得借鉴的程序化3D数据和验证框架;必须按来源、执行层、几何层、外观层分别验收,并用成本匹配比较判断收益。
我会先做的验证
未执行的验证方案:固定模型和费用上限,在相同Blender版本对比单次、等预算多候选与闭环修复;导出GLB/URDF后检查独立部件、关节碰撞、UV、PBR通道和不同引擎重光照,重复多种子并公开失败率。