AIM:世界模型不听动作,可能是训练数据太像专家
只收成功示范,是否让模型学会忽略控制指令?
专家总在特定状态选择相似动作,世界模型可以靠状态猜未来而不用理解动作。AIM主动收集能揭示动作影响的转移,用更有区分力的数据改善可控性,而不是单纯扩大模型或继续堆专家示范。
图解主要方法
只收成功示范,是否让模型学会忽略控制指令?
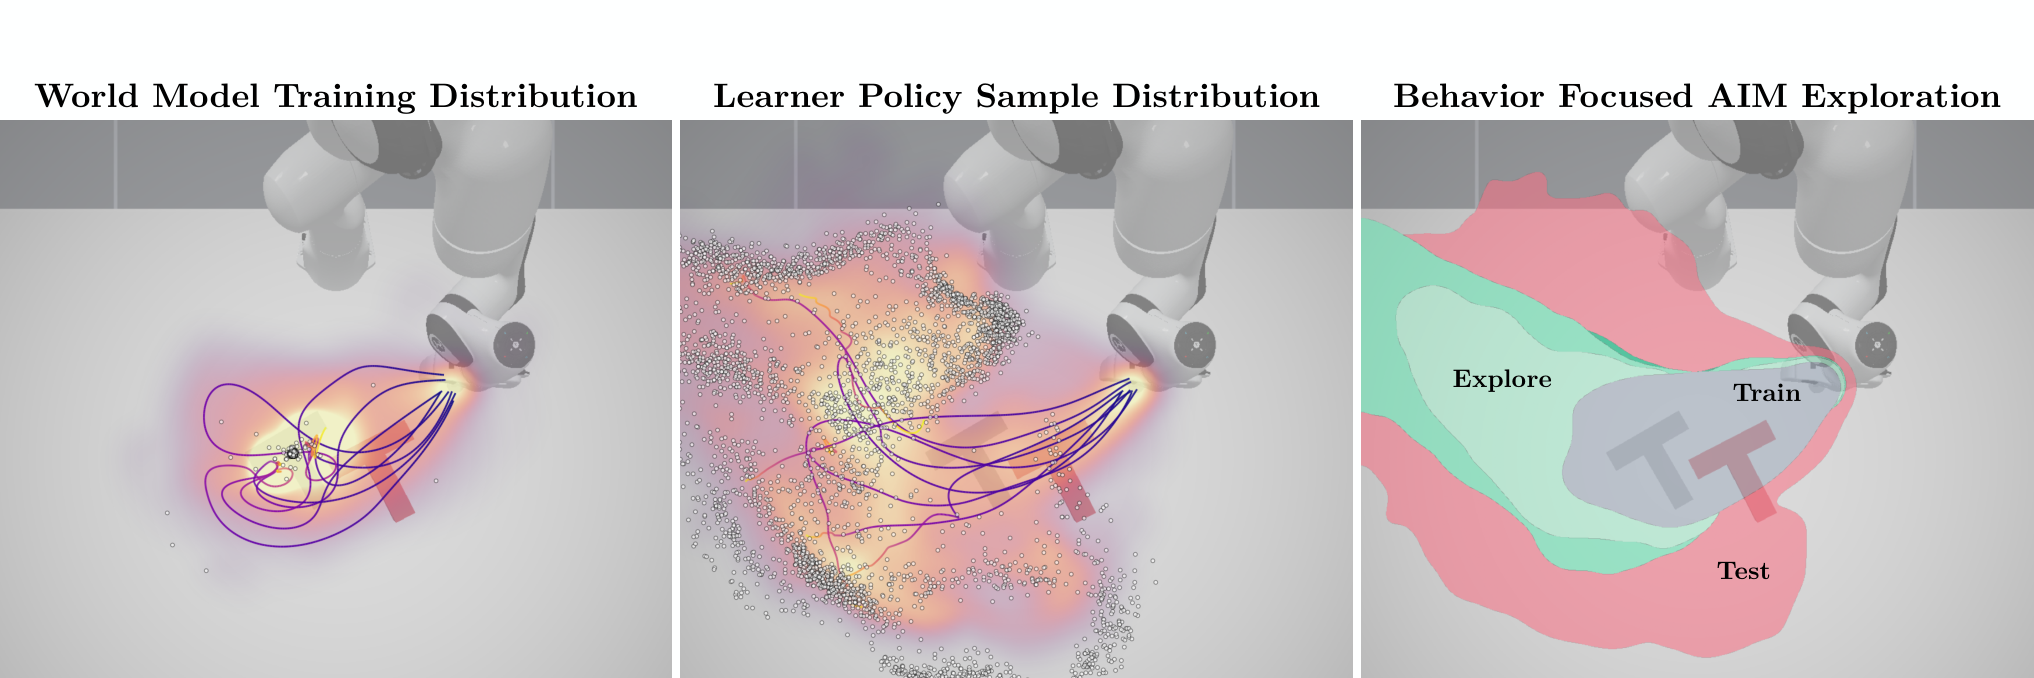
- 1
先定义动作信息瓶颈
用给定状态后动作与后继状态之间的条件互信息,刻画数据中动作影响。在相应分布与正则条件下,数据给模型可表达的动作信息设定上限;这不是对任意分布的一般性能保证。
- 2
图2:用密度比寻找值得做的实验
逆动力学密度log q(a|s,s′)减行为密度log β(a|s),奖励能从结果辨认的动作;再加目标状态与采样状态密度比,使探索兼顾目标范围和覆盖。
- 3
收集—重估—再优化
每轮收新回合后重拟合流密度模型,冻结并给回放转移重新打分,再用IQL和优势加权策略学习。密度散度自蒸馏减少似然计算负担,但仍带来训练成本。
- 4
固定世界模型检查数据贡献
相同环境使用相同世界模型架构与训练日程,仅改变数据来源;用未跟随专家的策略评测动作响应,而不只看正常成功视频是否流畅。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据约3K专家回合加500个AIM回合,在特定H=10末端控制指标上匹配300K专家回合,约85倍回合数差。 §4 Push-T 数据效率 ↗
我的解读这是指定指标的数据量比较,不是85倍算力节省或所有物体交互都达到同等效果。
来源证据BC联合召回由.203到.344;但BC Failure的.411仍低于300K专家的.432,Push Away的.165低于.198。 Table 1,H=33 ↗
我的解读不同分布收益不同,反常行为与物体响应仍未被完全覆盖。
来源证据每数据/规模/分辨率只训练一个模型,100轨迹×3推理种子用于bootstrap;部分消融在特定指标优于完整方法。 Appendix 10、消融 ↗
我的解读置信区间反映评估波动,不包含重新训练方差;不能称所有组件在所有任务必需。
开放情况与使用许可
官方GitHub仅README与展示文档,明确Code coming soon;本次未发现训练实现或权重,不标开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将“动作可控性”定位到数据覆盖与因果区分,适合诊断只会播放合理视频的世界模型。
反方 · 哪些结论还不够
验证限于模拟导航和Push-T;密度估计、评价分布假设、探索成本及真实机器人风险仍待验证。
综合判断
数据采集目标具有解释力,但85倍应始终带上回合数、H=10和末端指标限制。
我会先做的验证
未执行的验证方案:在固定采集与训练预算下比较专家、随机恢复和AIM,分别测机器人及物体响应、长时反事实动作,以及密度重训耗时。