ActionSplice:在视频采样中途改动作,不必全部回滚
把旧动作留下的中间状态搬到同一步的新动作状态
交互视频生成到一半时收到新动作,直接改条件会留下旧动作的中间状态,重启又浪费计算。ActionSplice 训练小型状态修正器,将被打断的求解器状态迁移到同一步的反事实状态,再继续冻结骨干的剩余采样。
图解主要方法
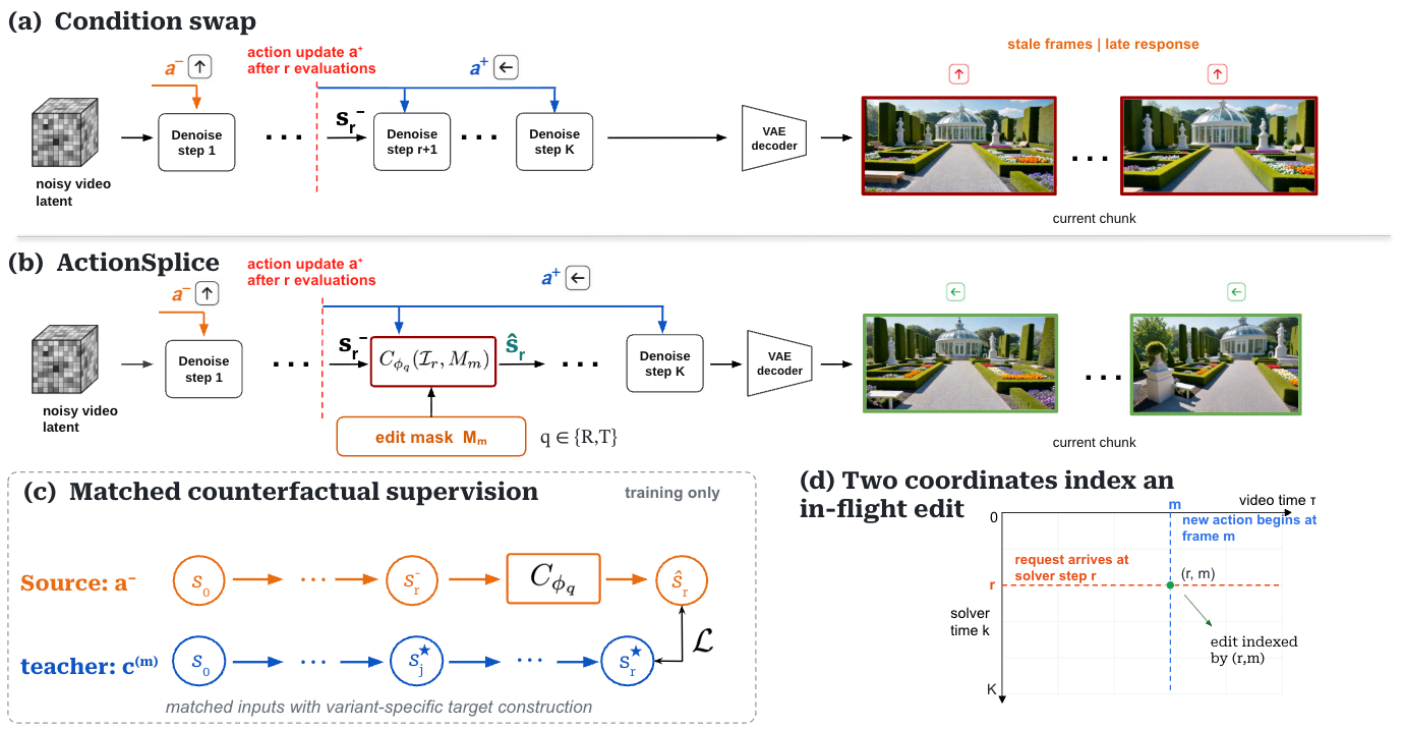
图 1 的求解步 r 与视频时间边界 m 为什么是两套不同坐标?
- 1
用匹配回滚构造反事实监督
图 1C 固定初始噪声、历史和其他条件,只把动作替换后重新采样到第 r 步,得到教师目标。旧动作第 r 步状态与这个目标构成训练对。这个反事实来自同一生成模型,不是物理环境真值,也不自动保证新动作对应的运动正确。
- 2
训练小型传输器,而非微调整个骨干
六块 3D FiLM 修正器读取旧状态、新动作等条件,预测同一步目标;每个骨干、每种修正方式分别训练。minWM 预测干净样本再结合保存噪声恢复求解状态,HY-WM1.5 则直接修正 Euler 状态,不能混用接口。
- 3
选择整块重定向或仅改时间后缀
CST-R 修正当前视频块,CST-T 按 m 的掩码只修改后缀。r 表示扩散/flow 已经计算了几步,m 表示视频从哪帧开始响应新动作。掩码只保证传输当下的潜变量前缀不动,后续采样与 VAE 解码仍可能改变最终前缀像素。
- 4
丢弃过时动作缓存,再完成剩余采样
传输之后保留应保留的历史状态,清掉依赖旧动作的临时缓存,再执行剩余 K−r 步;部署不运行教师回滚。节省的是被重复执行的采样,不代表取消解码、缓存维护或已经输出帧的不可逆性。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【训练与测试】每个骨干/变体 K=4、r=2;150 提示分为 120/30,一个固定种子,训练捕获 360 条、测试 90 条;动作类型与方向有限。 数据及配置附录 ↗
我的解读我的解读:足以观察同一步迁移,但规模和分布有限,不能推出任意时刻、任意新动作都可稳定中断。
来源证据【HY-WM1.5】CST-R 相对直接换条件的 LPIPS 从 0.3446 降到 0.0831,像素输出时延约 7442ms,对不打断整体参考约 11711ms 为 1.57 倍;CST-T 后缀 LPIPS 0.2731→0.0615,时延约 6941ms。 表 1、表 2 及计时口径 ↗
我的解读我的解读:LPIPS 更接近匹配回滚参考,不是更符合真实物理;数秒级输出也不能直接叫实时交互。
来源证据【泛化边界】更晚 r=3 的一组 LPIPS 为 0.2694;训练三次中断、测试五次的补充结果只能支持有限重复干预。 中断位置与重复干预消融 ↗
我的解读我的解读:接近结束时剩余纠错空间更小;还需在独立种子、动作幅度和长序列中测误差累积。
开放情况与使用许可
09-08 首发。官方仓库有核心修正器、采样接口、训练配置和测试;README 明确仓库不含 checkpoint。论文所列 Hugging Face 地址本次返回 401,未确认可下载正确器权重;上游骨干需另取。
LICENSE实现为 Apache-2.0,上游 minWM/HY 代码与权重分别授权;论文图 1 为 CC BY 4.0。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
明确区分视频时间和求解器时间,将交互中断转化为局部状态校正问题,具有清楚的接口和可复核对照。
反方 · 哪些结论还不够
教师目标继承骨干偏差,正确器按骨干和变体专门训练;前缀潜变量保护不等于最终像素绝对不变。
综合判断
适合研究动作变化时的计算复用,可作为交互生成组件;目前证据尚不足以保证低延迟或物理正确。
我会先做的验证
未执行的验证方案:用独立种子和连续动作轨迹,在不同 r、m 和中断频率下比较等待、换条件、回滚和状态传输;同时报告端到端延迟、前缀变化、动作响应和外部物理指标。