AD-WM:让世界模型分清候选动作,而不只重建正确未来
残差动力学与动作恢复,面向反事实 MPC 排序
低平均预测误差可能掩盖不同动作之间的重要差别。AD-WM 用残差潜动力学和训练期动作恢复目标,逼迫预测保留动作导致的变化;部署仍用普通 CEM 搜索,不额外运行这些辅助头。
图解主要方法
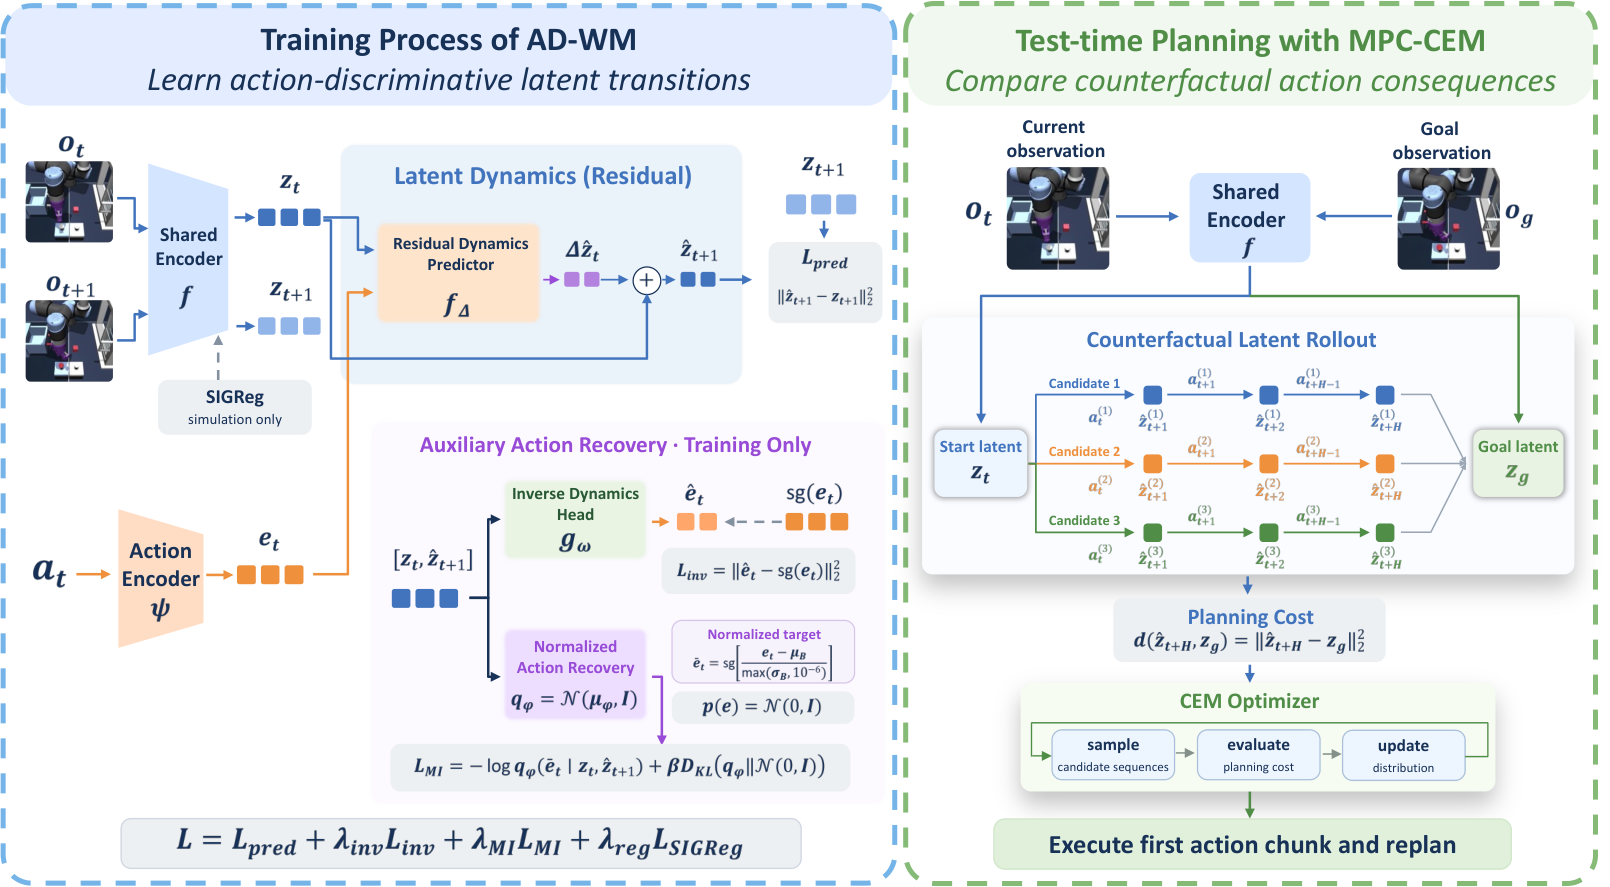
图 2 左侧的动作恢复监督如何影响右侧候选计划的选择?
- 1
把未来预测写成当前状态加变化
共享编码器得到当前 z 和目标潜表示,动力学网络预测动作导致的增量,再与当前潜状态相加。残差结构保留静态背景,让模型把容量用于变化;仿真中联合训练编码器并加 SIGReg,真机路线则冻结 V-JEPA2,二者不能当成完全相同模型。
- 2
从预测端点恢复动作嵌入
Inv 头读取起点与预测后继,恢复停止梯度的动作编码;因此动作监督必须穿过预测结果,而非只看真实未来做容易的识别题。动作本身不会因这个恢复目标而随意移动目标嵌入。
- 3
加入归一化恢复目标,控制表示规模
所谓 MI 目标由固定方差高斯动作恢复项与相对标准正态的 KL 正则构成,鼓励动作可区分,同时限制均值尺度。它受条件互信息启发,不能把损失数值称为直接测出的真实互信息。
- 4
部署只比较到目标的潜空间成本
删去辅助头,CEM 每轮从 300 条候选中选 30 条精英、迭代 30 次,预测视野 H=5、动作块为五步,执行首块再规划。关键是好动作能否进入精英集合;全体动作的平均预测误差或排序相关未必反映这一点。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【Cube hard-start】每协议 50 次、三训练检查点,基线成功 3.7%,完整模型 52.0%;残差 34.7%,残差+MI 为 54.7%。 Cube 主表与消融 ↗
我的解读我的解读:组合明显改善该难例,但不证明每个部件都必要:不加 Inv 的变体在此反而更高。
来源证据【跨五环境】四个改善,PushT 从 94 到 92;Scene 从 35.5 到 39.5,对应 p=0.13。 跨环境结果 ↗
我的解读我的解读:不能笼统宣称各环境显著提升;学习到的潜成本各有编码器尺度,不适合直接跨模型比较绝对数值。
来源证据【固定候选库】64 个状态、每状态 300 候选;精英 regret 与闭环表现相关 0.863,全局排序指标相关为 −0.399。 规划诊断 ↗
我的解读我的解读:局部好候选的选择可能比全局排序更相关,但相关性并不是优化该指标必然提高成功的因果证明。
来源证据【Franka】基本任务 45 次成功 19→32,复杂任务十次 2→5,目标抬升 27 次 9→17。 真机实验 ↗
我的解读我的解读:目标由人工分解并设夹爪控制,测试按模型块执行而非随机交错;零样本指无本实验室适配,不是无 DROID 训练。
开放情况与使用许可
官方仓库有训练、规划评估与固定协议文件,MIT;模型库确有五环境乘三种子的 15 个仿真检查点及清单,模型卡 MIT。真机代码和权重明确不在这次发布中,本站未下载或运行模型。
LICENSE仿真代码和所列检查点 MIT;上游数据与外部基线各自许可,真机制品未开放。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把监督放在动作引起的差异上,并用固定候选库检查精英选择,抓住了预测准确性与规划价值不一致的问题。
反方 · 哪些结论还不够
部分目标组合并非总有益,真机协议存在额外结构和小样本;仿真与冻结视觉编码的真机结果不能直接合并归因。
综合判断
适合作为潜空间 MPC 的训练改进,尤其应关注难初始状态和精英候选质量,而非只优化重建误差。
我会先做的验证
未执行的验证方案:固定编码器与候选动作库,比较残差、Inv、MI 的全因子组合;在同一真实初始状态随机交错模型,报告精英 regret、闭环成功、重规划延迟及置信区间。