世界模型训练:让不确定性决定该展开多远
短程起步、逐步延长;节省训练计算不等于策略更强
这项研究在世界模型自回归训练中监测多个预测头的分歧,超过阈值就截断当前展开,避免模型早期在不可靠的远期预测上消耗计算。实验支持它找到合适的长短程课程,但回放同一课程也能复现收益,不能将效果全部归因于持续在线不确定性估计。
图解主要方法
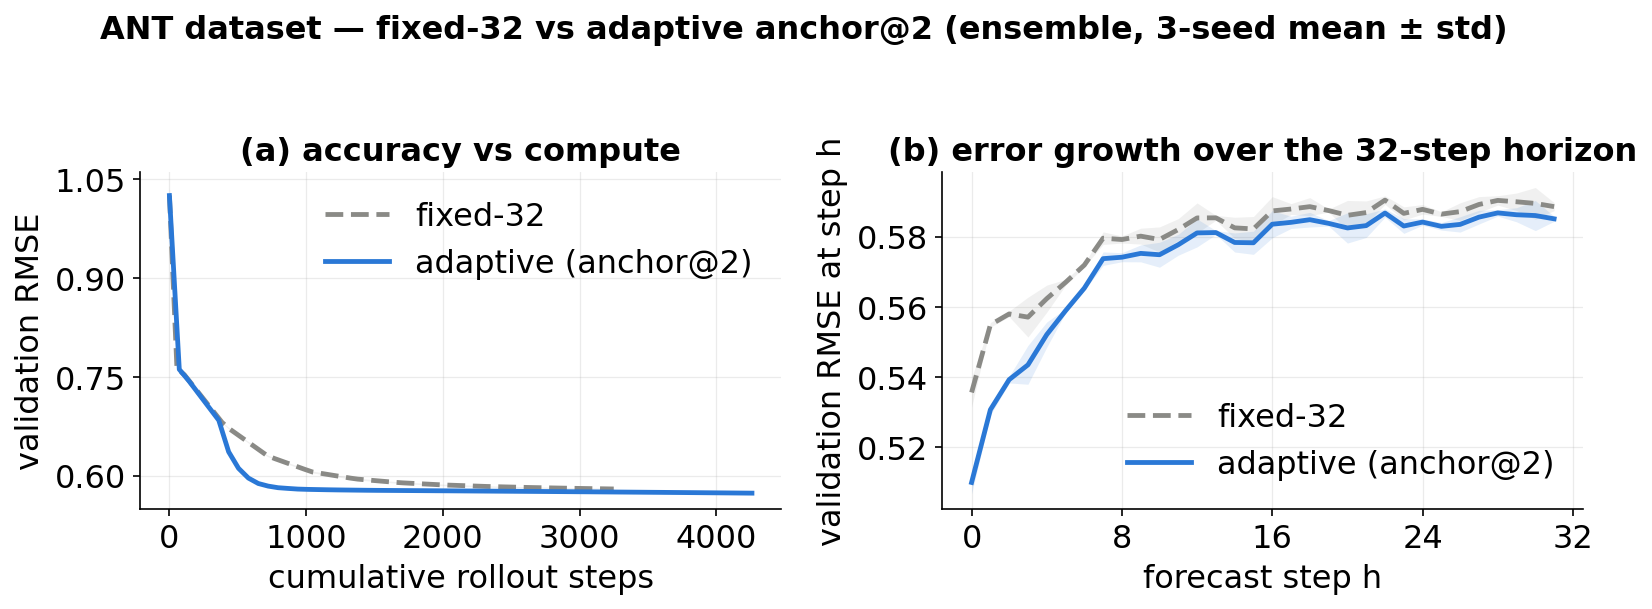
原图 3 的第二种机器人数据结果如何检验课程迁移,停止规则究竟是什么?
- 1
用共享 GRU 和多个头估计分歧
五个自举 MLP 头分别给出下一状态的均值与方差;均值之间的离散程度作为认知不确定性。它是可计算的代理,不是经严格校准的出错概率,头之间共享骨干也可能共享偏差。
- 2
只在训练预热阶段确定阈值
先做 50 次单步训练与 10 次完整展开,用最近预热迭代的浅层不确定性中位数冻结阈值。anchor@2 是取第二步作阈值锚点,不是把后续训练固定成两步;ANYmal 的对应阈值为 0.0808。
- 3
按当前批次分歧截断反向训练链
每批至少展开 4 步,最多 32 步,平均分歧越过阈值时停下。模型变准后自然能走得更远,以较低累计自回归步数覆盖长预测;不同数据和阈值仍会改变课程。
- 4
在无泄漏的离线轨迹划分上比较
ANYmal 约六百万转移,观测 45 维、动作 12 维;Ant 约六百万转移,观测 105 维、动作 8 维。轨迹片段先划分训练/验证,再取 32 步历史和未来窗口,归一化仅用训练集,避免邻窗跨集合。
- 5
把预测、训练计算和控制收益分开验收
论文还比较固定 8/32 步及 MC Dropout;某些 dropout 参数会一直停在最短展开。附录回放自适应得到的长度序列,不再计算不确定性,也能得到相近精度,说明发现课程本身可能是主要贡献。控制实验没有显示相对固定展开的一致策略提升。
实验与证据
以下为作者报告;已阅读 v1 全文及附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【表 II,三种子】ANYmal 的 32 步 RMSE:固定 32 为 0.314±0.001,自适应 0.288±0.002,固定 8 为 0.274±0.002;160 步则为 0.429/0.389/0.458。 表 II ↗
我的解读短课程能改善近程,长课程对远程有价值。自适应是折中,不能说所有预测长度都最佳。
来源证据【计算比较】报告累计展开 924 对 3250,约少 72%;对应 FLOPs 18.0 对 60.2,约少 70%。 训练成本统计 ↗
我的解读不同统计对应论文规定的训练终点或误差阈值,不是实测整机墙钟时间加速;固定 8 的计算本来就较低。
来源证据【图 3】Ant 作为另一仿真机器人数据,展示累计展开计算量与验证误差的关系,以及 32 步预测范围内的误差增长。 图 3 ↗
我的解读跨数据复现有意义,但仍是离线仿真动力学,不是多平台真机控制证明。
来源证据【附录 F】直接回放自适应长度曲线,在种子噪声内重现精度;MOPO 实验未见明确一致的策略优势。 附录 F 与控制实验 ↗
我的解读应把“更高效训练世界模型”与“机器人学到更好的政策”分开,后者需要独立证据。
开放情况与使用许可
已核查全文和附录;论文引用的 robotic_world_model_lite 是基线来源,本次未确认本文独立实现,不冒认为作者代码。
LICENSE论文 arXiv 非独占分发;本文软件许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
截断训练直接减少无效长程展开,固定阈值与回放课程使方法可被简单基线检验。
反方 · 哪些结论还不够
不确定性未校准,阈值仍需数据相关预热;计算节省不代表相同比例墙钟提速,预测提升也没有自动转化成更强策略。
综合判断
值得作为离线动力学训练课程复现;优先与廉价的固定短程及预设长度课程比较,而不是先增加复杂的不确定性模块。
我会先做的验证
未执行的验证方案:固定模型、轨迹与训练 FLOPs,对比线性延长、回放曲线和自适应停止;同时测墙钟、长程误差、预测校准及相同交互预算下的真实控制回报。