AdaTex4D:把动态纹理容量分给真正需要的高斯
纹理存储减半的同时,训练更慢、渲染也略慢
给每个4D高斯都配同样大的局部纹理,容易把容量浪费在简单或不可见区域。AdaTex4D冻结已有动态高斯骨干,以跨时间的可见梯度需求和形变尺度决定三平面纹理沿哪一轴增长,在相近画质下减少存储;它优化动态外观,不输出网格UV或PBR材质。
图解主要方法
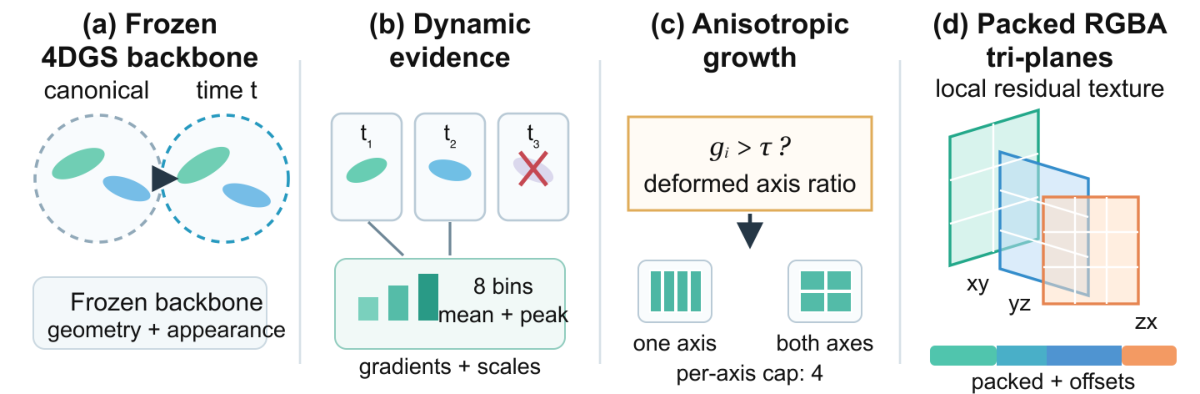
图2如何在固定几何上分配异构纹理,存储节省为何没有自动变成速度提升?
- 1
冻结已有动态表示并加有界残差
图左固定高斯中心、形变、基础透明度、SH及数量,给每个高斯附加局部RGBA三平面。RGB以0.1·tanh形式修正原外观;虽然基础opacity冻结,采样alpha仍调制有效透明度,因此不能简单说最终透明度完全不变。
- 2
只汇总可见时间段的需求
图中用可见投影中心的归一化梯度衡量纹理需求,把时间划分八个bin,结合0.5均值与0.5峰值。只看平均会漏掉短暂细节,只看峰值又易过度分配;不可见阶段不作为有效证据。
- 3
按形变尺度选择单轴或双轴增长
纹理从1×1开始,在500和1000步检查增长,轴长度按1→2→4封顶。若需求过阈值并有强各向异性,则仅扩长轴,否则扩两轴;用需求峰值时间的形变尺度决定方向,并同步插值纹理和Adam状态。
- 4
打包异构纹理,但渲染仍有额外成本
图右用packed张量保存不同容量,优化5000步、L1与SSIM重建损失。实际渲染路径仍物化到稠密4×4布局,所以存储减少不等于计算按同比例减少;它也不分离反照率、金属度、粗糙度或照明。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【12场景】六个N3DV和六个PanopticSports,纹理51.7对109.3MiB,减少52.7%;完整模型178.0对235.6MiB,减少24.4%。 主质量—存储结果 ↗
我的解读我的解读:纹理与完整资产是两种分母,不能把减半宣传成全部模型减半。
来源证据【质量与时间】PSNR28.191对28.157,差值0.034的场景bootstrap区间[-0.035,0.113];训练2.18对1.64小时,FPS84.1对100.8。 主表及统计口径 ↗
我的解读我的解读:主要是质量近似下节省空间,质量差异不显著;训练约慢32.9%、渲染约慢16.6%。单种子6666的场景区间也不是训练种子稳定性。
来源证据【等预算】80MiB时比均匀纹理在两数据集分别高0.175/0.205dB;150MiB的Panoptic中原4DGS部分指标仍更好。 预算表与固定高斯数量实验 ↗
我的解读我的解读:在紧预算下分配容量有价值,但不是每预算、每指标都领先;低高斯数量时也有更明显质量损失。
开放情况与使用许可
全文及可用补充说明已读;未核实专属可运行实现或检查点公开。
LICENSE实现及权重许可未确认;论文图2许可见图注。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
以真实动态可见性和尺度决定局部纹理容量,直接针对动态高斯资产的存储成本。
反方 · 哪些结论还不够
画质改善很小、计算反而增加;仅固定骨干的外观优化,不能保证UV接缝、PBR、去光照或重光照一致性。
综合判断
适合存储受限的动态场景表示研究;若瓶颈是训练时间或实时FPS,须先做完整成本验收。
我会先做的验证
未执行的验证方案:固定骨干与显存预算、多种子比较均匀/静态自适应/动态自适应;按遮挡重现与快速形变分层测画质、闪烁、总字节、峰值显存、训练时长和P95帧时。