AEWM:在执行前改写下一步推理和行动,阻断错误任务状态
世界模型转向决策后果分类,真实工具仍负责产生观察
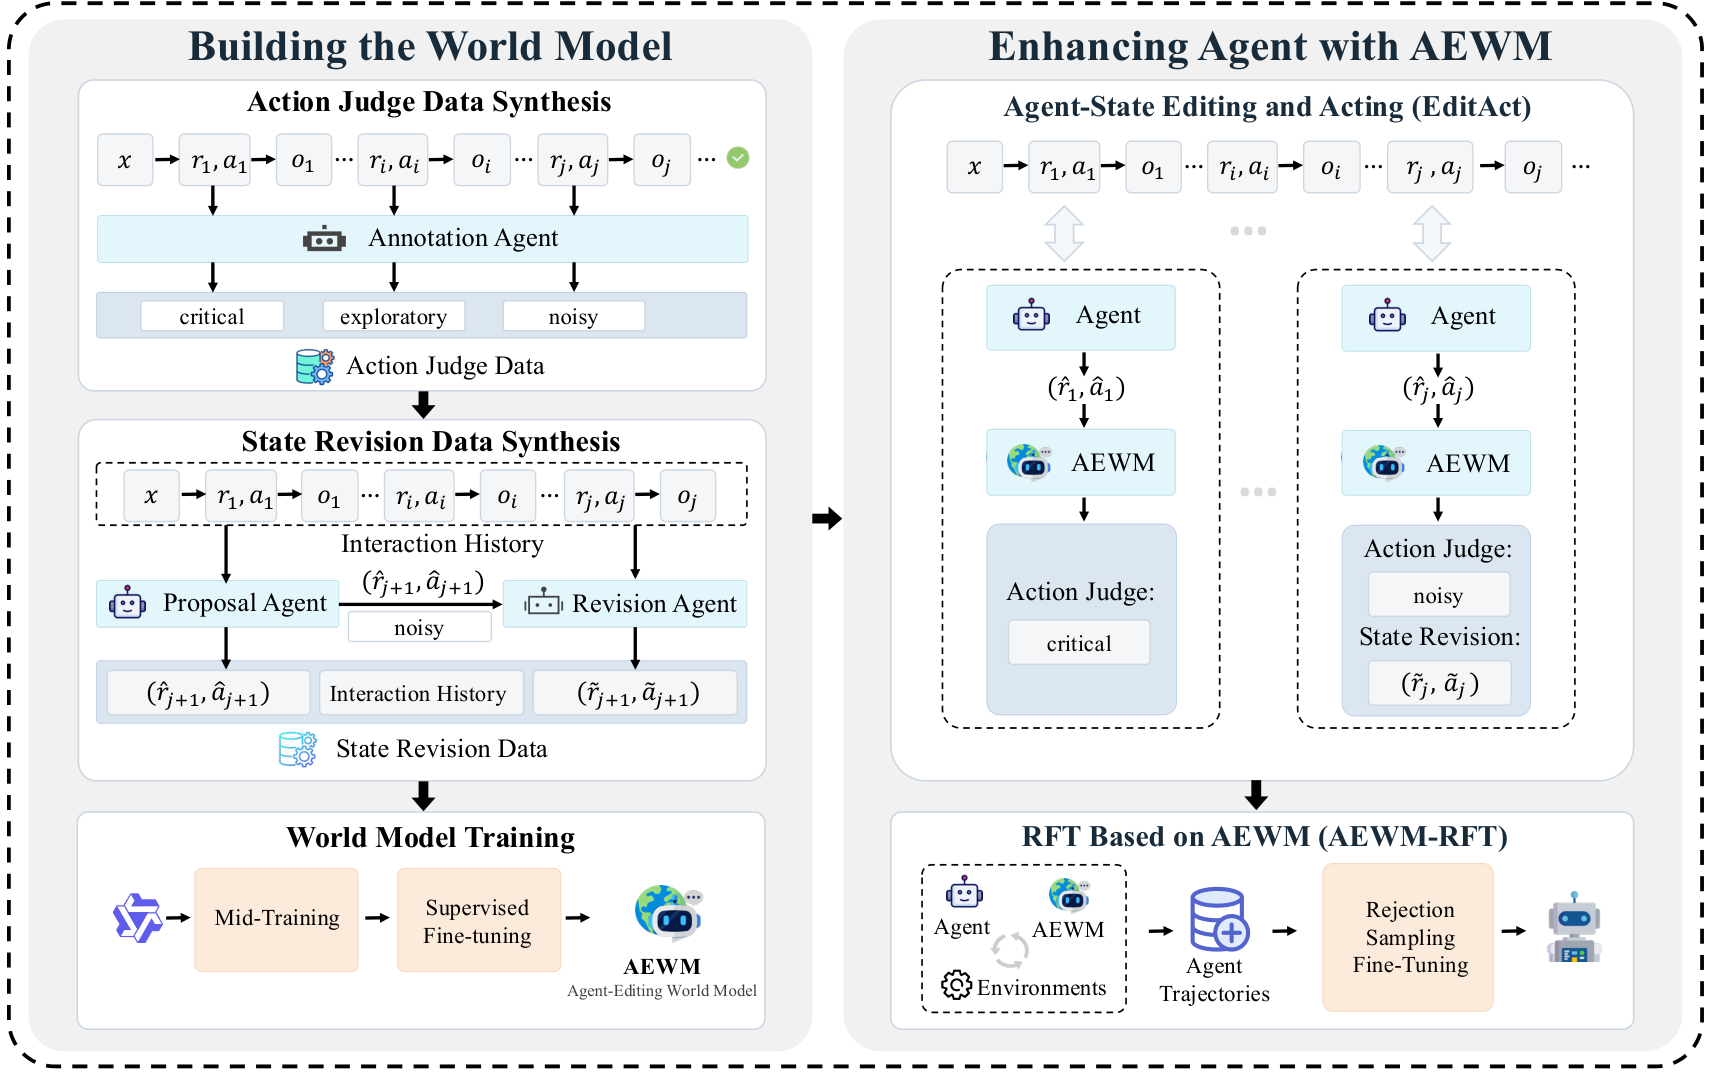
AEWM不预测搜索结果或终端输出,而是判断下一步决策对任务的贡献:关键、探索或噪声。EditAct保留前两类,遇到噪声则替换尚未执行的推理与行动,把真实执行反馈写回历史。它针对的是无根据假设和过时计划反复影响后续决策的问题,并用纠正轨迹进一步微调代理。
图解主要方法
图2中的监督标签、在线编辑与离线蒸馏各改变什么?
- 1
从真实轨迹学习动作后果
图2左上将成功轨迹拆成决策。标注者可看后续执行结果,区分关键步骤、有用探索和噪声;学生只看执行前历史与提案。三次一致标注和质量过滤降低噪声,但回顾标签仍只反映实际发生的一条路径,并非动作在所有未来中的价值。
- 2
用真实执行构造修正样本
左中由代理提出下一步,判断器发现噪声后,修正模型从同一历史生成新的推理和工具调用。只执行修正并审核它的真实收益,原动作没有对照观察,因此不能把每个样本都当成配对因果实验。约52.16B token中间训练后,再用12万条决策样本微调统一35B-A3B模型。
- 3
在线只替换尚未执行的延续
右上EditAct先提案,再分类。关键和探索动作照常执行,噪声则同时替换推理与行动;旧历史保持不变,新行动产生真实工具反馈。它不是修改已经发生的事实,也不是让虚构终端输出进入上下文。分类和修正分别有8K、32K输出上限,增加了推理开销。
- 4
将纠正轨迹蒸馏回代理
右下AEWM-RFT筛选真实执行验证过的轨迹,再按领域分别微调代理。Search、Terminal、SWE分别用4000、7095、1456条,与Self-RFT匹配样本数及训练设置。测试不再在线调用AEWM;这是三个独立领域代理,不是一个统一蒸馏代理的结果。
实验与证据
已阅读v1正文、附录A–E及全部提示模板,核对图2、仓库、模型卡、权重分片和3000条评测集文件。作者实验未由本站独立复现。
来源证据【动作判断】3000条决策、每领域1000;AEWM整体macro-F1为70.5%,最强比较项59.9%。噪声类精确率80.3%、召回82.0%,探索类精确率57.5%。 图3、附录B表10–12 ↗
我的解读我的解读:3000是决策数而非独立任务数,整体分数按汇总样本计算。探索和噪声仍会混淆;成功轨迹及模型标注的一致样本筛选不能替代失败分布上的可靠性检验。
来源证据【端到端】六基准每项运行三次;4B、9B、35B-A3B代理的六分数均值比最佳基线分别高6.7、5.2、3.2点。Terminal-Bench使用89任务、每任务3小时,Search最多600步。 表1、附录C表13 ↗
我的解读我的解读:均值混合准确率、F1及测试通过率,不是统一的任务成功率。9B加35B编辑器超过35B独立ReAct,不能解读为9B单模型更强或成本更低。
来源证据【干预消融】35B代理BrowseComp/Terminal/Doc2Repo,完整方法48.1/48.3/48.9;同在线噪声率的随机干预44.1/40.8/43.9,批评提示41.8/39.3/43.2。 表3、附录C.3 ↗
我的解读我的解读:选择何时介入及直接编辑均有贡献,但随机门匹配的是干预频率,不是总计算。Search中间训练相对SFT-only只增加0.8点,须结合训练投入评估。
来源证据【离线迁移】AEWM-RFT比Self-RFT在三个领域高2.2/2.6/2.5点;Doc2Repo平均回合从76.3增加到89.8,其他两域减少。 表2、附录A.4与D ↗
我的解读我的解读:收益并不总来自更短轨迹;在线编辑成本转移到数据生成和训练阶段。案例只执行修正,展示局部改进,不能证明未经执行的原方案必定失败。
开放情况与使用许可
GitHub提交d02880c提供EditAct推理与评测实现,Apache-2.0;Hugging Face模型含14个Safetensors分片,模型卡标注Apache-2.0,另有3000决策评测JSONL,同样标注Apache-2.0。52B训练语料、训练轨迹和RFT完整流水线未随代码提供。模型仓库的AEWM是在线编辑模型,不是三个领域分别微调后的AEWM-RFT代理。
LICENSE代码与模型/评测集分别按各自Apache-2.0声明核对,外部数据仍受原许可约束。论文arXiv托管许可不等于一般图片再分发许可;图2用于必要方法评论。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同频率随机干预、重新采样、提示式批评、仅改行动和仅改推理均有对照,完整编辑在三个消融基准上最好;真实工具反馈避免把预测输出直接当证据。
反方 · 哪些结论还不够
离线标注只观察已实现的一条后续路径,不是所有可能未来的动作价值;训练和评测共享模型标注体系,仍需人类审计。三个运行均值未给出充分成本与置信区间,无法据此确定效率收益。
综合判断
可检查的决策监督与编辑框架,收益有多种消融支持;“世界模型”在此指决策影响建模,不宜外推为学会物理世界或通用状态转移。
我会先做的验证
未执行的验证方案:匹配总token、工具调用及墙钟预算,与同大小批评模型比较;加入失败轨迹和分布外工具,人工盲审被判噪声但实际有用的动作。对同一状态分叉执行原动作与修正,报告救回率、破坏率及错误终止率。