ALPS:让世界模型的视觉状态既能预测,也能读回像素
同一组patch token怎样兼顾状态、语言与重建?
ALPS用静态图片和文字训练视觉状态编码器,冻结后的token可供机器人策略、动力学预测和图像解码使用。它提供的是世界模型的视觉基础,而非一个已验证的语言指令到规划到像素检查的完整系统。
图解主要方法
同一组patch token怎样兼顾状态、语言与重建?
- 1
在同一patch表示上训练四种目标
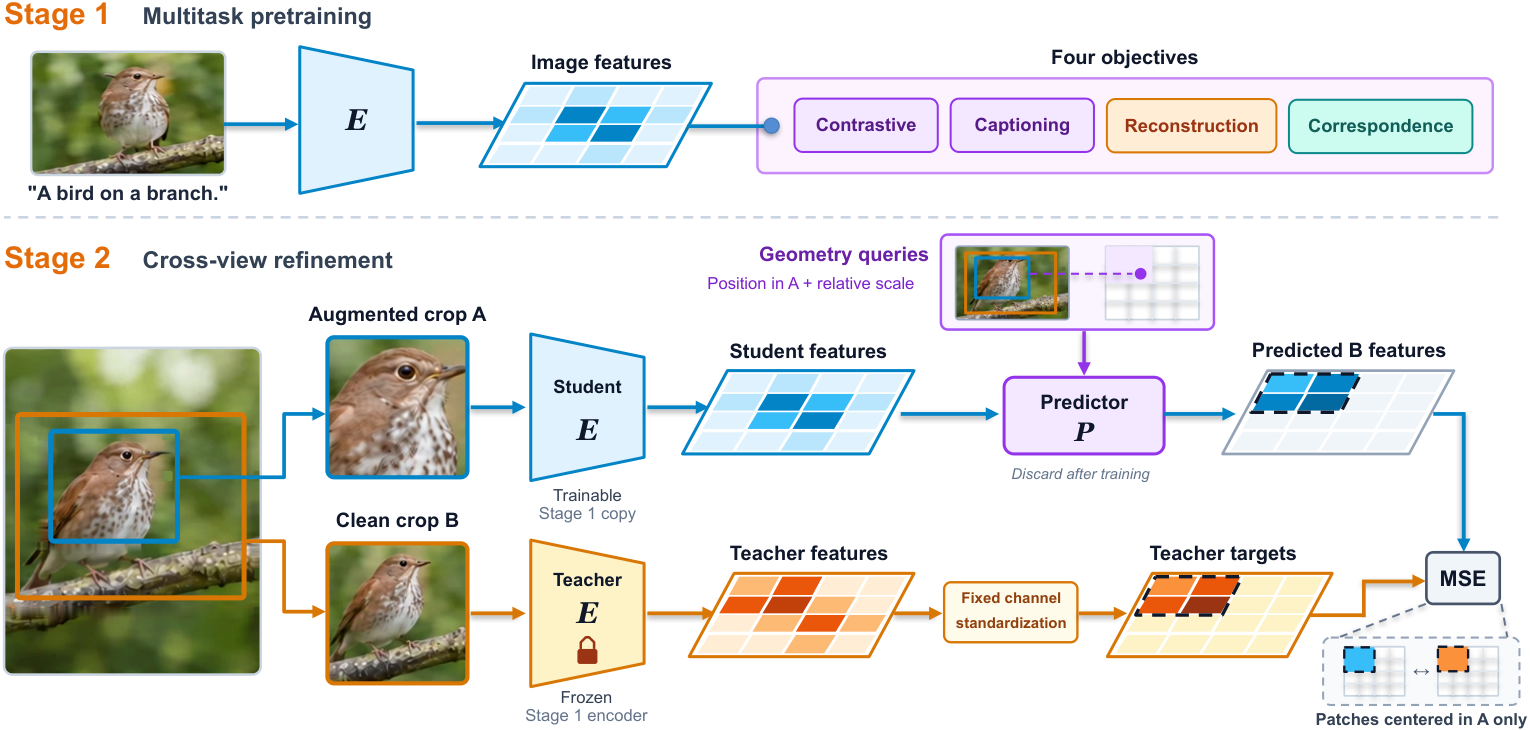
图2第一阶段从头训练ViT-B/16,用图文对比、caption、像素重建和跨裁剪对应共同监督未归一化token。全局语言接口采用线性投影与平均池化;13.8B是累计样本次数,不是独立图片数。
- 2
用几何对应细化状态特征
第二阶段冻结第一阶段教师,学生看带增强的裁剪,查询编码教师patch相对位置和尺度,只监督落在学生视野内的重叠patch。五百万次静态图片采样不使用动作或编辑配对监督;训练后丢弃预测头。
- 3
冻结编码器,分别验证下游接口
状态探针读取历史16帧并可接收未来动作;真正世界模型则学习预测未来token。评测像素解码器另行训练、映射到SDXL潜空间,不是第一阶段重建头。规划与语言条件策略分别测试,不能拼成未做过的统一演示。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据相对位置误差0.829,C-RADIOv3为0.864、DINOv3为0.870;匹配更大V-JEPA2的综合值,但当前状态读出更差。 状态探针与语言保留 ↗
我的解读不同时间范围有不同优势;低状态探针误差不保证最好的动力学预测。
来源证据主表原生文本塔85.5%;三次训练均值85.2对BERT82.1,差3.1点的95%区间为[-0.9,+7.1]。 LIBERO控制与独立种子 ↗
我的解读能作为独立文本接口,但不宜把正均值写成已证明显著提高。
来源证据PushT90%、Wall92%并列领先;Rope距离0.750差于0.558,Reacher78.7%低于86%。10%预算消融去重建反而降低状态误差;SSv2由56.4到55.6。 规划、消融与时间信息 ↗
我的解读三目标存在容量取舍,静态跨视角训练没有自动获得细粒度动作理解,也没有实机验证。
开放情况与使用许可
官方仓库含训练评测实现和Apache-2.0许可;HF存在两个编码器safetensors及LIBERO策略权重,模型卡声明Apache-2.0。第三方编码器和数据许可单独保留。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
为同一状态提供语言和像素检查接口,有助于诊断世界模型想象与真实场景的差异。
反方 · 哪些结论还不够
只验证ViT-B和仿真任务;预训练成本不低,某些下游世界模型使用额外本体感觉输入。
综合判断
值得作为可检查的视觉基础比较,不能称作所有任务最优的世界模型。
我会先做的验证
未执行的验证方案:保持动力学网络、动作输入与数据量不变,测试遮挡、视角变化和长时间滚动;把读出误差、单步误差和累积误差分别报告。