AnyGameRenderer:游戏状态仍由引擎掌管,生成模型负责画面
从粗糙色块到风格画面,怎样避免漏画、错位与实体幻觉?
该方法把引擎输出的粗几何或语义图当作视频控制信号,微调MiniMax-H3生成精细游戏画面。这里纳入世界模型方向,是讨论显式状态与生成渲染的分工;它没有替代游戏规则或物理引擎。
图解主要方法
从粗糙色块到风格画面,怎样避免漏画、错位与实体幻觉?
- 1
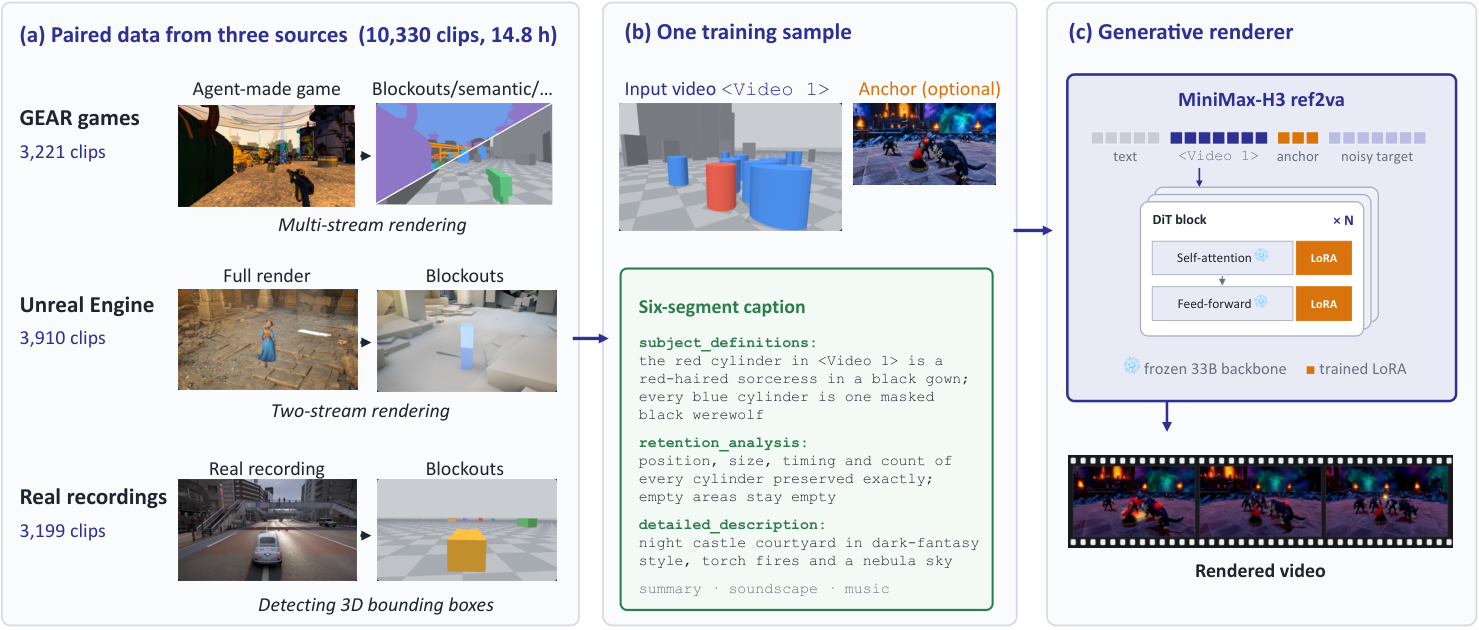
图2a:构造帧对齐的多来源训练对
10,330个片段来自38款agent游戏、Unreal场景与真实游戏录像;前两者多渲染通道配对,后者用检测3D盒子构成粗代理,保持时间对应。
- 2
图2b:caption写成实体对应约定
分段描述实体颜色/类别、位置、数量、时序与应保留空白;加入不出现在画面里的描述干扰,让模型以控制视频为准。可选目标首帧提供风格锚点。
- 3
图2c:冻结骨干,只调渲染适配器
冻结33B MiniMax-H3 ref2va,在注意力和前馈层加入rank128 LoRA;16张H200训练3轮约48小时,推理20步。风格由文本控制,运动仍应跟随输入。
- 4
用实体同步而非单帧美观评估
SAM3跟踪生成实体并与真值框匹配,报告时序、位置、未渲染、幻觉和数量变化。相同测量流程也跑真值视频,用来暴露自动度量自身误差。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据时序匹配50.9%升至62.9%,位置57.1%到61.9%;幻觉52.1%降至46.0%,漏数量变化34.7%降至21.3%。 Table 2,59场景753实体 ↗
我的解读改善明显但残余误差很大;真值视频的幻觉指标也有34.1%,不能把46%直接当人工确认的错误实体率。
来源证据片段为124帧、24fps、1344×768;真实录像分组未渲染率2.6%到2.9%,并非全指标改善。 数据与外推条件 ↗
我的解读24fps是输出格式,不是在线推理帧率;短片段不证明跨分钟实体持久性。
来源证据H100级硬件20步每124帧约17分钟,另有每进程约6分钟权重加载。 官方README运行说明 ↗
我的解读这是官方工程说明,尚非本机复现;清楚排除实时游戏渲染的误读。
开放情况与使用许可
GitHub含infer.py,Apache-2.0;HF有LoRA safetensors,模型卡标MiniMax-H3 Community License,需结合底座许可。数据仓库仅.gitattributes占位,不能称10,330片段已开放。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
通过成对数据和实体级评估,把“好看”与“忠实执行游戏状态”分开衡量。
反方 · 哪些结论还不够
对齐不完美、自动测量噪声和离线成本较高;不输出可编辑mesh、UV、去光照贴图或PBR材质。
综合判断
适合离线原型和视觉风格探索,不能替代要求精确状态反馈的实时竞技渲染。
我会先做的验证
未执行的验证方案:固定同一引擎状态,改变风格和实体数量,逐帧人工核查轨迹、计数、遮挡与长段ID漂移,同时记录实际生成延迟。