ARMesh回顾:把网格生成改成逐级增加细节
从一个点开始预测顶点拆分,提前停止仍保留整体形状
逐面生成网格时,中途停止往往只有半个物体。2025年的ARMesh反过来学习网格简化的逆过程:从一个点出发,逐步拆分顶点、更新局部拓扑,得到不同细节级别的完整粗形状。今天回顾补收,重点看这种表示能为资产LOD与编辑提供什么。
图解主要方法
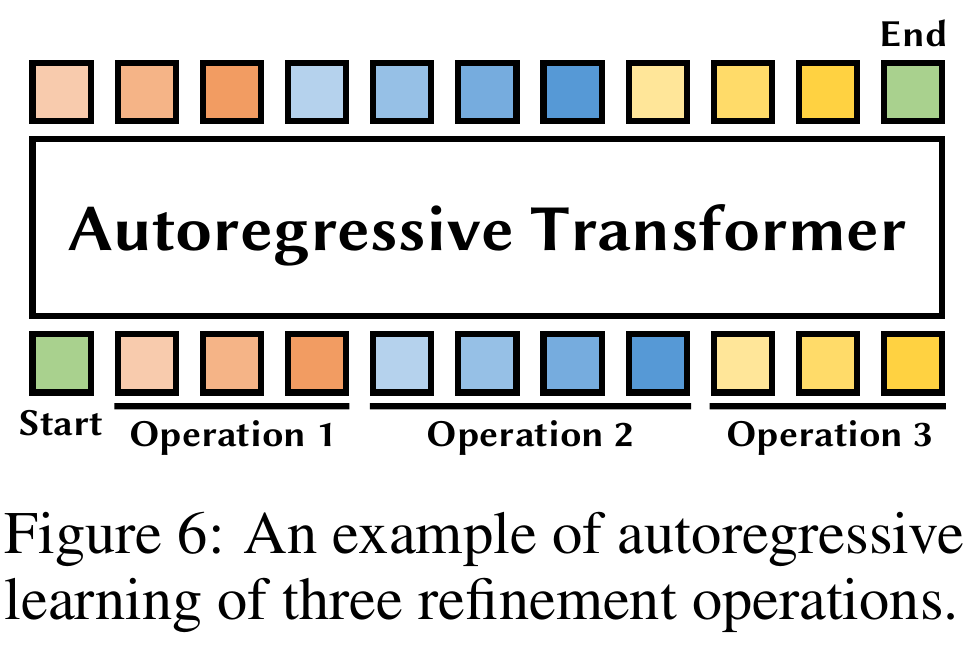
图6如何把局部细化操作变为序列,为什么必须在Transformer之外检查拓扑合法性?
- 1
将网格推广为单纯复形再简化
三角面之外允许孤立点和线段;GSlim用二次误差度量贪心折叠,并加入Delaunay四面体化得到的虚拟边连接分离部件。允许拓扑变化,任何输入最终可化为一个点;这与始终保拓扑的简化不同。
- 2
记录顶点拆分所需的局部信息
逆序恢复时,每步包含待拆顶点索引、位置偏移、是否以中点解释以及邻接点/边/面的拓扑标签。九种局部情形和四条一致性约束让操作可重建,不是只预测坐标再随意连接面。
- 3
把细化操作压成自回归token
图6以不同颜色表示连续三次操作,用Transformer预测下一个token至结束。索引int16、偏移3×fp16和拓扑标签紧凑编码,再用BPE压缩约2–3倍,词表16384;主模型12层、宽768,无条件生成是主要任务。
- 4
受约束解码并按所需LOD停止
采样时检查顶点索引与拓扑标签是否合法,必要时深度优先回溯,再接受下一操作。提前停止控制已生成顶点数并保留粗形状,但不能保证流形、自交、UV可展开性或动画边流都合格;骨架编辑与粗网格细化主要是应用示例。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【训练范围】ShapeNet预处理限制每网格少于1700顶点、800面;四H20预训练约4天,两H20分类型微调约2天。 实验设置、图7 ↗
我的解读我的解读:处理两百万面的GSlim简化演示不能当作生成器已能高质量生成两百万面资产。
来源证据【提前停止】bench类用50%生成步骤时COV54.84、MMD0.87,完整为56.29/0.75;每形状平均2556token,对照BPT为3235。 表2、表4 ↗
我的解读我的解读:优势在中途结果仍有整体结构;完整生成质量与强token化基线接近,顶点和三角面的每元素token不能直接混比。
来源证据【非全面领先】chair/table的FID和MMD改善,但COV分别36.67/32.94,低于MeshGPT的43.28/45.68;完整生成平均约一分钟。 表3与生成时间 ↗
我的解读我的解读:保真、覆盖和速度仍有取舍;1-NNA以50%为理想,并非越低越好,不能把所有指标写成领先。
开放情况与使用许可
2025-09-25首发,今日回顾补收v1全文。官方仓库有libpsc源码包/轮子、可视化、100网格例子及预处理/训练/生成脚本;未核实论文完整预训练检查点公开,未在本机执行研究代码。
LICENSE根LICENSE为MIT,数据和上游组件仍依各自许可;论文原图许可独立,见图注。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把LOD直接放进生成顺序,支持逐级展示、预算控制与局部细化,而非生成完成后再做独立简化。
反方 · 哪些结论还不够
泛化、低面数训练与串行约束采样限制复杂资产;没有纹理、UV、PBR、材质分解或重光照验证。
综合判断
可作为原生可控LOD几何的基础路线,进入生产仍需拓扑清理、UV与材质管线的独立验收。
我会先做的验证
未执行的验证方案:在未见类别和薄片/多部件资产上固定顶点预算,比较ARMesh、完整生成后简化及其他自回归方法;测各LOD几何误差、自交、非流形、UV接缝、编辑保持和端到端耗时。