Astronex-World 1.0:把视频先验改造成分块交互模型
五阶段后训练、几何控制与少步采样,也带来运动衰减
Astronex 在 Wan2.2-TI2V-5B 上加入 PRoPE 相机条件、动作接口和块因果缓存,报告单 L20 实时生成。完整报告同时暴露了复杂交互、回访漂移和蒸馏后运动变弱的问题;开放动作接口不能被写成已经可用的机器人策略。
图解主要方法
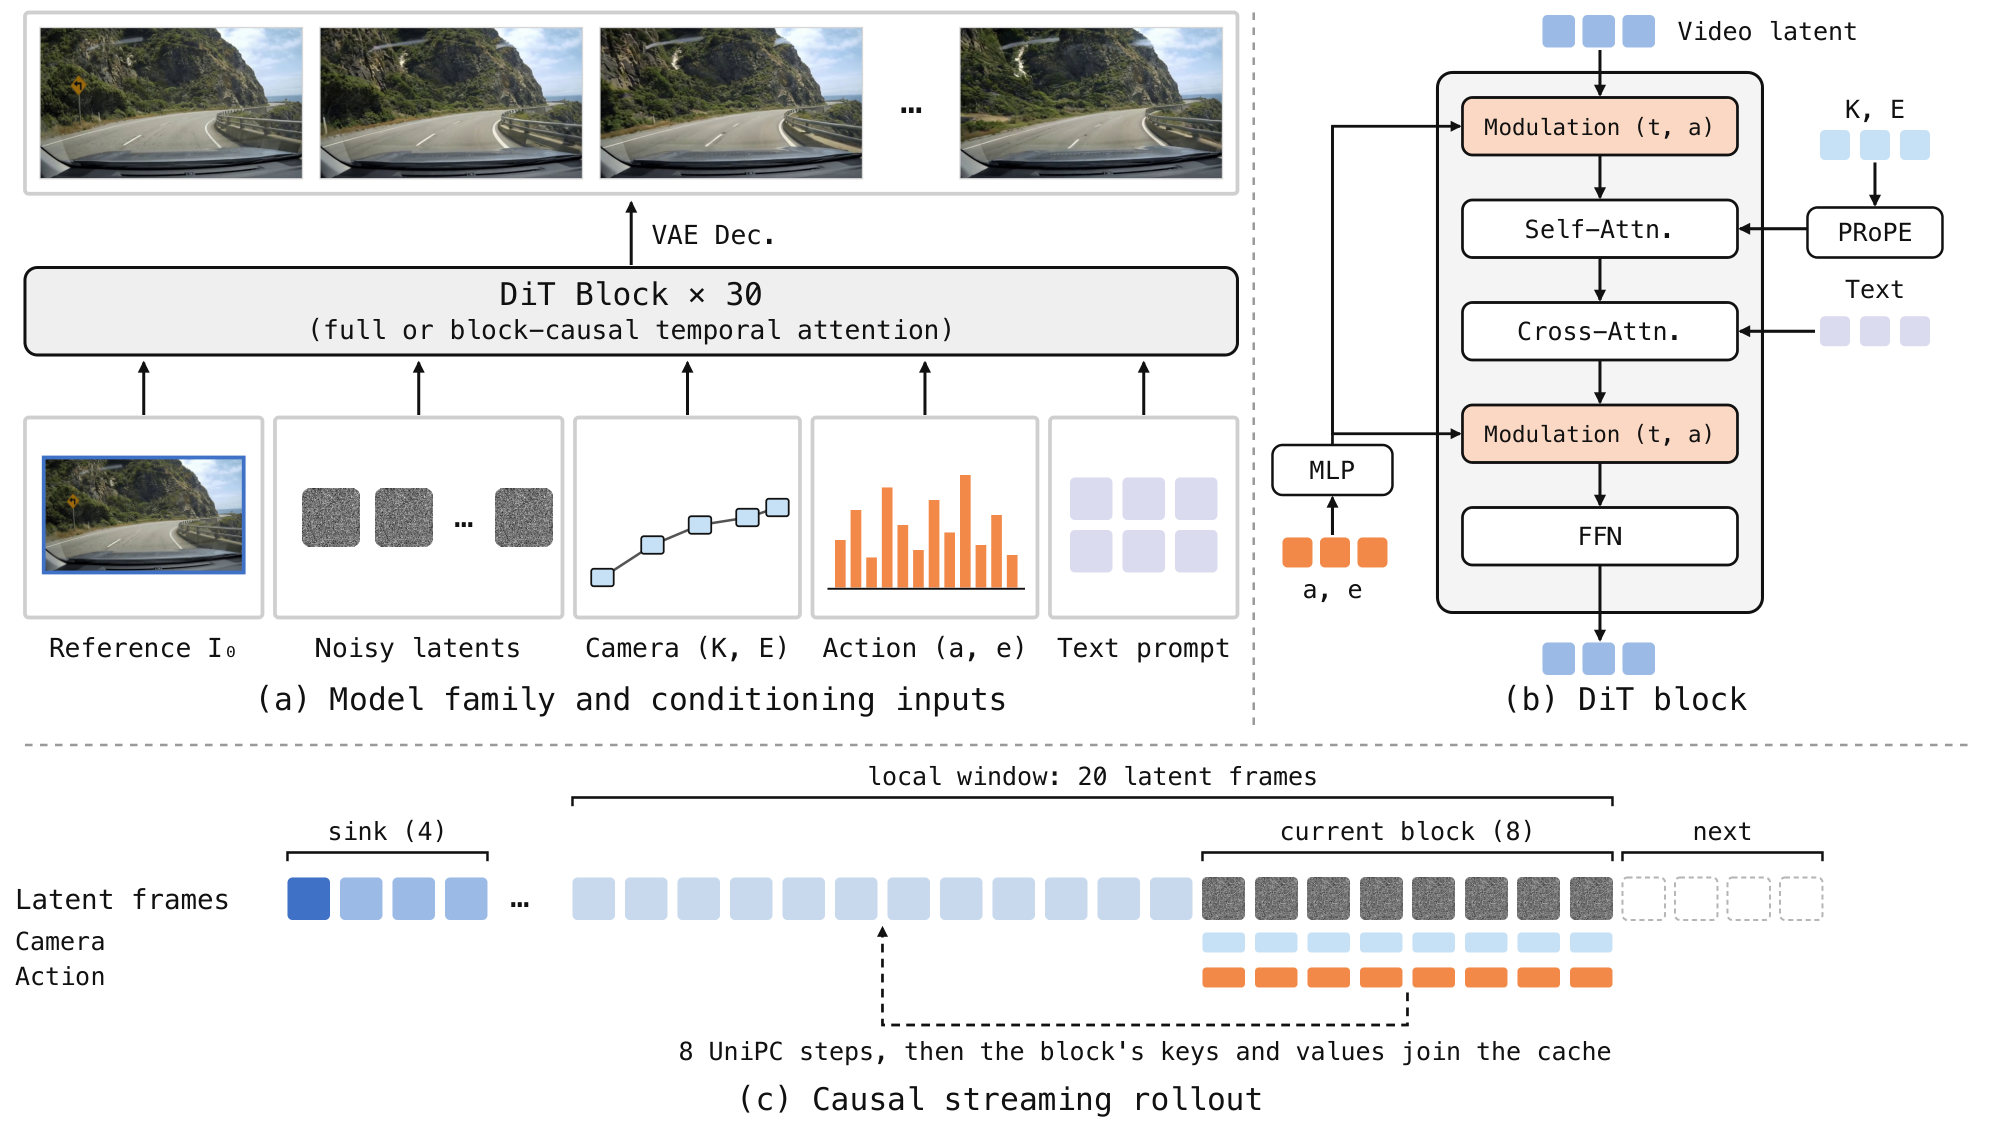
图 2 如何把双向视频生成变成可缓存的持续交互?
- 1
图 2a:复用已有视频先验与潜空间
主干为约 5.35B、30 层 DiT,继承 Wan 的视频 VAE 和预训练能力。文生视频从噪声开始;图生视频把参考帧放到首潜帧、时间设为 0,并在每步保持干净。“两张 L20 训练”指这套后训练,不能抹去基础模型预训练成本。
- 2
图 2b:相机几何与动作走不同路径
PRoPE 在注意力里接收相机内外参;64 维动作和 32 种 embodiment ID 经 MLP 加到各层尺度、平移和门控。论文强调 c2w/w2c 与内参归一化转换。动作输入路径和动作输出头不同,模型卡明确发布的输出头为零初始化,未后训练时返回零。
- 3
图 2c:块内看完整块,块间只读过去
训练每块 4 个潜帧,推理每块 8 个;已完成块的 K/V 缓存复用。20 个潜帧局部窗口加最初 4 个 sink 帧限制上下文成本;回访轨迹可启用视锥重叠检索。它减少忘记起始场景,却不构成可逆的持久 3D 地图。
- 4
五阶段:从控制适配到因果转换与分布匹配
先用双向 LoRA 适配相机/动作,再 teacher forcing 转因果;25 步教师的在线轨迹蒸馏给 12 步学生初始化,随后混合场景 SFT 恢复运动。最后用双向真实分数教师与在线假分数网络做非对称 DMD/DMD2,加入相邻帧运动幅度约束。阶段之间目标与历史分布不同,不能统称一次四步蒸馏。
- 5
实际发布默认八步,事件通过未来文本条件生效
最终蒸馏面向四步但默认八步 UniPC 质量更好;过去块缓存保持,事件在指定位置追加文本并重建文本交叉注意力缓存。当前适配器只有最早一次文本切换,多个事件合并,解释了复杂交互弱于导航的部分原因。
实验与证据
以下实验均为作者报告,本站已阅读论文正文及可用附录,未独立运行研究实验。实验条件、观察结果与编辑解读逐项分列。
来源证据【表 5–6】WBench Navi 158 平均 73.5;完整 289 案例平均 70.0,Interaction 从导航设置的 63.4 到完整设置的 47.6。 §7–8,WBench ↗
我的解读不能仅用导航子集代表全部交互能力。同行分数来自 09-13 榜单快照,而本模型由作者运行官方代码,仍非本站统一重测。
来源证据【§7.1、表 8】实时设置为单 L20 48GB、832×480、24fps、8 步;VBench 仅完成 T2V 240/6220、I2V 118/5590。 §7,推理与评测 ↗
我的解读24fps 播放格式与单次交互延迟也需分别测量;部分 VBench 不能宣传为跑完标准全榜,更不能把 L20 的设置直接推广到普通 24GB 显卡。
来源证据【表 9】单个篮球序列内部诊断中,运动残差幅度由双向教师 88.8px 到最终 DMD 16.6px,约为 19%。 §8.8,运动诊断 ↗
我的解读这不是通用运动指标,但提示“更稳定”可能伴随少动;低动态程度与该诊断一致。不能仅用平滑视频质量判断物理能力。
开放情况与使用许可
已核实 GitHub 中模型、推理与后训练脚本,以及 Hugging Face 三个真实 denoiser 分片、VAE/文本编码器和配置;本次只检查文件与文档,未下载运行大权重,未证明全部五阶段训练链完整复现。
LICENSE代码 LICENSE 与模型卡为 Apache-2.0;论文图片另为 CC BY-NC-SA 4.0,不能混用许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
完整写出训练阶段、缓存、采样和几何坐标约定,便于定位控制问题。
反方 · 哪些结论还不够
速度依赖服务器级单卡与特定分辨率;动态图像不等于可用物理仿真,模型卡还揭示动作输出头尚未训练。
综合判断
开放可复现入口值得关注,核心已验证范围是受控视频生成。
我会先做的验证
未执行的验证方案:固定相机轨迹和种子,比较 4/8 步、sink 开关及回访检索;记录交互延迟分布、运动幅度、回到同一视角的几何偏差,并单独后训练与评估动作头。