AWAM:先想象物体的其他视角,再做动作
多视角世界先验能否弥补机械臂的遮挡?
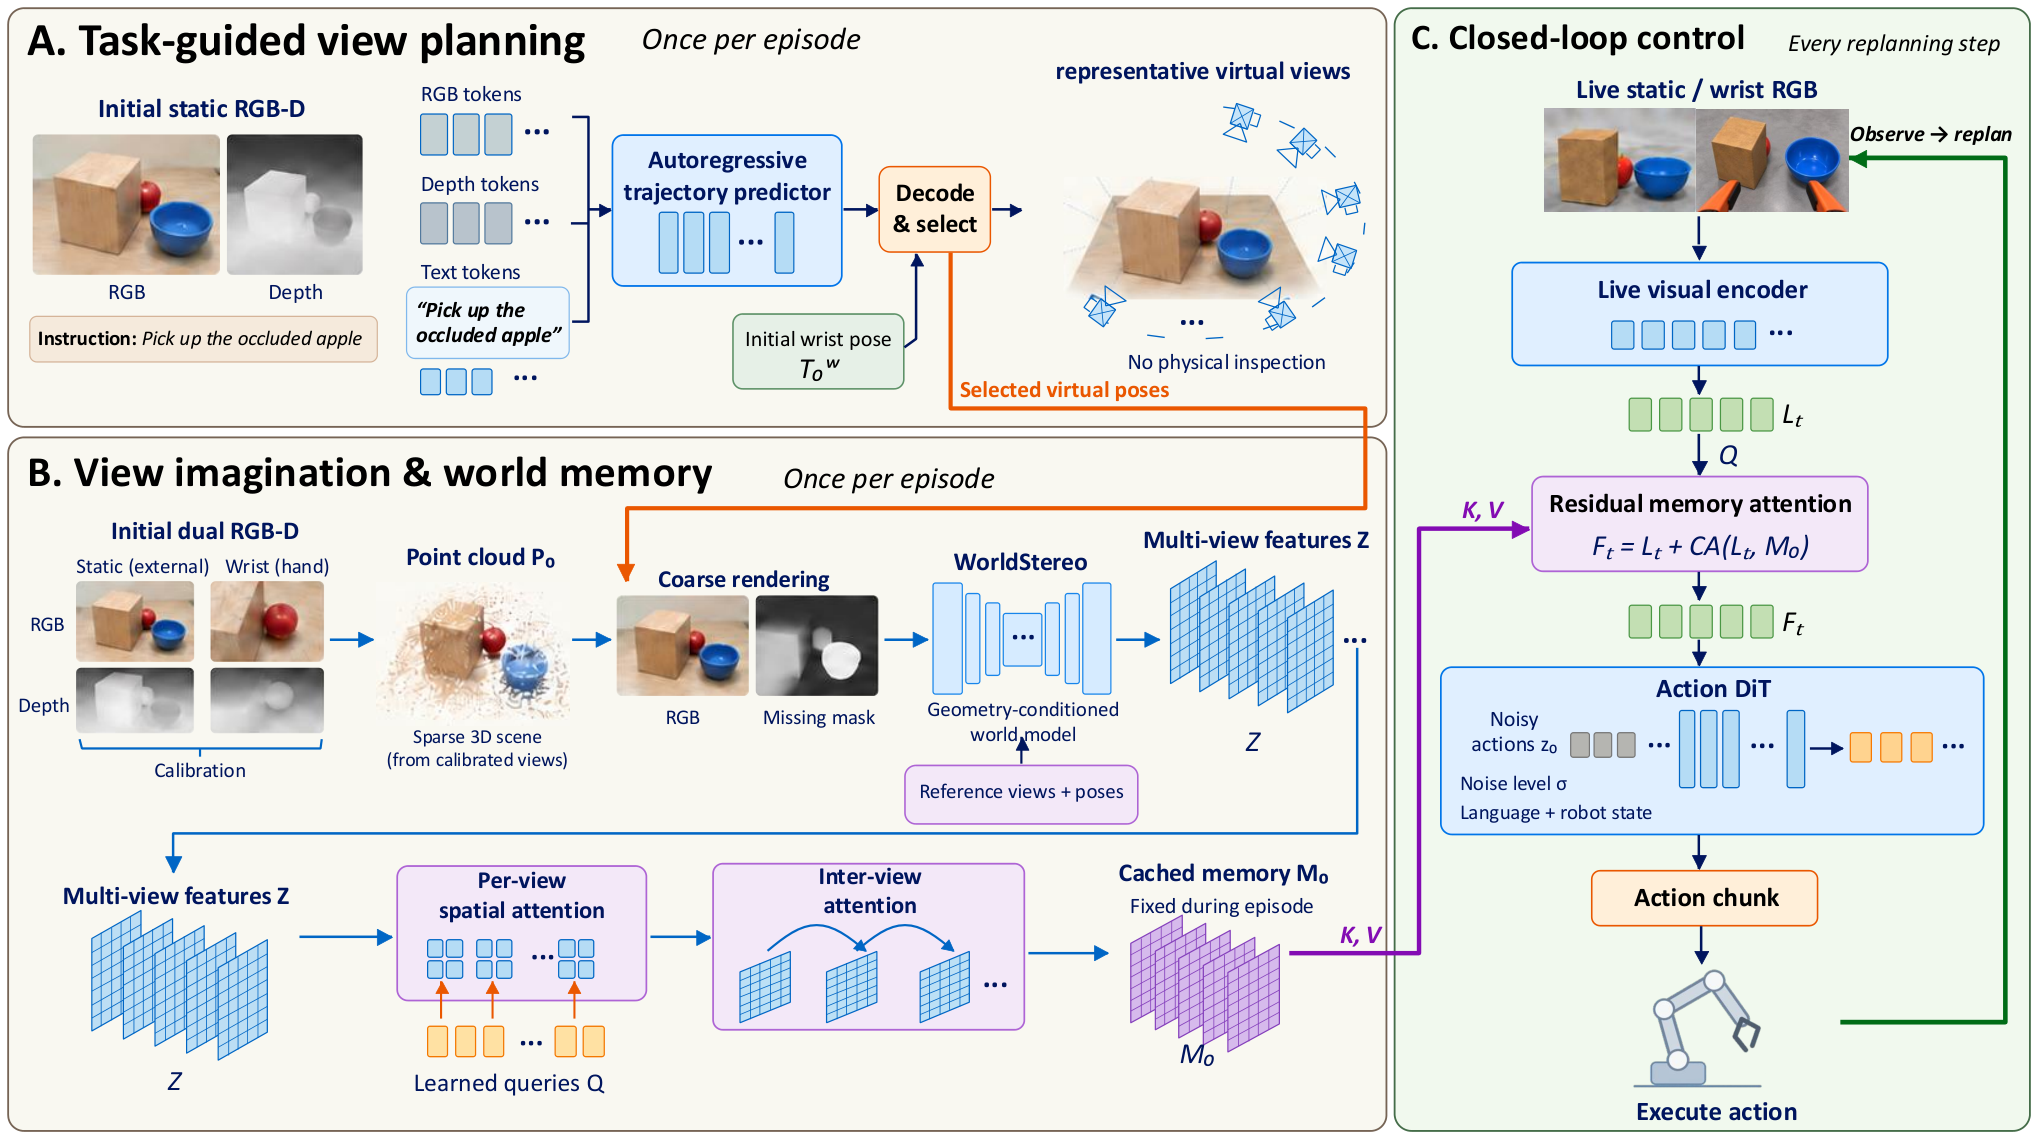
AWAM 从初始观测生成一组虚拟视角,把世界模型的中间特征压缩成动作策略可检索的记忆。它主要想象同一初始场景的其他观察位置,不是预测执行动作后的未来;一旦物体实际移动,固定记忆也可能过时。
图解主要方法
多视角世界先验能否弥补机械臂的遮挡?
- 1
为初始场景规划虚拟观察轨迹
图2利用标定的静态及腕部 RGB-D 和语言生成视点路径,监督来自演示中的腕部路径。按累计运动挑选21个姿态;这些姿态是生成条件,不要求机械臂真实走到每个位置。
- 2
从可见几何与世界先验补足视角
点云反投影到虚拟相机后留下孔洞,适配的 WorldStereo 提供多视角特征。使用第一去噪步的中间特征并压缩成294个384维 token,避免把长视频全部交给动作模型。
- 3
用当前观测检索固定记忆
动作策略的实时视觉和本体感觉通过残差交叉注意力访问这份记忆,再扩散生成8步动作。记忆每回合构建一次,世界模型冻结;它补充视角信息,但想象本身不是新的传感器证据。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据LIBERO-OCC 共2000次 rollout,平均75.9%,对照 VIM 74%、Fast 73%;移除世界记忆分支为64.4%,仅轨迹67.3%,随机球面视角70.2%。但 Long 子集41%低于 Fast 的44.2%。 遮挡基准与消融 ↗
我的解读平均收益与消融支持有用的视角先验,但长任务并非全部改善,不能用均值掩盖失败场景。
来源证据RLBench 10任务、3次运行平均76.5±1.1%,对照75±1.2%;个别拼图和积木任务只有1.3%和12%。LIBERO-Plus总体62.4%,但背景变化61.1%低于对照81.4%,噪声变化60.7%低于79%。 更广泛泛化 ↗
我的解读世界模型不自动解决精细控制,也可能在视觉扰动下引入额外偏差;总体泛化成绩不能替代分类型报告。
来源证据ARCHERY6 GP100 上3个任务、各30次测试,总计85/90成功,约94.4%,对照为73/90;训练每项100条演示。虚拟视角从21增到28时仿真75.9%到76%,收益很小。 真实机器人实验 ↗
我的解读实机结果有支持,但只有一种平台和有限任务;增加想象视角存在饱和,不宜据此承诺跨硬件或实时性能。
开放情况与使用许可
论文 CC BY 4.0;正文表示代码将在接收后发布,本轮没有核实可获取实现或权重,保留为论文公开。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将世界模型作为可检索的观察记忆,而非要求动作策略自己重建所有隐藏视角,是可通过消融检查的组合方式。
反方 · 哪些结论还不够
依赖标定与初始深度,生成视角可能幻觉;固定整回合的记忆无法保证跟上物体移动。缺少足以支撑实时宣传的统一端到端延迟证据。
综合判断
对遮挡下的局部操作值得关注;应将想象记忆作为带不确定性的辅助,而不是可替代实测的完整场景真值。
我会先做的验证
未执行的验证方案:在初始记忆生成后移动目标或替换隐藏物体,检查策略是否能由实时观察纠正记忆;与真实主动观察、置信度门控及等计算量无记忆基线比较。