BlenderWorld:验收3D agent,不能只看它选的那张图
可编辑工程、内部结构和多角度效果,如何一起打分?
该基准用223个现实制作请求评估13个agent,要求提交可编辑.blend与指定媒体。新视图、场景内部检查和冻结评分准则共同揭露“正面看似正确、侧面却消失”的二维捷径。
图解主要方法
可编辑工程、内部结构和多角度效果,如何一起打分?
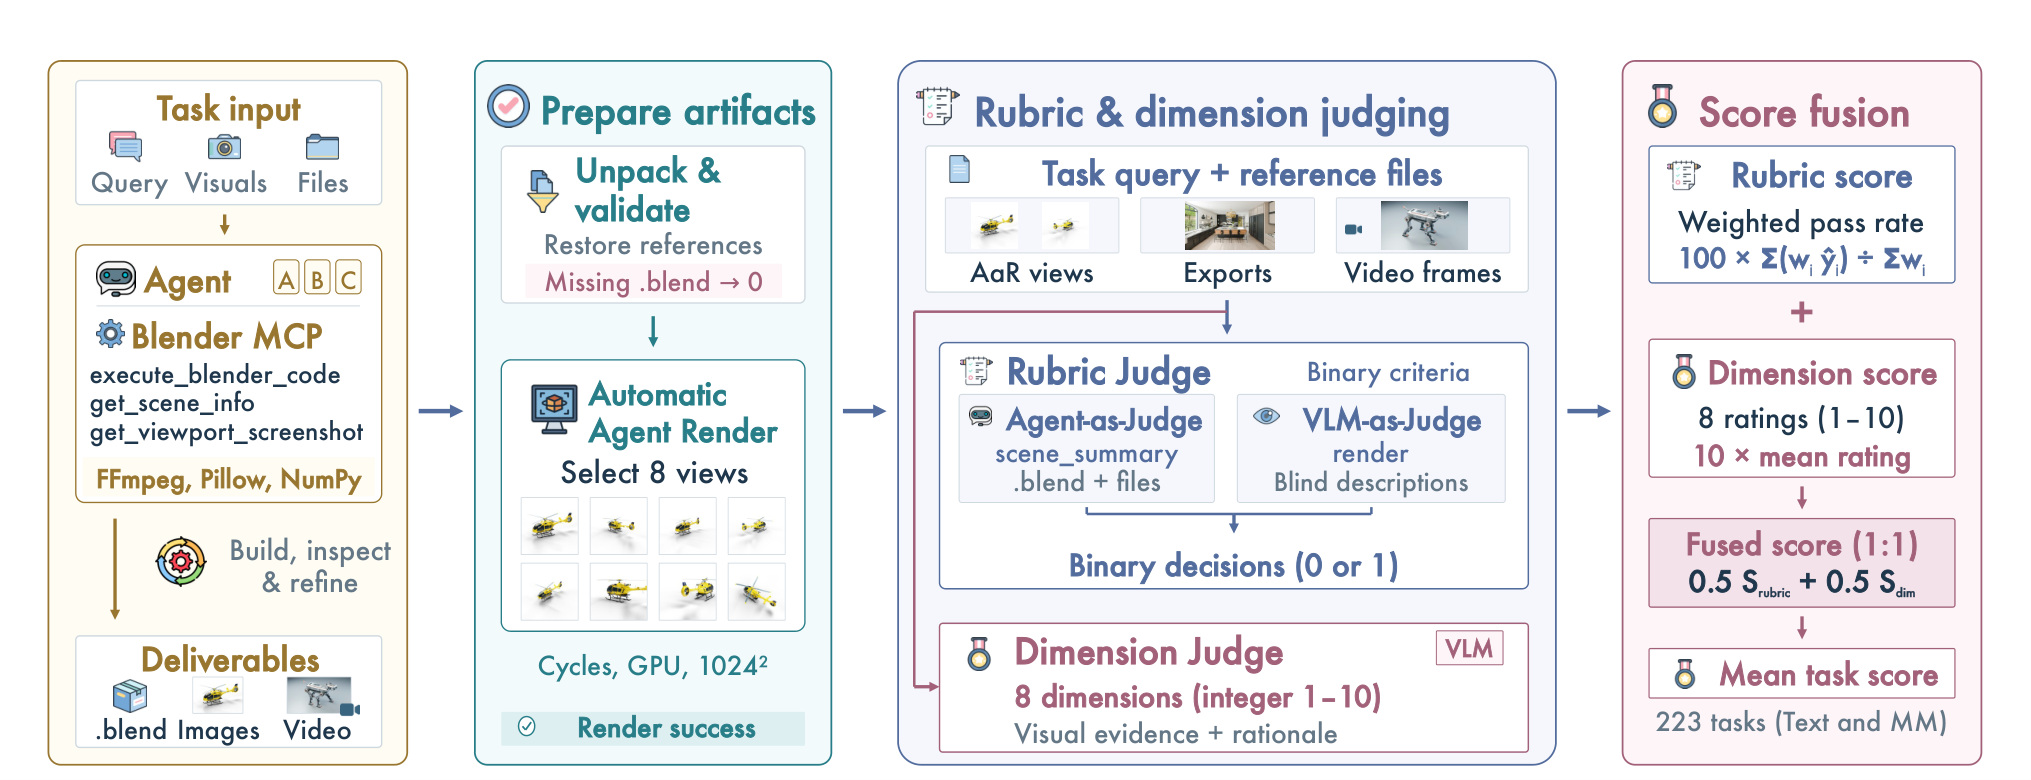
- 1
先把制作需求变成可验收条目
文本、图片、视频及尺寸/材质附件覆盖9大类;独立模型检查任务一致性,再形成2,651个二元标准。每条记录来源、重要性与应从渲染还是原生场景获取证据,评分规则对生成agent不可见。
- 2
图4:独立重渲染八个视图
评估agent在隔离环境打开项目,用Cycles、1024²、64采样选择8个互补视图;只可调相机与渲染设置,不得修复几何、材质、光照或动画。无.blend直接零分。
- 3
视觉与结构走不同证据路线
可见外观由VLM判断,精确尺寸、拓扑、原生属性由工具agent检查。原提交媒体与新视图冲突时按协议保留原媒体优先;不支持的断言记零,不能凭好看补足结构证据。
- 4
分别报告功能和质量再融合
二元标准按3/2/1加权,八个视觉维度各1–10分;二者等权组成总分。还报告全部标准通过率,避免平均高分掩盖一条致命交付缺失。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据GPT-6-Astra总分79.9、全部条目通过42.2%;Opus-5为73.0/25.6%。前两GPT用Codex,其余多数用Claude Code。 Table 2,223任务每模型单次 ↗
我的解读是完整agent系统比较,框架与模型未解耦;单次运行不能估计重跑波动。
来源证据150对作品经3人判断,排除3对无多数票,主judge与147对人类多数偏好一致82.99%;小分差70对降至68.57%。 Appendix E.1 人类对齐 ↗
我的解读自动裁判能作规模化筛查,但接近的分数尤其不能当确定优劣。
来源证据有人物贴在平面卡片上而侧面消失;另有自检将150毫米木腿误改为木腿加脚轮总高,实际木腿仅102毫米。 Appendix E.8/9 失败轨迹 ↗
我的解读精确代码和多次看图不保证目标正确。纹理贴图可以掩盖体积缺失;材质/UV烘焙实例仍需逐任务原生检查。
开放情况与使用许可
GitHub含blenderworld评测代码,MIT;HF数据仓库有任务、参考图、评分脚本等实际文件,卡片标MIT。引用图片和第三方资产的来源权利仍需分别核对;未运行付费模型评测。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把编辑性、几何和交付验证摆到视觉评分旁边,贴近资产生产中的验收需求。
反方 · 哪些结论还不够
裁判模型、任务覆盖与工具框架带来偏差;专业拓扑、UV接缝、PBR通道、去光照和重光照并非每项任务都有强制检查。
综合判断
值得用作自有3D工作流评测起点,榜单不能取代逐项资产验收或专业美术审核。
我会先做的验证
未执行的验证方案:补充固定的UV接缝、法线、PBR贴图与换光照用例;跨相机检查体积,改变rig参数验动作,并在固定框架下多种子复测。