CameraEditor:把相机参数编辑拆成一段视频
回顾补收:参考路由与中间视角,不等于三维相机平移
CameraEditor 将俯仰、横滚、视场角和镜头畸变变化拆成连续中间帧,用视频先验生成最终编辑图。它还能从全景图池选出经历相同相机操作的参考片段;实验锁定 yaw,不支持真实三维平移产生的视差。
图解主要方法
图 3 为什么同时需要一条输入编辑序列和另一条参考序列?
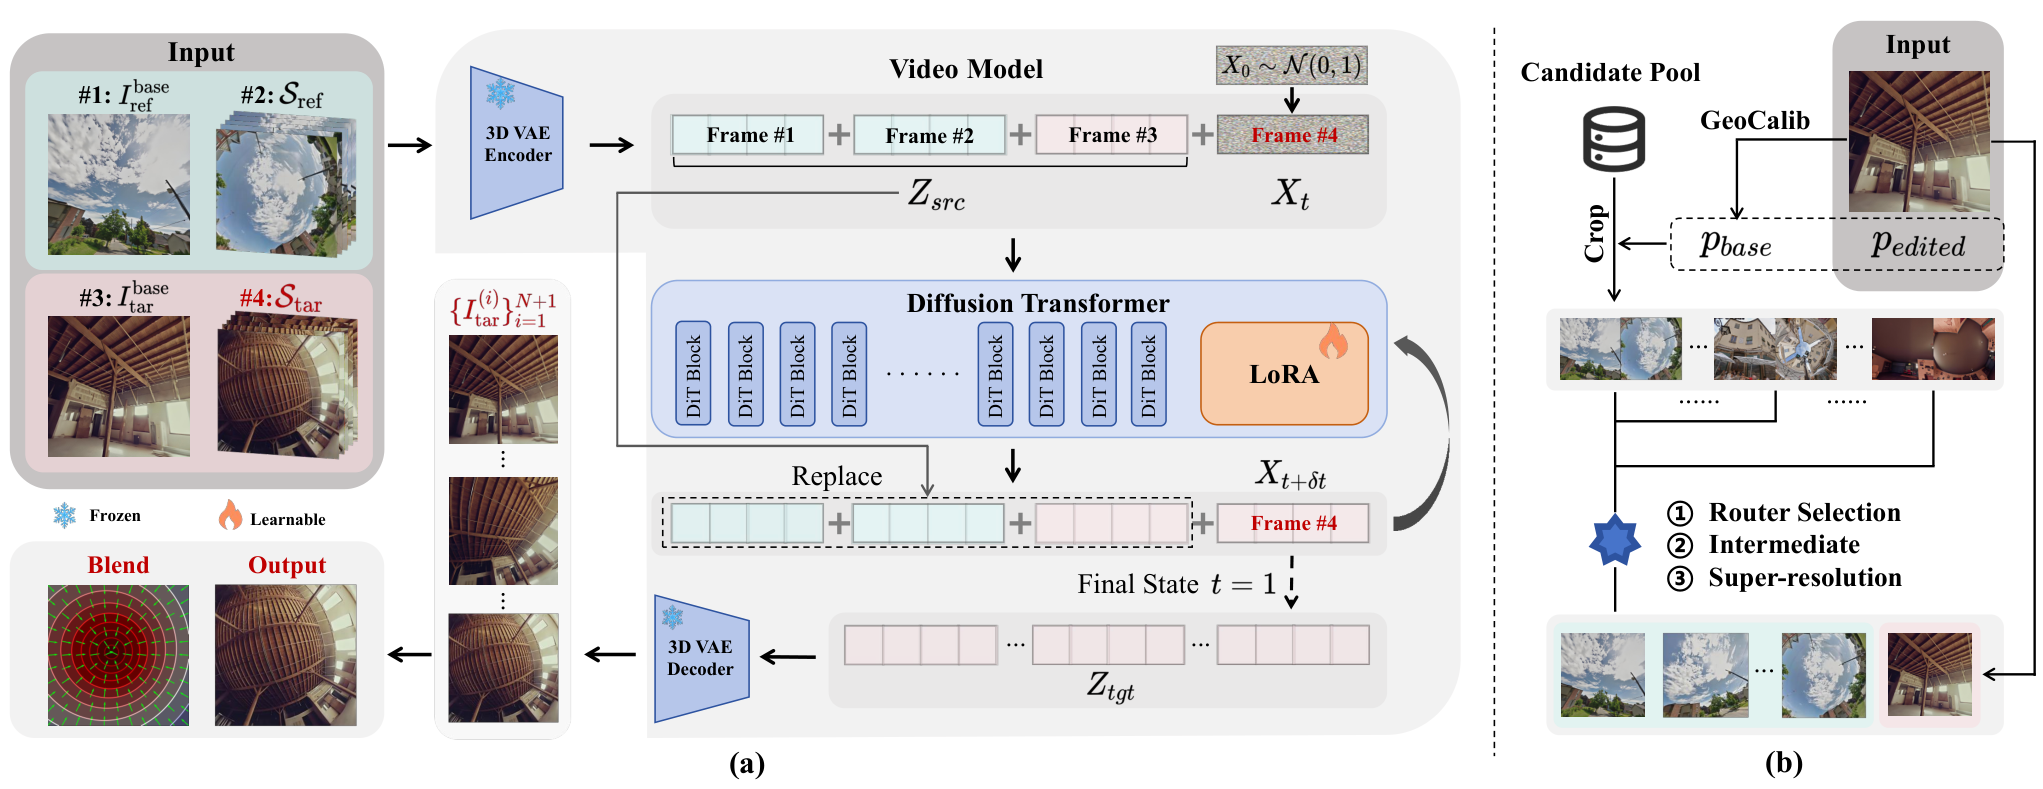
- 1
先估计输入相机,再选择同操作参考
GeoCalib 估计相机参数;在与测试场景分开的全景候选池中施加相同参数变化,构造参考序列。Qwen2.5-VL-7B 按五个维度评价,取最低维分数作保守筛选;参考承担相机运动示例,不是输入场景的真实三维观测。
- 2
用中间参数把大编辑拆开
将输入到目标的变化插值为八个中间步骤加目标,共九帧以符合视频 VAE 的 4n+1 约束。输入和参考分别形成对应序列,帮助模型把大角度或广角畸变变化理解为连续过程;不引入深度感知的三维平移。
- 3
借视频扩散学习条件对应
基于 Wan2.1-T2V-14B,使用 rank 32 的 LoRA 和 512 分辨率 flow matching 训练。图左两条序列编码后按时间组织共同进入 DiT;每步把条件帧潜变量恢复到固定输入,避免源图被噪声漂移,最后取目标帧作为图像输出。
- 4
用透视场检查几何,但保留估计器依赖
PF-I 比较生成图与真值图估计的透视场,PF-T 比较生成图估计场与目标参数对应的解析场。评测不用再优化相机参数,并不代表无估计器偏差;GeoCalib 对反光或缺少线索的图像同样会失败。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【数据与对照】5760 训练样本来自全景投影,462 测试样本及参考池使用不同场景;同 Wan 骨干的无参考/Plücker/完整方法 DINO 分数为 0.6951/0.7617/0.8569。 数据构建及主表 ↗
我的解读我的解读:支持参考序列的帮助,但全景投影不是实拍平移新视图,分布不同于任意复杂遮挡场景。
来源证据【中间帧消融】零中间步骤的目标仰角误差 0.1669,八步为 0.1904,越低越好;SSIM 则从 0.5181 到 0.5712。 序列长度消融 ↗
我的解读我的解读:更多中间步骤改善外观却未同步改善全部几何指标;十二步出现进一步漂移,不能声称越长越好。
来源证据【用户与速度】300 次盲比较,三个基线各 100 次,平局计半;H200 上参考路由约七秒、生成 46 秒、合计约 53 秒。 用户研究与效率附录 ↗
我的解读我的解读:偏好不是严格的三维身份保持;路由成本应计入资产编辑等待时间。细纹理模糊仍是报告局限。
开放情况与使用许可
首发 09-01,按回顾补收。已检查官方 GitHub:仓库为空;Hugging Face 的 CameraDiT 模型和 CamEditor-Bench 数据页目前只有 .gitattributes,没有权重或数据。因此不标开源或可复现实现。
LICENSE论文 CC BY 4.0;代码、模型、数据暂无可核实的有效发布许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把连续相机操作转化为视频条件,能比含糊文字指令更直接地控制成像参数,适合二维概念视图制作。
反方 · 哪些结论还不够
相机姿态变化不覆盖三维平移;全景合成数据、校准器误差和细节模糊限制真实几何保真。
综合判断
可用于视觉资产的相机外观编辑研究,不能代替几何重建、UV 编辑、多视角一致资产或物理材质生成。
我会先做的验证
未执行的验证方案:使用已标定相机和实物资产,分别测旋转、变焦、畸变与不支持的平移条件;将估计透视场、真实重投影误差和人工身份偏好分开,检查高频纹理与遮挡边界。