CausalAlign:视频模型懂相机运动,为什么仍会漂移?
先定位运动信息流失的层,再用三维状态变化约束适配
CausalAlign研究生成视频中的自运动信息如何在网络中丢失。它先用探针与干预定位相关层,再把三维教师的连续状态差映射到视频模型特征,最后只用LoRA对齐选定层和去噪时刻;推理不需要额外三维缓存。
图解主要方法
先定位运动信息流失的层,再用三维状态变化约束适配
- 1
图2之前的诊断:可解码不等于被使用
对冻结Wan特征做线性探针,并通过遮挡、打乱、替换和范数匹配注入检查运动信息的作用。方法据此选择信息衰减的层与时间位置;这种因果结论仍受干预设计限制,不能从一个探针高分推断模型已有稳定三维理解。
- 2
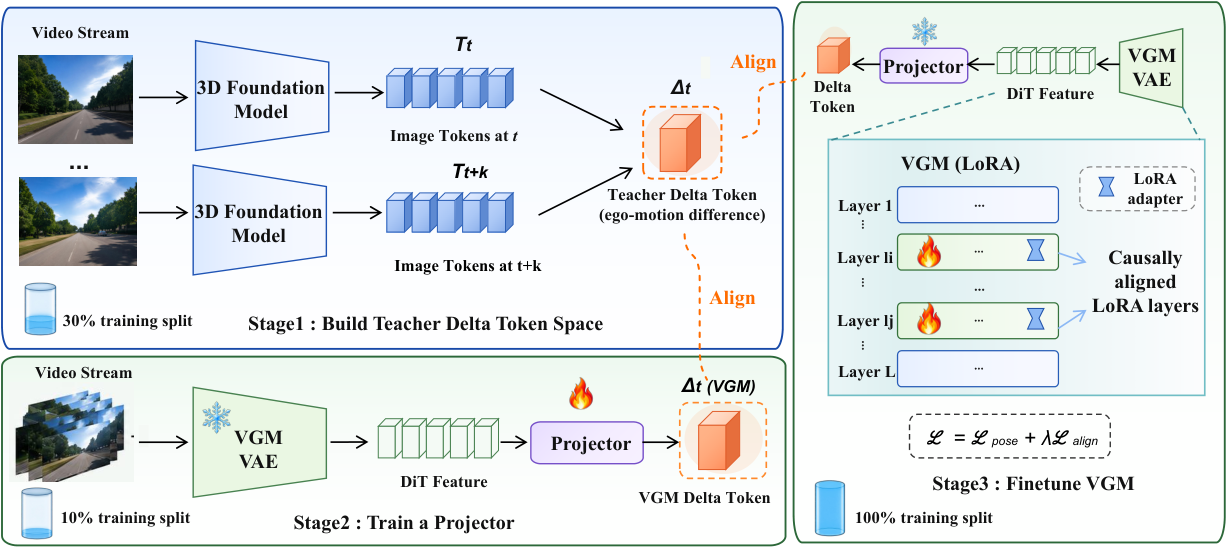
图2左上:建立变化量教师
以LingBot-Map三维特征训练128维delta表示,分成64维相机、40维几何和24维视觉,通过状态重建、下一步变化与位姿目标保持动态语义。教师依赖估计出的几何,不是直接获得世界真值。
- 3
图2左下:冻结两端,训练投影
先用训练场景子集学习三维教师,再取另一训练子集,将冻结视频生成模型的相邻时间特征投影到delta空间。投影器学的是对应关系;90/10场景划分与30%、10%、100%阶段用量需同时保留,避免把所有阶段误认为同一数据预算。
- 4
图2右:选择性LoRA对齐
冻结教师与投影器,在选定层以位姿和0.2权重的delta损失训练LoRA。398、799是去噪进度索引,不能直接当原生scheduler时刻。推理沿原视频模型,不需要三维教师在线参与;代价主要转移到训练侧。
实验与证据
已阅读正文及附录A–C,核对实验条件与原图;未独立复现。
来源证据重投影误差8.4→6.5像素,平滑指标0.71→0.88;深度光流误差5.5,略差于Fantasy的5.4,FVD从182.4到182.7也未改善。 视频主表:Wan2.2-I2V-A14B ↗
我的解读支持特定自运动一致性提升,不是所有视觉与几何指标都提高;额外轨迹输入的基线也不完全等条件。
来源证据Human300预训练、每任务500示范、Target100设置下,三类任务均分43.5→54.2;原子任务18项、各50次中为703/900,即78.1%。 FastWAM扩展:动作结果 ↗
我的解读改进能延伸到所测动作模型,但组合任务40.8/40.6仍低于ABot的44.3/45.6,不能只展示原子任务收益。
来源证据32个场景配对比较中,选定层收益3.109,95%区间[0.808,5.373],随机层为2.224,[0.302,4.022];时间调制三种种子的区间包含0。 配对定位与时间消融 ↗
我的解读选层有方向性证据,但与随机层优势并非由两个各自正区间就得到显著结论;时间模块收益尚不确定。
开放情况与使用许可
已核对官方仓库实际causalalign、configs、tools、wam与tests目录,代码Apache-2.0。README要求另取Wan与LingBot等模型和数据,未核实已训成品适配权重;未运行训练或复现。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:先找问题发生的位置再施加轻量约束,比仅给视频打整体一致性分更有诊断价值,也保持推理接口简洁。
反方 · 哪些结论还不够
三维教师及评估器可能共享偏差;运动表示受模型架构和探针约束。时间调制与随机层比较证据有限,视频感知一致性仍不是接触物理和长程规划保证。
综合判断
适合研究自运动保真与视频到动作的表示迁移;需要更独立的几何测量确认,而不是把所有漂移都归于单一层。
我会先做的验证
未执行的验证方案:固定LoRA秩、更新步数和训练场景,随机层、选定层及均匀时间采样做多种子比较;用独立相机真值评估回环轨迹,并单独报告动态物体和无纹理场景退步。