CausalDreamer:把视频潜变量按可控性与奖励相关性分成四组
背景变化下规划改善,迷宫换布局全线下降;四组命名还不是因果可辨识证明
CausalDreamer 保持视频tokenizer冻结,用四个投影头将其潜变量重编码为可控/不可控与奖励相关/无关的组合,再微调MMBench2动力学模型。熟悉任务和部分视觉/物体变化上的归一化回报提升,但新环境仍接近或低于随机,且动力学阶段没有维持四组的结构限制。
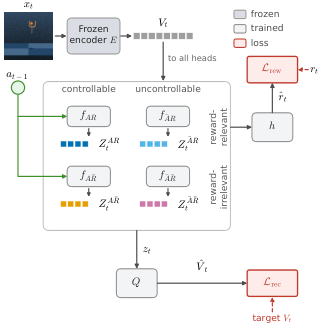
图解主要方法
能否在不改视频tokenizer的情况下,让世界模型潜变量更适合根据动作与奖励规划?
- 1
冻结图像tokenizer
MMBench2的Dreamer4式350M基础模型,将224²图像编码为64×64潜变量。tokenizer原本只做像素/LPIPS重建,不直接利用动作和奖励,整个适配阶段保持冻结。
- 2
四头重编码全帧潜变量
每个MLP读取全部4096维潜变量,输出四分之一维度;两可控头额外拼接前一步动作,另两头不显式接动作。它不是把原token固定切片,也不是屏蔽图像里已有的动作后果。
- 3
联合重建与局部奖励预测
四组拼回原形状,由残差MLP重建原潜变量;只让两个奖励相关组输入辅助奖励头,以重建+0.1奖励损失训练。无关组没有去奖励或独立性惩罚,名称是设计意图而非已证明语义。
- 4
冻结分解层,微调动力学
沿用原shortcut forcing与奖励目标学习四组未来;架构不变,所有组仍能注意动作,动力学奖励头读全部组。行为克隆头梯度截断,不更新动力学骨干。
- 5
在潜在未来做CEM规划
256候选、32精英、4迭代,预测32步累计奖励,每执行16步再规划。真实历史最多约24帧,任务文本嵌入供agent token,预测经残差解码器与冻结图像解码器可还原视频。
实验与证据
全文39336字符、附录A局限和B相关工作读完;图1原图视觉核验,首发CC许可与代码检索核实;无实验复现。
来源证据训练正文写200任务、10域、每任务260episode,RGB224²与动作/奖励;附录介绍基础数据为210任务427h。 4.1;附录B ↗
我的解读基础语料总体与实际训练子集口径不同,未给完整清单时不能擅自合并为全210任务训练。
来源证据表示阶段30000步、batch256个24帧clip、72 A100-40GB小时;动力学同30000步为140小时,对照143小时。 4.1 ↗
我的解读分解还有额外训练开销;clip按有效起点均匀采样,长任务获得更多样本。
来源证据干净10任务均分0.199对预训练0.175,匹配微调0.167;随机均值归0,专家示范最佳回报归1。 表1 ↗
我的解读提升0.024约14%相对变化,不是14pp成功率;本文归一化锚点与MMBench2报告不直接可比。
来源证据6种扰动均分0.307对0.246;两背景变化和香蕉替方块改善,三种迷宫布局全部下降0.020–0.120。 表2 ↗
我的解读25%相对均分提升不能概括成任意分布外变动都更强。
来源证据4新环境均分−0.055对0.028;foraging为−0.341对−0.095。 表2 ↗
我的解读尚未掌握全新环境,部分比随机更差;不能只报告扰动集。
来源证据每任务20环境种子同模型配对;干净集matched control正文限定其前10种子,无显著性检验。 4.1、4.2;附录A ↗
我的解读环境种子不是独立训练重复,且对照样本数量未完全匹配。
来源证据两背景任务各10种子×96步,同模拟器状态和动作;变化79%/74%落奖励无关组,原token对应切片44%/46%。 图3;4.4;附录A ↗
我的解读支持背景差异较少进入奖励预测所用组,但奖励相关组仍有21%/26%变化,且未检验反方向泄漏或动作可控性。
开放情况与使用许可
论文实际公开,未核实该工作的官方实现、四组投影权重或微调模型发布。基础MMBench2的资源不等于CausalDreamer已开源。
LICENSE论文与图1为CC BY 4.0;该方法实现和权重许可未核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
包含同数据同微调步数、未分解潜变量的对照,尝试区分多训练与表示收益。
背景干预保持模拟器状态、动作和奖励一致,比只看潜变量可视化更具体。
逐任务公开结果并承认新环境失败及结构约束只存在表示训练阶段。
反方 · 哪些结论还不够
不给不可控头显式动作,并不阻止它从动作影响后的图像潜变量中编码可控信息。
动力学所有组都能看动作,奖励头看全部组,最终规划并未严格使用所称因果分解。
只重建+奖励预测可存在多种等价编码;无独立性或辨识约束,不能声称四组恢复真实因果变量。
匹配对照训练步数相同但少一个表示阶段、评估种子数也不同,尚非完整等成本配对实验。
综合判断
对生成式世界模型增加奖励导向表征是有用尝试;现有证据支持部分背景/物体扰动鲁棒性,尚不支持可控性解耦已被证明或普遍新环境泛化。
我会先做的验证
建议实验(尚未执行):用完全相同20种子和总GPU时长比较,分别消融动作路由、奖励损失与四头结构;干预动作并测各组响应,在动力学加同样注意力掩码,检验奖励信息是否泄漏到无关组以及规划收益。