CoDeR:用可执行世界状态约束视频生成
代码维持状态,生成模型负责画面,二者如何对齐
CoDeR 将世界分成代码维护的逻辑状态和视频模型生成的外观,再把已看到的画面注册回三维表面。这有助于离开视野后的状态连续性,但显式代码规则与视觉一致性不等于已验证的真实物理模拟。
图解主要方法
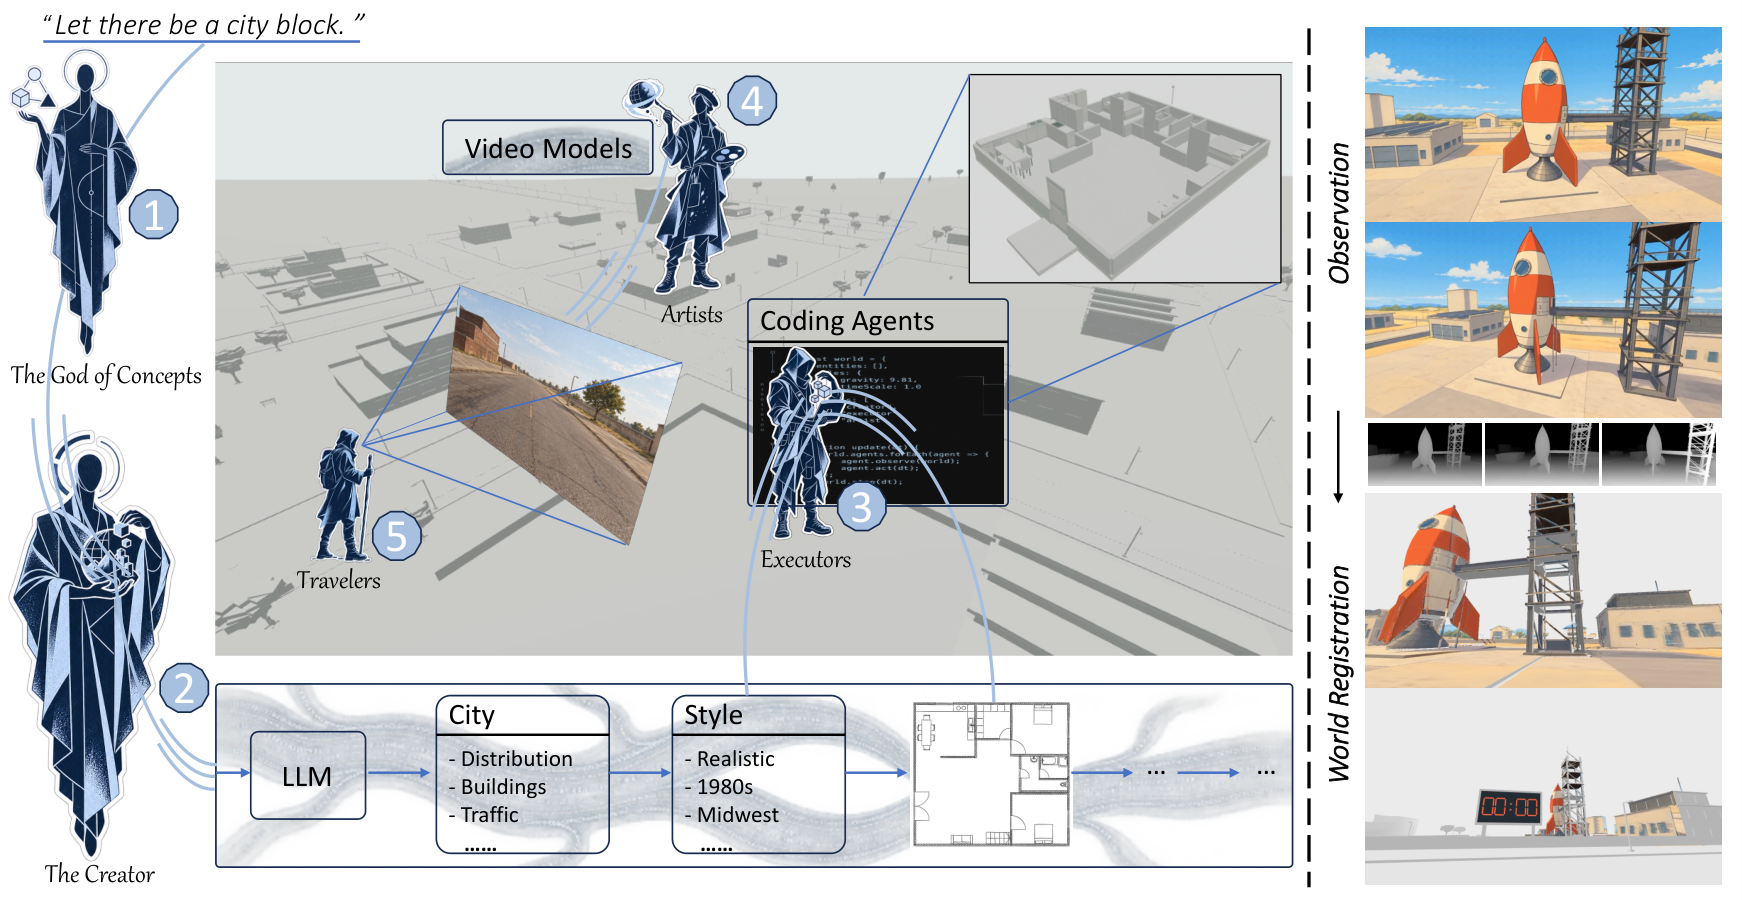
图 2 的五个角色如何让“看过的世界”影响下一段生成?
- 1
从概念生成可执行空间
用户提出概念,Creator 规划功能空间与对象、接口和连接图,Executors 编写 Three.js 世界。空间按职责而非必须互不相交的房间划分;代码维护离屏资源、物体状态等,GPT-6-Astra 用于代码创建。
- 2
用白模与控制信号指导视频外观
Artist 以 MiniMax-H3 生成视频,接收代码世界提供的几何和相机信号。Visual Cue Hacking 利用边缘、深度控制生成风格化训练配对,缓解白模轮廓与真实图像域不匹配。
- 3
将生成画面注册回三维表面
利用代码几何和相机将 RGB 回投到表面,检查可见性与是否同一表面,融合已观测外观。这个缓存提供外观记忆,但 RGB 可能混入光照与阴影,不是已分离的反照率或标准材质。
- 4
以部分注册渲染构造后续上下文
Traveler 移动后重新渲染已注册部分,作为下一次生成的约束;未观测区域仍需补全。它把持久代码状态和连续外观连接起来,长期漂移仍可能在注册与再生成中积累。
- 5
区分结构控制与物理真实性
对象交互和状态由代码规则执行,视觉模型补细节。代码可以减少“忘记物体”,却可能包含错误碰撞或简化行为;材质分解、PBR 参数与高保真物理需要额外工作,不能仅靠画面连贯证明。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【训练】MiniMax-H3 的 LoRA 与 ControlNet 适配,32 张 A800、200 步、batch 16,输出 1280×704、124 帧。 实现细节 ↗
我的解读我的解读:短适配步骤不包含基础视频模型和代码生成的全部成本。
来源证据【WorldScore】十项汇总 87.88,报告的 LingBot 74.79、Matrix 74.20、ABot 69.24。 WorldScore 实验 ↗
我的解读我的解读:输入经 SAM3、Depth Anything V2 与代码模型转换为近似场景,给系统增加结构化模拟信息;不能当作同输入纯视频模型的直接替换结论。
来源证据【用户研究】三十份有效问卷支持所展示世界的偏好。 用户研究 ↗
我的解读我的解读:样本量和展示选择限制外推,不替代独立交互成功率及规则正确率。
来源证据【长时行为】约五千帧之后展示出视觉退化;文中仍报告手形、碰撞与物理细节限制。 长期生成与局限 ↗
我的解读我的解读:外部持久状态改善连续性,并未消除长时生成误差,也没有完整端到端延迟与费用表。
开放情况与使用许可
论文称将发布代码及权重;作者所列项目页本次返回 404,未核实实际发布制品。
LICENSE代码、模型许可待发布核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把世界状态交给可检查代码,外观交给生成模型,再用表面注册闭合信息循环,是有解释力的系统分工。
反方 · 哪些结论还不够
结构化输入改变对照条件;注册 RGB 不等于材质恢复,代码规则也没有充分真实物理验证。
综合判断
适合研究交互式生成环境和持久状态接口;若目标是机器人训练,还需要独立物理校准、状态观测与接触验证。
我会先做的验证
未执行的验证方案:固定场景与相机,执行离屏物体移动、资源消耗和回访测试;同时对比代码真值、生成画面、注册纹理与标准 PBR 渲染,测累计漂移和总延迟。