上下文压缩:世界模型忘记房间,先别急着加参数
保留每个地点的最近一次观察,能否恢复长间隔重访记忆?
研究把世界模型记忆拆成模型本身与外部上下文整理。冻结模型前面加一个按地点压缩历史的harness,能明显改善合成房间世界中的长间隔重访;这里的空间坐标和可重排路径先验很强,尚不是通用视觉记忆。
图解主要方法
保留每个地点的最近一次观察,能否恢复长间隔重访记忆?
- 1
图4:外部记录全部历史
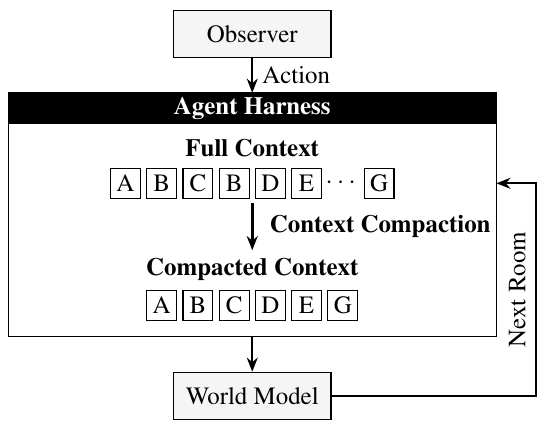
观察者在8×8房间世界移动,每房间16×16瓦片、8种类型。模型每步读8个画面token和1个动作token,原始窗口128步;外部harness单独保存完整会话并按动作追踪房间位置。
- 2
每房间保留最新一次观察
把重复访问压缩成每个地点的一份记录,再构造经过这些地点、结束于当前位置的相邻房间行走序列。采用近似旅行路径方法是为了保留训练时的合法动作-画面关系,不能直接把房间图片任意堆叠。
- 3
冻结模型,只换输入历史
比较每步压缩和窗口填满才压缩,后者平均约50步一次;不重新训练被压缩服务的模型。四个约14M架构分别改变编码/解码、滑窗注意力与共享KV,用来研究不同缓存设计的影响。
- 4
用打乱旧历史隔离真正检索收益
对照将早期历史打乱但保留最近5步,衡量原始上下文相对打乱上下文的准确率差。这个retrieval gain是差值而非预测准确率,避免把模型对最近局部帧的拟合误当长记忆。
实验与证据
已阅读正文及训练、预算、运行时间相关附录B,核对实验条件与原图;未独立复现。
来源证据5000条512步训练轨迹,400评估轨迹,三个训练种子、2万更新、batch4;每个间隔区间40次重访。128–511步间隔原始增益.03–.06,逐步压缩.39–.51,满窗压缩.44–.54。 训练与重访协议 ↗
我的解读有明确负对照与多种子,但图中离散度为标准差而非置信区间;不应写成44–54%绝对准确率。
来源证据生成实验的首次访问仍给真实画面,只在重访时使用模型预测;部分滑窗/共享缓存模型收益不超过.09,另两种约.28–.42。 梦境与误差反馈 ↗
我的解读这不是从第一帧开始完全自由生成,且压缩效果明显依赖架构。
来源证据相同2304向量预算比较中,滑窗固定72向量被忽略,约占3.125%;计时为M4 Pro、float32、30次中位数,压缩还会触发位置变化后的重新prefill。 附录B:预算与运行代价 ↗
我的解读内存与速度优势依赖会计边界,部署时必须把外部记录和重编码成本计入。
开放情况与使用许可
GitHub有实现但未找到根许可证;HF发布多份训练权重且模型卡标MIT。代码授权与权重MIT分别记录,不把一个许可自动套到另一部分。
LICENSE论文 CC BY 4.0;代码与权重许可另见开放范围
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
实验清楚区分近期预测与长期情景检索,说明外部记忆组织可能比简单扩窗更有效。
反方 · 哪些结论还不够
合成网格、已知动作坐标、重复房间与有效路径假设强;真实遮挡、位置漂移和场景变化未验证。
综合判断
值得借鉴的是“按地点保留证据”的设计,不是已解决开放世界持久记忆。
我会先做的验证
未执行的验证方案:加入定位噪声、物体移动和相似房间,比较最近窗口、随机摘要与地点压缩;计入地图存储、重prefill及错误坐标引发的记忆污染。