CoWorld Reasoner:让视频世界模型成为可修订的推理工具
不更新模型权重,改进工具调用与证据解释能带来多大收益?
CoWorld把换视角、插帧、续写和干预封装为视频工具,再逐阶段改进调用技能与执行代码。七个基准加权总分从58.29升至59.69;收益不均匀,生成视频依然可能制造似真却错误的证据。
图解主要方法
不更新模型权重,改进工具调用与证据解释能带来多大收益?
- 1
01 · 先判断是否需要生成证据
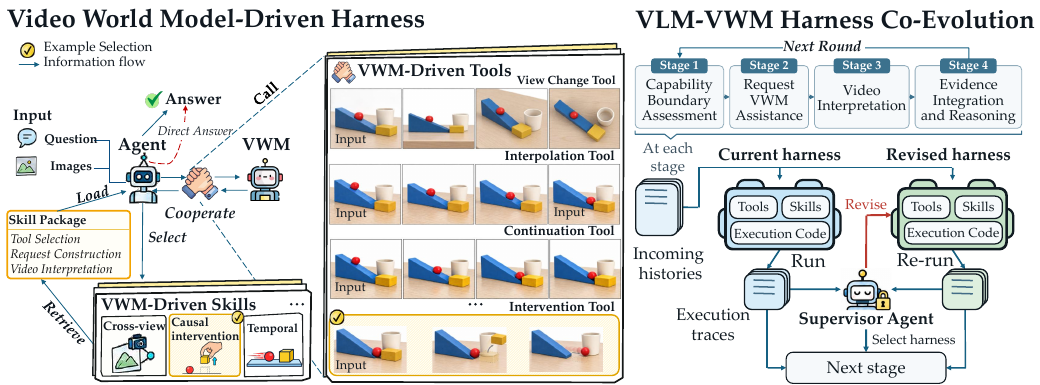
图2左侧代理可直接回答,也可根据跨视角、时序或干预技能选择视频工具。四种操作共享一个视频生成后端;工具输出是合成的候选解释,不是对真实世界的新观测。
- 2
02 · 分开请求、观察与证据整合
流程分为能力边界评估、视频请求、视频解释和最终推理。独立验证器仅观察生成帧,不看原始问题上下文,以减少顺从预期,但它仍无法检验画面没有显示的事件,错误物理也可能被当成证据。
- 3
03 · 在相同输入历史上修订工具系统
监督代理根据执行轨迹修改提示、技能、工具和代码;每个阶段候选从同一进入历史重新运行,选较好的进入下一阶段。共3轮、每阶段最多5次修订,120道开发题从测试中排除;修改的是运行组织方式,VLM与视频模型权重冻结。
- 4
04 · 用冻结方案在多基准评估
主设置以GPT-5.6 Luna承担代理和监督等角色,视频后端MiniMax H3 Max Turbo生成5秒480p视频并抽9帧。最终跨七基准评估,各基准样本量不同;整体分数按项目数加权,不是七个百分比简单平均。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据整体58.29→59.69,增加1.40个百分点;MMSI38.35→42.89,ERQA51.75→58.50。CausalSpatial60.72→60.79,基本持平;部分运动/旋转子项下降。 主结果表:整体与子任务 ↗
我的解读11.8%与13.0%是部分基准的相对提升,不能写成总体增加同样多的百分点。
来源证据120开发题由四个基准各30题组成;最终评测含MMSI970、Spin2709、ERQA400等不同规模,SAT300还包含同题的两种顺序。 开发与评测划分 ↗
我的解读开发题排除降低直接重用风险,但整体权重和重复形式仍应说明,不能当作同量独立任务平均。
来源证据去掉视频工具仍保留四阶段技能系统;更换Grok后又做一轮进化。未提供完整的等计算预算对照。 消融和迁移 ↗
我的解读无视频消融并不纯粹只减少一种证据;迁移结果也不是零适配迁移,更不能把额外推理成本忽略。
来源证据示例中生成卡车离开画面后,代理据此前片段推断移除花瓶足以避免事故;后续不可见轨迹仍不确定。 附录A9完整轨迹 ↗
我的解读这是需要人工审视的证据边界:生成器与解释器一致,并不等于因果结论已成立。
开放情况与使用许可
2026-10-18仓库实际含evolved_harness、runtime和评测实现,LICENSE为MIT;开发集有dev120.parquet实体文件。依赖托管VLM/FAL服务,不是所有基础模型开源;开发集复用原基准内容仍需遵循上游许可。本站未调用模型API复现。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
贡献在于让视频工具选择、请求和解释共同优化,且保持模型权重固定;阶段重跑可帮助定位工作流为何改善。
反方 · 哪些结论还不够
整体增益较小且分布不均,工具生成物理错误会被传递;未匹配完整调用成本。独立验证器不见原始场景也会限制可核查范围。
综合判断
支持“视频可作为有条件的推理辅助”,尚不支持把合成片段当作可靠事实或通用因果模拟器。
我会先做的验证
未执行的验证方案:固定总时延和调用费用,对直接回答、额外文本推理、真实模拟器和视频工具做盲评;统计错误视频是否翻转原本正确答案,以及拒绝使用不可靠证据的比例。