DreamTrue:用反事实动作训练机器人世界模型,减少“没抓住也成功”的幻觉
先校准视觉动作,再用三类缺陷奖励后训练;物理可信仍受图像视角限制
DreamTrue把机器人动作渲染成多视角条件,通过离线几何校准减少动作与图像错位,再扰动动作末端构造没有真实未来的反事实样本。人类缺陷标注训练的奖励模型对机器人、物体和交互分别评分,推动视频生成器减少虚假抓取成功和悬空物体。
图解主要方法
如何避免机器人世界模型把未抓住物体的动作,预测成看起来成功的操作?
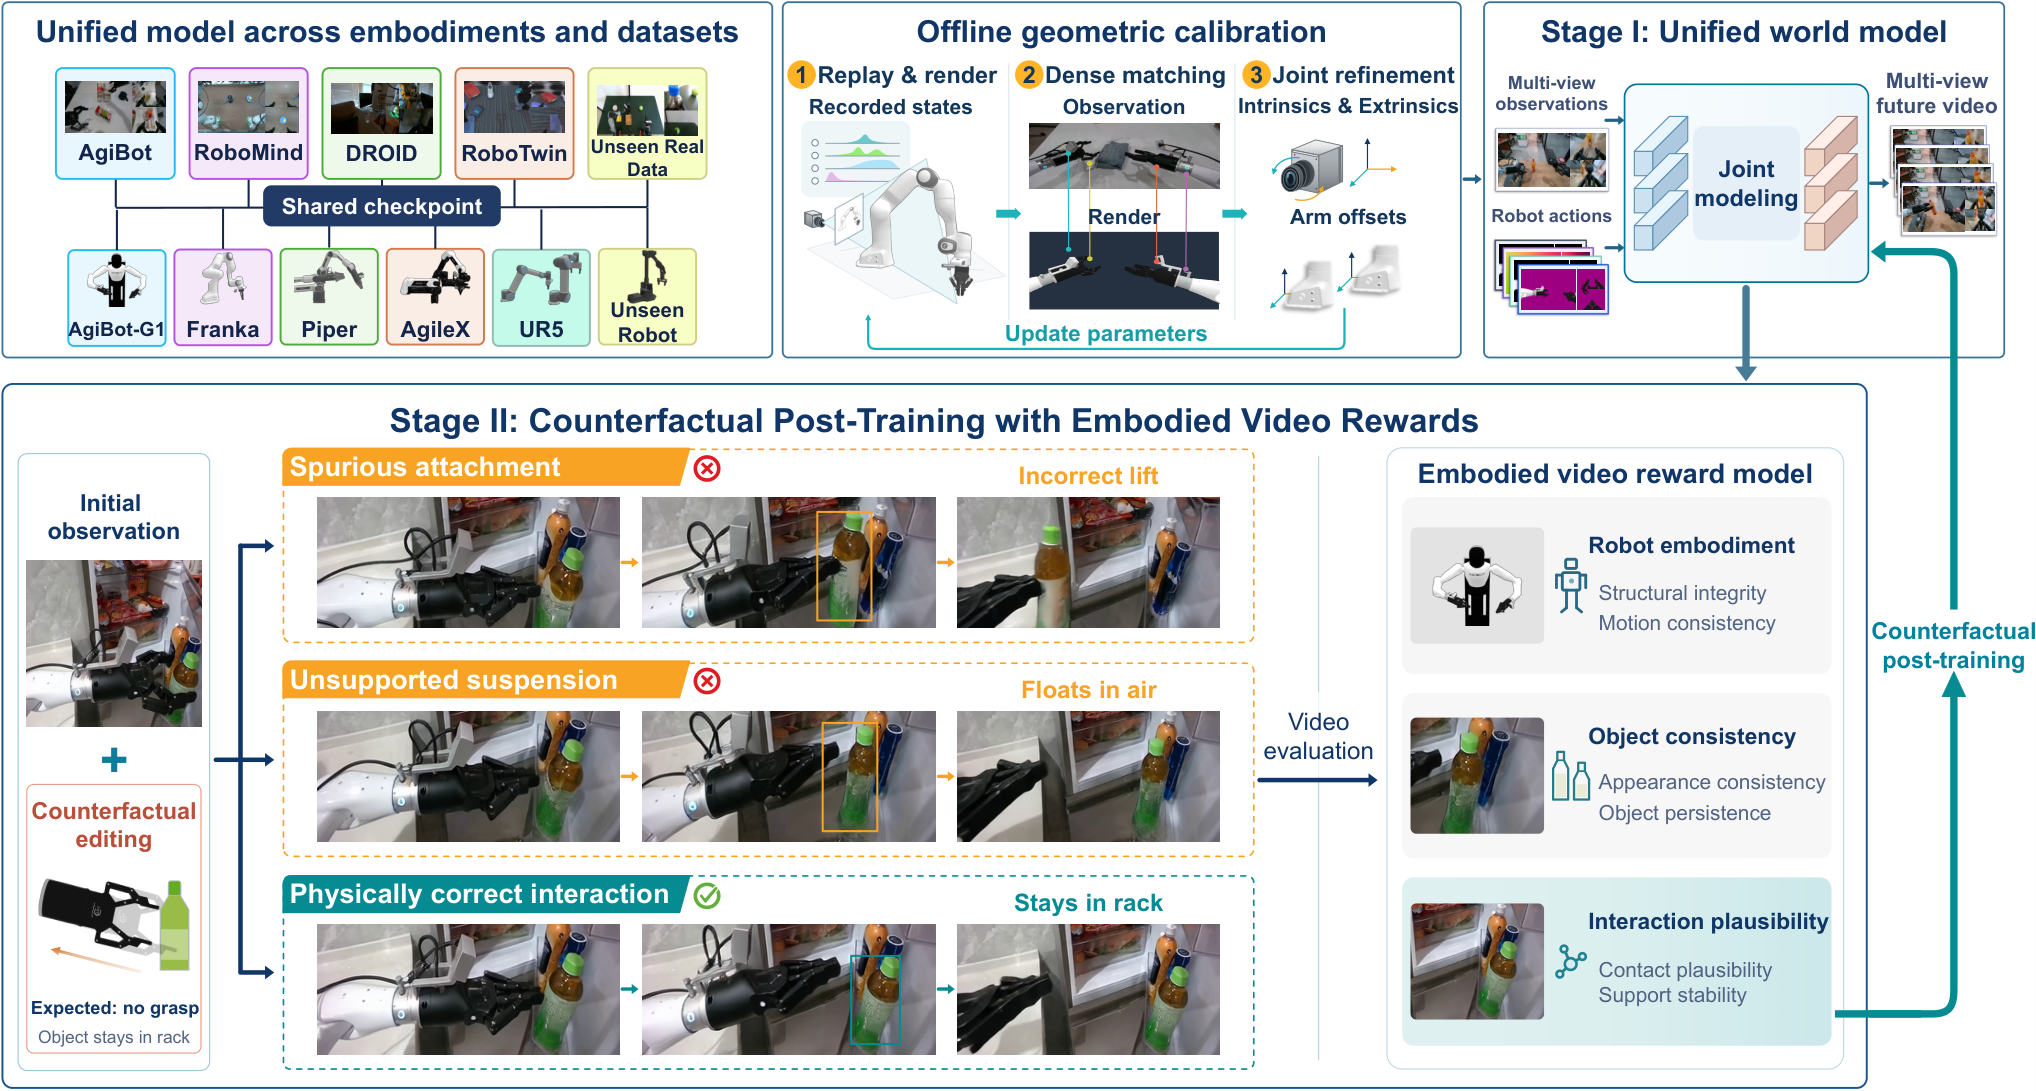
- 1
从已有录像反推更准的机器人与相机几何
按URDF和记录状态渲染机器人,用RoMaV2匹配渲染与观察、跨时间静态背景、同步相机。SAM3掩码限制手臂匹配,联合优化内外参、畸变及必要的安装偏移;重投影与射线共面约束互补。
- 2
把不同机器人的动作统一成图像条件
渲染RGB、深度、amodal掩码和Plücker射线图,左右夹爪开度写入背景红绿通道。RGB和深度经视频VAE,掩码与射线经3D卷积,在VACE分支给DiT注入残差,多视角潜变量按宽度拼接。
- 3
先用配对视频学习动作条件预测
Wan2.1-VACE-14B初始化,三视角每视角240×320、101帧,给第一帧和指令预测余下100帧。四数据集过滤后2232小时;Stage I训练LoRA分支和几何编码器,先学会跟随与还原。
- 4
固定初始场景,修改未来动作
对末端最终位姿加SE(3)扰动,从初始位姿插值并逆运动学求关节序列,只保留运动学可行条件。相机固定标定不变,腕部视角随修改动作重算;没有配对真实未来,不能用像素误差监督这些反事实。
- 5
用独立缺陷奖励后训练
Qwen3.5-9B读视频,以机器人结构、物体一致性和接触响应三类缺陷概率的负值作为奖励。各奖励组内独立归一化、等权合并;有真实未来的记录动作额外加0.5权重PSNR,再由DiffusionNFT更新DiT/VACE LoRA,冻结几何编码器和奖励模型。
实验与证据
完整阅读76362字符正文、参考文献及附录A–E,视检原图1,核对官方项目、GitHub实际文件和ModelScope内嵌数据卡。未运行生成、标定或训练。
来源证据AgiBot记录动作800留出episode:nDTW 0.8711→0.8772,PSNR22.66→23.06;反事实160条件覆盖54任务。 表1、附录B.2/C.1 ↗
我的解读动作轨迹一致性与物体交互分开测,nDTW只衡量夹爪轨迹,不是物理正确率。
来源证据同160反事实条件交互缺陷48.12%→6.25%,后者Wilson95%区间[3.43,11.12];物体缺陷31.88%→3.12%。 表1、表8–9 ↗
我的解读六模型960视频均三人盲评,多数投票;总体κ0.7817。与自身SFT差异大,但相对GE-Sim2.0的7.50%不能仅凭点值判显著。
来源证据后训练EWMScore-P由72.84降至72.51,视觉项70.73降至69.30,控制项87.79升至88.09。 附录表7 ↗
我的解读奖励改善特定缺陷不代表所有感知质量都提高,应保留这组权衡。
来源证据校准后AgiBot同步末端误差7.73→4.60像素,DROID11.78→8.06;只改推理条件也有改善。 表4、附录A.2 ↗
我的解读分离了推理时条件对齐和重训收益。评估episode可额外校准但不使用预测区间真值帧;真实部署仍有标定成本。
来源证据奖励模型31600训练视频、4893验证视频,按源episode分割;平均准确率86.33%、macro-F1 74.21%。L1准确率96.69%而macro-F1 69.37%。 表5–6、附录B.1 ↗
我的解读类别不平衡使高准确率不足以表示稀有结构缺陷识别可靠。奖励输入无动作条件,仍可能认可与指定动作不相符的视觉合理视频。
来源证据RoboTwin三任务×两视觉设置×四策略×十场景=240轨迹:成功率MAE12.92→7.08个百分点,Spearman0.850→0.937。 图8、表10 ↗
我的解读世界模型读完整已执行轨迹,属于离线结果复现,不是让策略在生成世界闭环运行的同一测试。
来源证据240轨迹中96真成功、144失败;假成功26→12,假失败13→11,偏差+5.42→+0.42个百分点。 表11 ↗
我的解读近零总偏差仍可能正负错误抵消,混淆矩阵显示仍有12次误判失败为成功。
来源证据每个新场景/新机器人设置仅6段定性视频;生成器LoRA rank128、约0.7B可训练参数,Stage II学习率5e-6。 附录A/D/E ↗
我的解读不能把精选迁移片段当作成功率。正文附录未充分披露训练总计算及所有调度细节,完整复现实验仍需更多信息。
开放情况与使用许可
已核实GitHub有calibration、reward、wmvideo实际代码;wmvideo明确是推理发布,不含生成器训练代码和基础权重。ModelScope卡列双LoRA、奖励权重及mini数据包,完整标定集、SAM3检查点和全部缺陷标注仍标Coming soon;未下载大权重验证运行。
LICENSEModelScope数据卡标Apache License 2.0;GitHub根目录未见LICENSE,API许可字段为空,因此不推断整个代码库都获相同许可。基础模型和上游数据另依各自许可。论文原图为arXiv非独占托管,限于方法评论引用。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
160个同条件反事实、三名盲评者和置信区间,使交互缺陷改善有独立于奖励模型的人工证据。
策略结果评价给出240轨迹的混淆矩阵,能直接看到虚假成功减少,而不只报告画质。
反方 · 哪些结论还不够
对GE-Sim2.0的交互缺陷率6.25%对7.50%区间重叠,不能仅凭较低点估计声称显著胜出。
训练奖励标签每视频只有一次标注,L1准确率高但macro-F1较低,稀有缺陷和奖励盲区仍存在。
论文写已发布的大规模数据与当前发布页的Coming soon有差异,现阶段复现完整训练仍缺材料。
综合判断
核心进展是让机器人视频模型更少把失败动作幻觉成成功,并证明几何标定对训练与推理都重要。它提供了有用的视觉物理一致性改进,尚不等同完整动力学模拟器。
我会先做的验证
建议实验,未执行:在有真实反事实执行标签的新任务上固定动作、视角与算力,比较SFT、仅校准、仅奖励和完整模型;加入遮挡、滑移、透明物体与相机扰动,报告有害假成功、校准误差及闭环策略排名变化。