Dual Exam:把Agent决策与世界响应拆开考
独立考试能定位能力缺口,但为什么不能直接解释一次闭环失败?
Dual Exam固定参考环境测Agent,固定动作干预测世界模型,试图将行动选择与状态演化分开描述。其价值在评估设计与证据边界;榜单混合不同任务、预算和评分方式,不能把两个总分相乘估计协同成功,也不能将单次150例零成功推广为所有系统无效。
图解主要方法
独立考试能定位能力缺口,但为什么不能直接解释一次闭环失败?
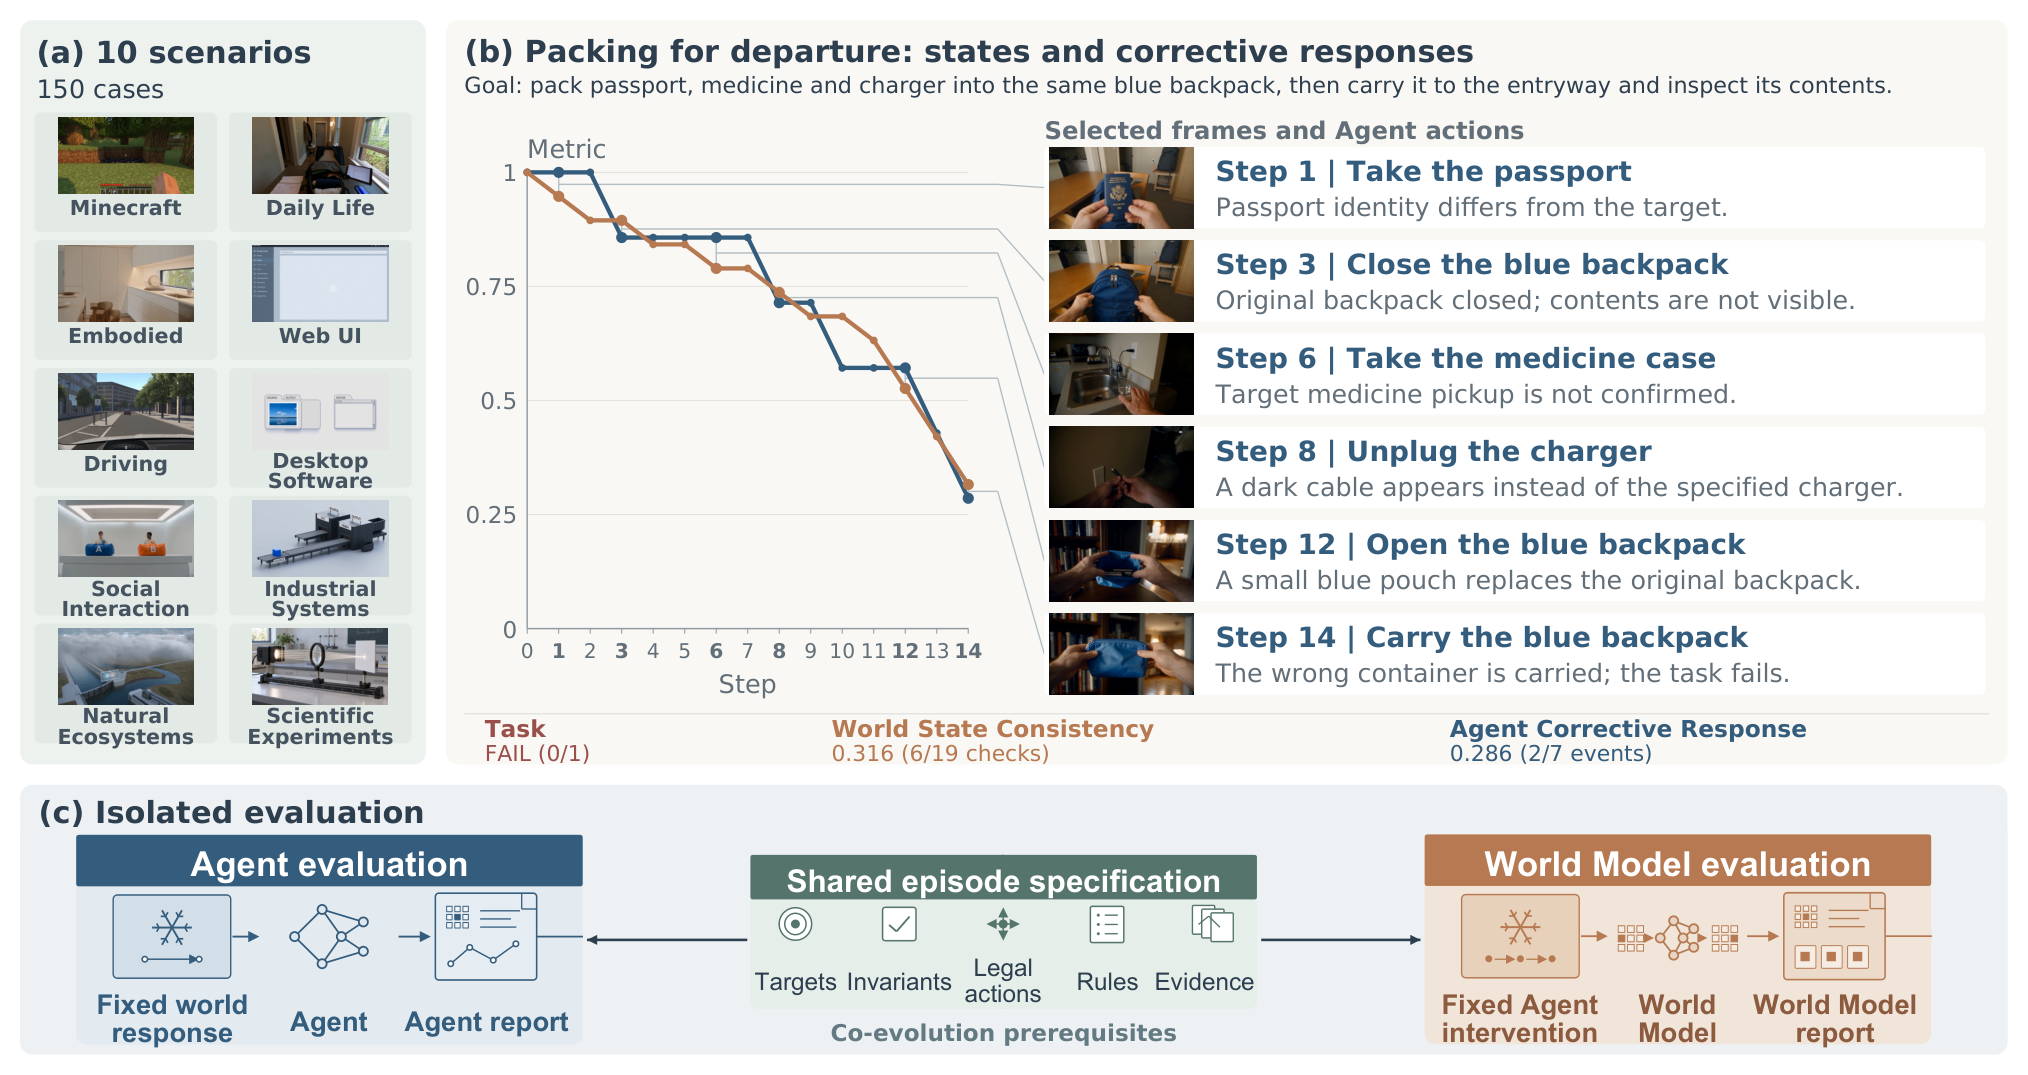
- 1
1 · 图2先展示耦合失败,再限定诊断范围
初步实验固定GPT-5.6 Sol与Seedance 2.5,150例、每例最多20步,纳入样本没有严格成功。背包案例换成蓝色小包后仍继续操作,显示身份保持与纠错问题;该案例是事后审计,不是两组件因果归责实验。
- 2
2 · 固定环境测决策
Agent轨道1088项、15类、四领域,任务有严格成功也有分级分数。计数加权使物理任务占48.16%,科学仅10.02%;科学109项还包含10个由维修流程衍生的检查点,不能当109个独立完整流程。
- 3
3 · 固定动作测世界状态
WM轨道8场景各50例,共400例,检查请求变化、对象身份、受保护状态和规则一致性。15种配置全覆盖,Seedance 2.5仅6场景300例;缺失项不是零,部分覆盖不能混入全覆盖排名。
- 4
4 · 审核评分证据而非只看排名
静态图像可检查对象是否保留,却不能证明摆动周期正确。论文尚未提供独立分层的世界模型评分一致性审计,运行快照、重试数等记录也不完整;固定机制控制变量,不保证参考机制本身无错。
实验与证据
已阅读正文、附录A1/A2以及世界模型评估和运行审计附录B/C/D,核对实验条件与原图;未独立复现。
来源证据Astra案例加权Index31.3居首;等领域加权后DeepSeek从第六升第二。指标混合二元与分级评分。 Agent主表与附录A2 ↗
我的解读排行依赖任务分布,是模型—执行框架配置的描述,不是分布无关能力名次或31.3%统一成功率。
来源证据GPT Image 2全覆盖Overall21.7;MiniMax H3为17.3,但具身场景53.8对20.9,顺序反转。 WM主表 ↗
我的解读整体均分不足以替具体机器人选伙伴;图像/视频提供的时序证据不同。
来源证据没有独立WM输出评分一致性、重复运行区间和完整无效运行审计;6个ToolChoice任务要求prompt未给出的task_id。背包41个适用检查仅19可判定,6通过。 附录C、D:可靠性限制 ↗
我的解读应明确记录未知与协议缺陷,不能把失败全归因于模型,也不能将未知算正确。
来源证据背包曲线从人为赋值1开始,按全轨迹固定分母累计扣分;末值6/19和2/7,两个纠正响应都是导航重试。 图2曲线定义 ↗
我的解读单调下降由定义产生,不证明能力随时间单调恶化;回应也不等于修复成功。
开放情况与使用许可
已核对完整正文、评估规格及证据边界附录;本次未确认作者正式可运行基准仓库或完整原始评测清单,按论文公开标记。
LICENSECC BY 4.0(论文及原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将请求变化与必须保留的状态同时写入任务规格,是评估可交互世界模型的实用方向。
反方 · 哪些结论还不够
两轨没有匹配同一批交互episode,无法建立总分与闭环成功的映射;协议、历史样例与当前榜单不能混同,缺置信区间和独立审计限制强结论。
综合判断
更适合作为评测方法和待验证诊断清单阅读;不宜用其点分数作精确采购排名或宣称协同进化已经实现。
我会先做的验证
未执行的验证方案:先冻结同一组病例与rubric,做复制末帧、真正no-op和打乱动作三类各自正确目标的对照;再配对Agent/WM重复闭环运行,独立双人审计和按共享模板聚类估计区间。