E0.5:用未来几何监督世界动作模型
不预测未来RGB,也能给动作学习提供结构信号吗?
E0.5以可训练几何骨干连接动作扩散,让模型预测动作块终点的几何,而不是仅靠视频外观。其短预算消融支持未来几何监督,但训练集几何误差不能作为未见未来预测精度的证明。
图解主要方法
不预测未来RGB,也能给动作学习提供结构信号吗?
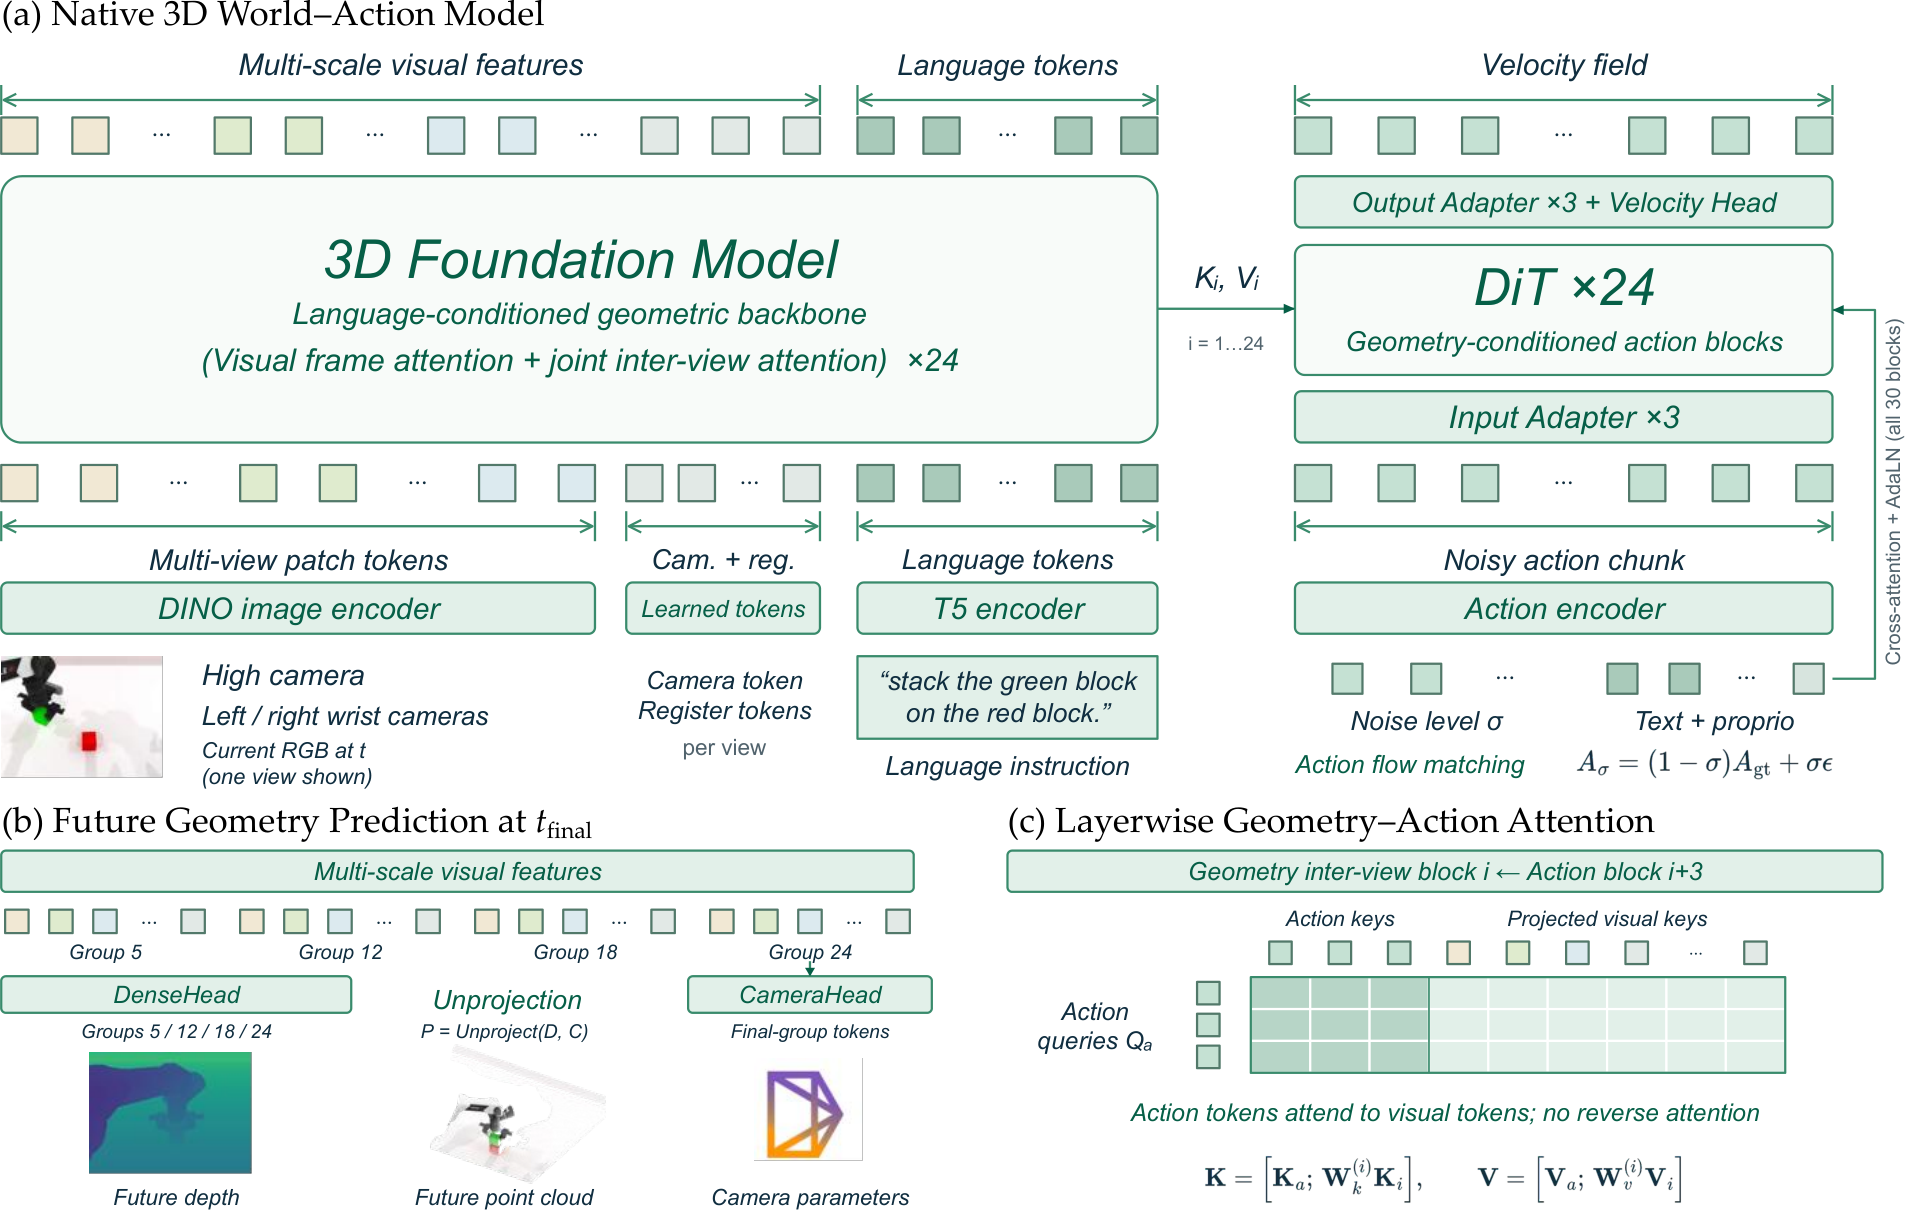
- 1
几何骨干读取当前观测
VGGT-Omega接收当前三个视角,冻结T5提供语言特征。语言进入全局注意力而非帧内注意力;深度与相机头可回投点云,不能把点云回投另说成独立预测头。
- 2
用混合注意力连接动作
30层、1024宽动作DiT通过第3–26层的24处桥接与几何流交互,前后各留独立层。动作流匹配与终点几何联合训练,损失为动作项加0.01几何项;输入不包含未来RGB。
- 3
把未来结构作为训练约束
32步动作块末端的深度/相机目标迫使表征承载动作后果;推理可以不显式输出几何头,用10步流匹配生成动作。这是辅助监督的作用,不等于系统进行了显式几何搜索规划。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据每任务50条干净示范,共2500;约50.75轮训练。干净条件4495/5000=89.90%;随机条件2442/4848,按任务宏平均50.09%。 RoboTwin 50任务 ↗
我的解读随机环境四任务未满100次,不能把总成功数除以5000;也不是所有随机环境基线中最高。
来源证据无几何监督46.53%,当前几何48.03%,未来几何55.96%,后者高7.93个百分点。200个训练样本/600视角的未来深度AbsRel为0.02315。 等预算五轮消融 ↗
我的解读等预算消融支持未来目标有用;训练样本的深度误差与主实验长训练成功率必须分开。
来源证据AgiBot Beta约2645.64小时用DA3伪深度监督;Piper和Zerith H1各600条后训练示范、三任务ID/OOD每格10次。预训练后平均成功Piper85%、H1 88.3%。 预训练与实机 ↗
我的解读伪深度不是传感器真值,小规模实机平均值包含任务差异;部分OOD任务不优于基线,不能宣称普遍鲁棒。
开放情况与使用许可
已核对论文全文与托管许可;未确认完整代码、权重及预训练数据开放,不能把基础几何模型可用等同于E0.5开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
未来几何提供可解释的结构目标,短预算消融比单靠主表更能说明监督设计的价值。
反方 · 哪些结论还不够
未来几何诊断来自训练集,预训练规模大且未设独立验证集;真实测试数量有限,随机化性能仍有明显缺口。
综合判断
几何监督值得继续投入,但必须补上留出未来预测、错误校准及真实域外操作验证。
我会先做的验证
未执行的验证方案:在留出轨迹按预测时距评估深度、相机与遮挡误差,并在相同动作成功率下比较未来几何、当前几何与未来RGB的算力和数据成本。