Easy-3Dfy:让独立生成的网格找到场景中的位置
场景重建的改进究竟来自更好的资产,还是更准确的摆放?
Easy-3Dfy把物体补全、网格生成和场景布局分开,用RPF点云对应把完整物体配准到单图可见表面。在共享同一批网格的对照中,摆放指标改善;这不是生成器本身变强,也没有证明纹理、UV、PBR或接触物理均已解决。
图解主要方法
场景重建的改进究竟来自更好的资产,还是更准确的摆放?
- 1
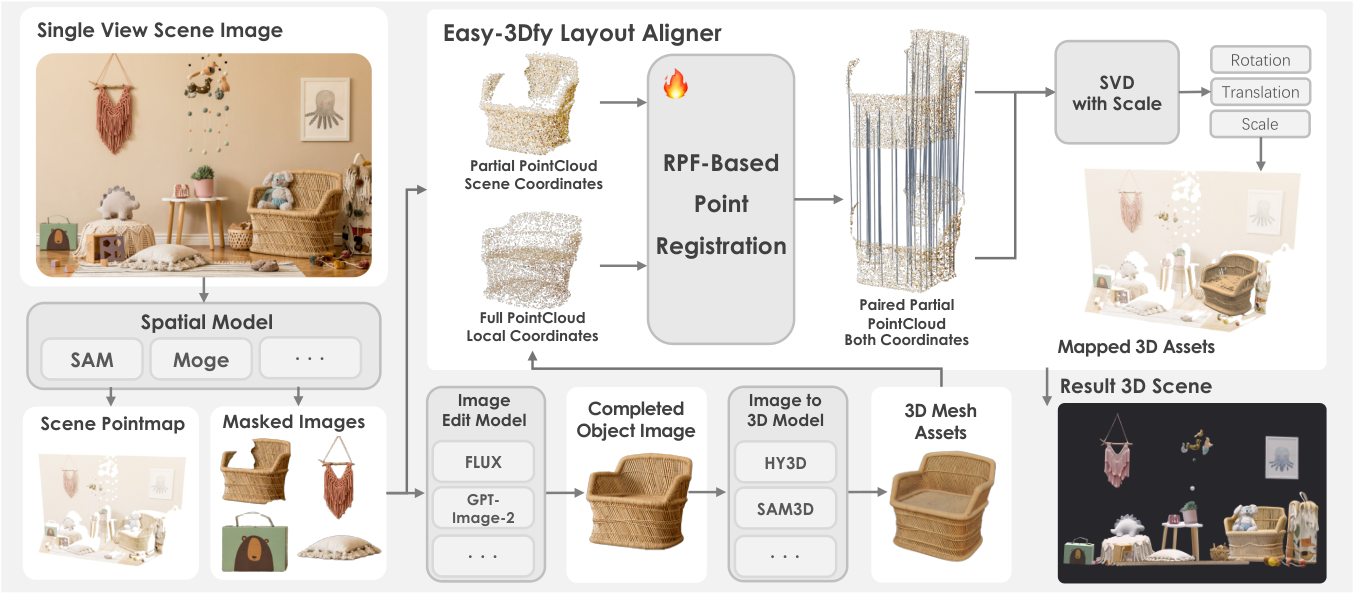
1 · 图2先形成三个可替换接口
输入单图与物体mask,点图模型估计场景几何,图像编辑器补全被遮挡对象,再由image-to-3D模型生成局部坐标网格。基准直接提供mask,分割质量不在此次检验范围;去光照只是补全prompt的要求,不是独立材质分解能力。
- 2
2 · 将可见表面与完整物体做对应
每个网格采8192锚点,场景mask中采8192可见查询点,使用XYZ和法线六通道。RPF输出每个查询点在完整资产坐标里的对应位置,故一个可见灯罩点可以定位到完整灯具表面;不输入RGB,避免外观差异污染几何。
- 3
3 · 用物体级数据训练配准
从单物体渲染配对RGB和深度,用单目模型预测查询点,再加随机遮挡、旋转、缩放和平移。深度提供像素对应真值,rectified-flow学习从噪声到对应位置的速度场,无需完整多物体场景监督,但仍需大规模物体几何训练数据。
- 4
4 · 拟合统一尺度变换并保留完整网格
对预测对应以Umeyama/SVD拟合旋转、平移和单一scale,再变换整张网格拼场景。所有点等权,未用点图置信度加权;它不会修补拓扑或自动生成关节、UV和PBR,质量仍受上游资产形状与遮挡影响。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据Scene-Maker1000场景、3D-FUTURE200共200场景,所有方法共享mask。相同SAM-3Dfy网格下Scene-Maker CD 0.261→0.242、BBox IoU 0.366→0.399;家具集IoU 0.517→0.554。 表1:相同资产的布局对照 ↗
我的解读控制资产后仍改善,支持几何配准贡献;Object-CD相同是预期结果,不能宣称本方法提升了网格本身。
来源证据先以真值包围盒确定全局scale,再优化60步刚体对齐;物体指标另做单体归一化及配准。失败项CD排除,F-score/IoU记零。 附录A3:评估对齐 ↗
我的解读衡量的是对齐后的几何和布局,不证明绝对米制尺度;CD还需与失败率一起看。
来源证据换更精细生成器不保证更高布局分;六通道优于加入RGB的九通道。RPF每批几秒,上游补图几十秒、精细资产可约一分钟。 表4及附录 ↗
我的解读纹理更清楚不等于几何更相容,总延迟受多模块与并行度支配。
开放情况与使用许可
官方项目页已打开,论文复现声明仍承诺未来发布;本次未找到可运行方法仓库,按论文与展示公开处理。商业上游API/网格模型各有独立许可,不由论文CC BY替代。
LICENSECC BY 4.0(论文及原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
资产接口与布局接口解耦,便于在不重训配准器的情况下替换网格来源;同资产实验把贡献分得较清楚。
反方 · 哪些结论还不够
小物体、重遮挡、反光透明表面和mask污染会使位姿欠约束;几何指标不覆盖材质、接缝、纹理清晰度、碰撞自由或场景完整性。
综合判断
适合研究已有资产如何装配进单图场景,尚不能当作可直接入库的完整3D资产流水线。
我会先做的验证
未执行的验证方案:固定mask和网格,比较原布局与RPF布局的穿插、落地接触、旋转误差和失败率;再导入DCC检查UV接缝、PBR贴图与多光照渲染,分别归因上游资产和布局模块。