EpicWorldModel:用多个潜在未来引导遮挡环境中的探索
随机JEPA与方差奖励提高部分导航成功率;预测分散不等于已校准的信息增益
EpicWorldModel将确定性的未来特征回归改为条件流匹配,在潜空间采样多个未来,并在CEM规划时奖励预测方差。PointMaze改善明显,复杂动作空间收益较小。RoboCasa遮挡分组支持探索有用,但仅六个强遮挡样本,且理论上界和采样配置存在需要澄清的细节。
图解主要方法
当目标被遮挡时,多个未来的分歧能否帮助规划器先探索再到达目标?
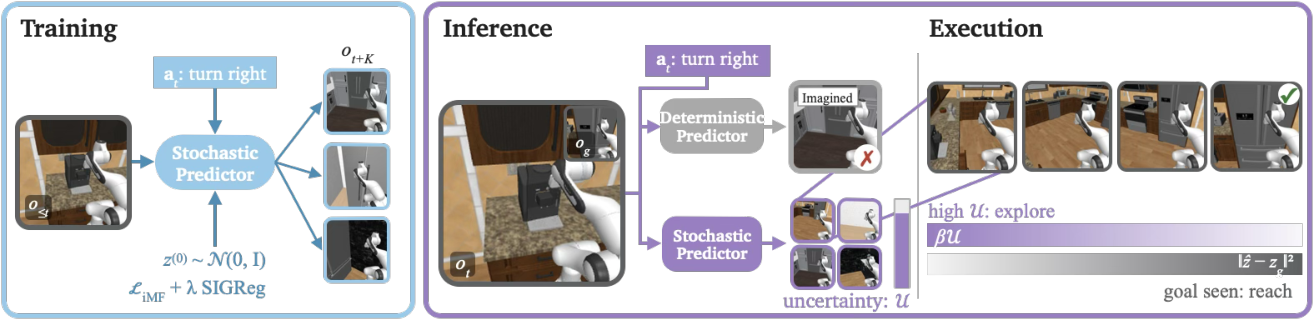
- 1
共同学习预测所需的潜空间
基础环境使用从头训练ViT-Tiny、192维特征,目标图像经同编码器得到目标潜变量。SIGReg约束随机一维投影接近标准高斯,防止表示塌缩;RoboCasa例外,冻结DINOv3后训练投影器。
- 2
把未来回归改成条件分布采样
高斯噪声与真实未来潜变量之间直线插值,以历史观察和动作块为条件训练速度场。因果掩码限制未来token能看到的内容,避免直接读取后续目标特征。
- 3
平均速度降低每次采样成本
iMeanFlow用平均速度和停止梯度的雅可比向量积目标训练,减少ODE求解次数。基础实验主要用iMF两次、普通FM十次函数评估;RoboCasa表中FM为五次,需要与附录配置区分。
- 4
用未来分散程度构造探索奖励
同动作从不同噪声采样未来,按维度平均样本方差U。规划目标兼顾到目标的平均潜距离和减去beta乘U;附录实现把两项在候选间分别标准化,不是直接按未经缩放的公式相加。
- 5
CEM反复筛选再执行动作块
25步由五个动作块组成,300候选每轮留30条精英、共30轮,选出序列后开环执行再规划。探索与到达目标的权重需选取;已能看见目标时继续探索可能反而降低成功。
实验与证据
全文66812字符及附录A–C全部阅读,图1核验;arXiv首发许可、作者主页与公开资源检索核对。
来源证据PointMaze:iMF84%±3.6、FM86%±2.6,LeWM64.5%±2.9,DINO-WM67.8%±1.8。 4.2–4.3 ↗
我的解读FM相对LeWM差21.5个百分点,摘要约22%应按百分点理解;并非相对只增长22%。正文称三训练种子及三评测种子,附录单次消融不能混为同一统计。
来源证据AntMaze FM30%、iMF28%,与基线相当;CarRacing iMF30%、LeWM16%。 4.3;图3、5 ↗
我的解读高维动作空间仍困难,收益不能从PointMaze推到任意机器人操控。
来源证据RoboCasa500人类示范72786帧,同冻DINOv3,100epoch;60例按距离汇总LeWM45%、iMF无探索71.7%、有探索80%、FM90%。 表1;B ↗
我的解读这里并非端到端共同训练视觉编码器。LeWM三倍候选组每格仅8–12例,也不是所有方法都有一致60例。
来源证据可见度小于0.5仅六例:iMF无探索1/6、有探索5/6;可见度≥0.95时21/22→19/22。 表2 ↗
我的解读遮挡收益是初步小样本证据;已可见时探索会分散目标优化。该表总39例,不能与距离表60例混用。
来源证据PointMaze单次消融iMF四次评估beta0:76.5%,beta0.4:83.5%;FM十次79.5%→85.5%。 C.1;表3 ↗
我的解读约7和6点是探索项的额外贡献,剩余差异还来自随机预测器;不是全部21.5点都由探索奖励带来。
来源证据LeWM候选300→6000:表4 64%→74%;iMF两次74.5%、四次83.5%。 C.2;表4 ↗
我的解读额外搜索能弥补部分差距。表前文字写默认54%但表为64%,应以表值引用并保留冲突;近似计算匹配不是实测等墙钟。
来源证据正文每候选10个噪声,表5却标5为主结果默认;表5iMF称NFE2但默认83.5与表3NFE4相同。 4.2;C.1–C.3 ↗
我的解读这是具体复现歧义,应要求配置确认,不能自行选择一组数字拼成一致实验。
来源证据附录全方差推导得到对条件分布平均的E[U]≤约1。 命题2;A,式29–33 ↗
我的解读正文称U在[0,1]过强:平均界不推出逐条件界;无偏方差估计也不使对数插件成为确定熵上界。
来源证据命题1对独立高斯源和高斯目标推导速度目标条件协方差。 命题1;A ↗
我的解读训练网络还条件于历史与动作,目标条件分布未必高斯;目标噪声协方差也不等于乘网络雅可比后的参数梯度协方差。
来源证据50例中目标潜距离17.4±5.1→10.4±5.8,预测方向中位余弦0.88;单例PCA椭圆60.99→11.86。 4.6;C.4 ↗
我的解读支持潜预测随任务推进,但最接近真实未来的样本是事后选择,PCA二维收缩也不能证明完整后验信息获取。
开放情况与使用许可
已打开论文和作者主页,主页该项只链接论文;未核实到官方实现、权重或完整配置。检索不到不证明永不公开,本次不标开源。
LICENSE论文与图1CC BY 4.0;未核实代码、权重许可,不将论文许可视为模型开放许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
随机预测加探索与beta=0对照允许区分表示能力和探索奖励,部分遮挡任务确有额外收益。
给确定性LeWM更多CEM候选后仍有部分差距,不能简单将全部收益归于搜索次数。
RoboCasa固定同一冻结DINOv3编码器和训练数据,减少视觉骨干差异造成的混淆。
反方 · 哪些结论还不够
全方差公式只给平均条件方差上界,不能保证每个条件或有限样本方差都不超过1;采样方差代入对数也不是严格总体熵界。
连续确定性流的条件微分熵不能直接当0,噪声种子不是未知环境参数后验,因此EIG联系应视为启发,不是已证明的真实信息获取量。
正文N=10、附录表5默认N=5;iMF若干NFE与结果对应不一致,复现需要作者配置。强遮挡分组只有六例,尚不足稳健泛化。
综合判断
作为探索奖励的经验方案有价值,尤其在低维动作、目标暂不可见的任务;理论解释和绝对不确定性刻度不应当作已校准保证,报告的收益也非所有环境普遍成立。
我会先做的验证
建议实验(尚未执行):公开固定配置和各随机种子结果;加入无关随机干扰的“噪声电视”测试,比较方差奖励与真正后验信息增益,扩大遮挡样本,并测目标已可见时自适应关闭探索及实际规划延迟。