Feedback World Model:让预测残差进入下一次动作规划
冻结世界模型之后,反馈校正能补偿多少分布偏移?
这篇五月首发、十月修订的工作在冻结模型外加入反馈观测器:比较真实潜状态与预测信念,再校正候选未来。它可低成本缓解部分偏移,但稳定性依赖假设,且动作引导本身仍有明显计算成本。
图解主要方法
冻结世界模型之后,反馈校正能补偿多少分布偏移?
- 1
先定义预测信念与残差
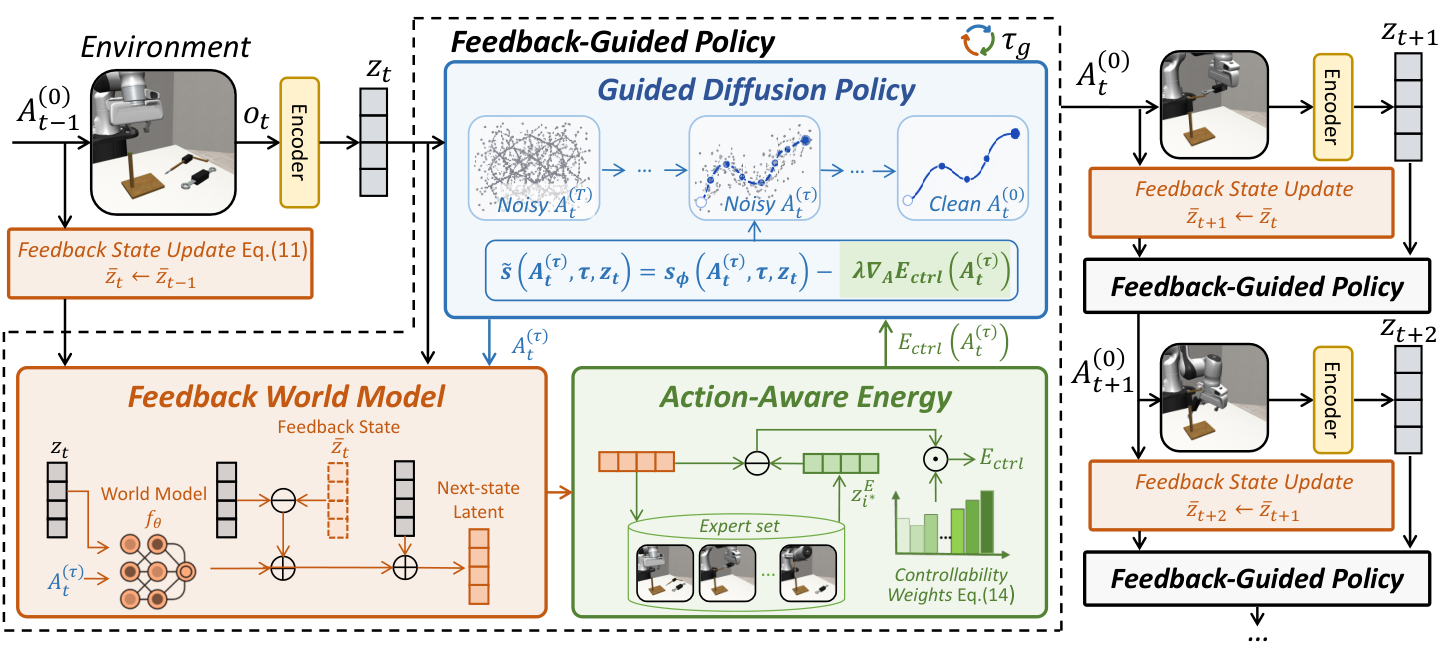
当前观测编码为z,与上一轮保留的信念状态相减得到e。冻结世界模型预测候选动作后的状态,把预测速度加上L乘e;同一轮所有候选去噪保持残差固定,避免把未执行候选当作真实反馈。
- 2
执行后才更新闭环
执行动作块前15步,推进信念,再用新的真实观测形成下一轮残差。理论收敛要求残差收敛及I−ΔtL稳定;不能从线性观测器条件推导任意域外机器人都稳定。
- 3
用动作可控性加权专家引导
从200状态、每状态32个示范动作估计潜维度变化,归一化后与均匀权重混合;在100步DDPM的最后15步,用加权最近专家潜状态能量引导。反馈纠错与专家引导是不同模块。
- 4
区分视频模型扩展
FastWAM实验对未来视频VAE残差做0.7旧值+0.3新值的指数平滑,再加权校正预测。它不是原观测器公式的同一实现,不能直接继承全部证明。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据七仿真任务平均成功52%,基础40%、普通引导43%、滚动引导45%;实机R1 Lite右臂两任务OOD每格20次,从40%到80%、20%到70%。 仿真及真实任务 ↗
我的解读支持特定偏移下有效,20次试验不确定性较宽;并非双臂或多平台全面验证。
来源证据393个OOD回合7553组配对调用,潜误差0.3015到0.2464、约降18.3%,任务成功77.1到81.4。 FastWAM扩展 ↗
我的解读像素误差相对于VAE重建而非原始真实图像;预测误差改善与闭环成功需分别解读。
来源证据过大增益1会令误差增加9%–20%;RTX PRO 6000上基础484ms、一般引导约另需525ms、反馈约15ms、加权不足1ms。 稳定性与耗时 ↗
我的解读反馈边际代价小,但完整引导合计约1.02秒,不能写成整个方案只增加15ms。
开放情况与使用许可
已查看作者仓库的反馈规划实现、训练/评估目录及LICENSE:主体代码MIT,附第三方来源说明;示范数据需从上游获取,不在仓库再分发。未核实完整预训练检查点与模型卡,本次未复现。
LICENSE作者版权;arXiv非独占托管许可;主体代码MIT,第三方代码单列
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
利用真实观测持续纠偏,能在不重训模型时给开放环预测增加反馈,并清楚暴露增益和时延的取舍。
反方 · 哪些结论还不够
依赖有用潜空间、专家近邻和稳定增益;20项扰动测试仍有两项下降。理论假设与视频残差扩展不是普遍鲁棒性保证。
综合判断
值得作为冻结世界模型的外层校正器测试,尤其适合可观测、偏移缓慢的任务。
我会先做的验证
未执行的验证方案:在突发外力、观测遮挡和长期偏移中扫描反馈增益,固定总规划时间比较有无专家引导,记录成功率、最坏延迟与累积误差。