FilmFlow:在已有3D场景里生成可执行的镜头计划
轨道、升降和构图锁定能否同时执行,并在渲染后修正?
FilmFlow把语言或参考视频转成Blender中的显式相机轨迹,用22种原子操作表达并发运镜,再通过渲染反馈修改时间与参数。它生成的是可编辑镜头而非新场景资产;评价需区分外部视觉分数、人类偏好和实际镜头行为通过率。
图解主要方法
轨道、升降和构图锁定能否同时执行,并在渲染后修正?
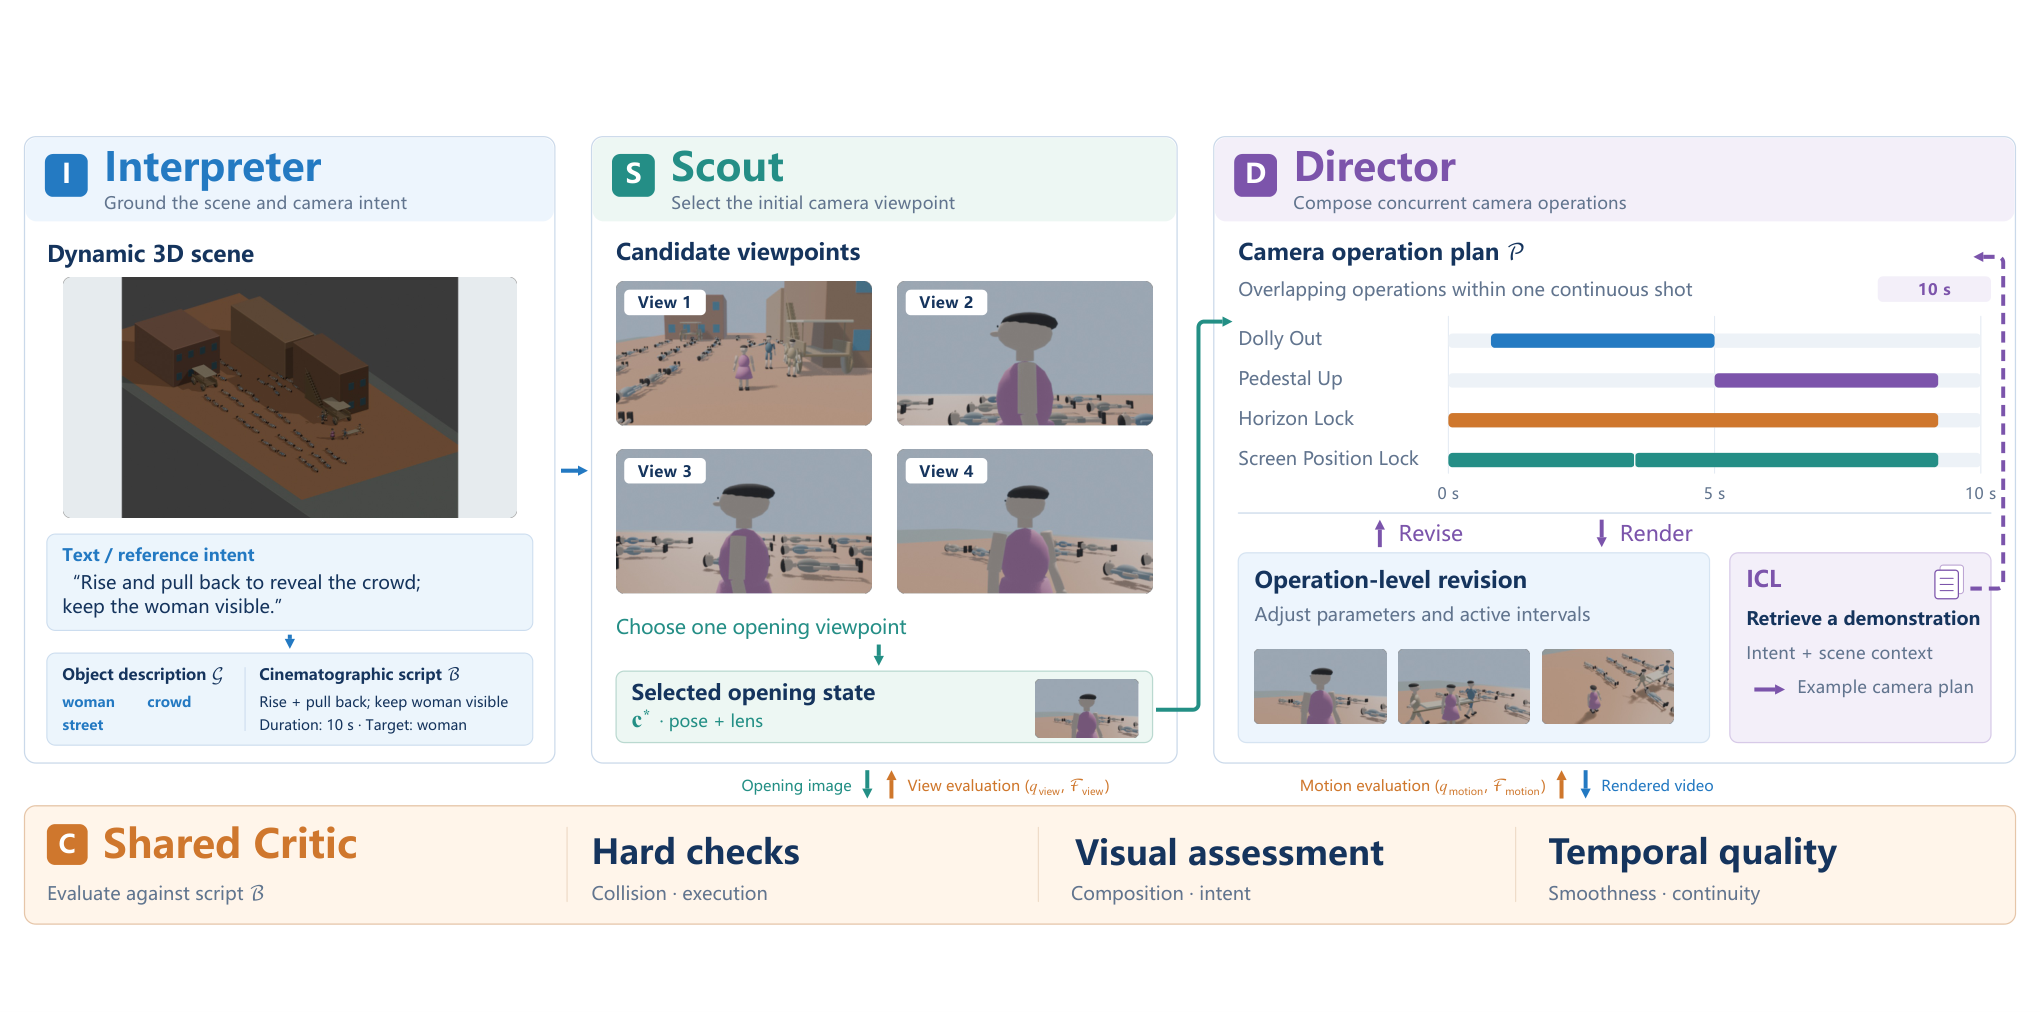
- 1
1 · 图2左侧先理解已有场景
Interpreter读取对象、几何与动画,提取主体、时长和拍摄意图;视频输入还用LingBot-Map估计相对位姿作为辅助。参考位姿的米制尺度未确认,不能直接复制成目标场景坐标。
- 2
2 · Scout在规划前选开场
每轮至多6个渲染视点、最多两轮,按构图、主体可读性和指令匹配评价。开场一旦选定,后续Director不能修改;如果预算内未过阈值,会保留最高分临时开场,不应描述为全部开场都验收通过。
- 3
3 · 以带时间区间的22类操作组成镜头
每项包含类型、参数、起止时间,轨道环绕、前移和升降可重叠。平移相加,角度按指定轴组合,焦距按比例相乘,跟随与锁定有独立规则,最终逐帧烘焙相机关键帧;不是对完整相机状态简单逐项相加。
- 4
4 · 反馈指出哪个动作在哪段出错
Critic综合碰撞/执行检查与最多10帧T2V或16+16帧V2V视觉证据,Director修改动作、参数或重叠时段,最多三轮额外修订。仅从开发场景检索已验收示例,测试场景独立;超过阈值也可能残留构图偏差。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据总150 Blender场景、750语言任务、60参考视频;50开发场景构建示例库,实际测试100场景500 T2V及40 V2V。 CinemaBench划分 ↗
我的解读总数据量不是测试量,动态场景和现成资产是前提,不含自动建模验证。
来源证据42人随机盲评,完成420个T2V、397个V2V排名;FilmFlow人类通过率84.3%/82.1%,首选率61.0%/63.2%。 主表与人评 ↗
我的解读Probe 0.829等是模型匹配概率,不是人类通过率;评价次数也不是独立场景数。
来源证据完整系统在V2V Probe为0.750,去掉ICL为0.766,其他主要指标支持完整系统;平均2.23分钟、6.23调用、69.5k token,含失败但不含最终导出。 消融与成本 ↗
我的解读没有所有指标都提升;生成显式镜头也有模型调用与渲染成本,非实时控制证明。
开放情况与使用许可
官方项目页与论文已公开,复现声明为未来释放实现和CinemaBench;本次未找到正式可运行FilmFlow代码入口。第三方场景和影片不因论文CC BY自动获得再分发许可。
LICENSECC BY 4.0(论文及原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
并发操作、时间区间和烘焙关键帧保留了DCC可编辑性,渲染反馈能落实为具体镜头修订。
反方 · 哪些结论还不够
依赖大模型和已有完整3D场景;部分位姿转移基线没有场景适配,比较包含系统设计差异。资产许可、碰撞漏检与未采样帧问题仍在;不输出网格、UV或PBR材质。
综合判断
适合作为虚拟摄影辅助流程;镜头验收和资产授权仍应独立完成,不能称作一键生成完整电影。
我会先做的验证
未执行的验证方案:在自有动画资产上设轨道+推近+构图锁定任务,逐帧验碰撞、遮挡、速度和目标屏幕尺寸;同预算比较顺序操作、并发操作与人工关键帧,保留全部失败和API成本。