Flow3D-Pro:把低分几何的流轨迹引向配对的高分形状
动态归航优于简单排斥,但理论收敛依赖理想速度场,收益尚未覆盖材质资产
Flow3D-Pro在Hunyuan3D 2.1几何骨干上提出动态归航优化DHO:同一图像生成一组网格,由视觉语言模型打分,再用一对一最小代价匹配为低分结果指定高分终点。训练将负样本路径上的速度改向正样本,而推理仍使用普通流积分和冻结的LATTICE细化。
图解主要方法
如何让低分三维几何的生成路径有明确的改进方向?
- 1
先建立几何SFT起点
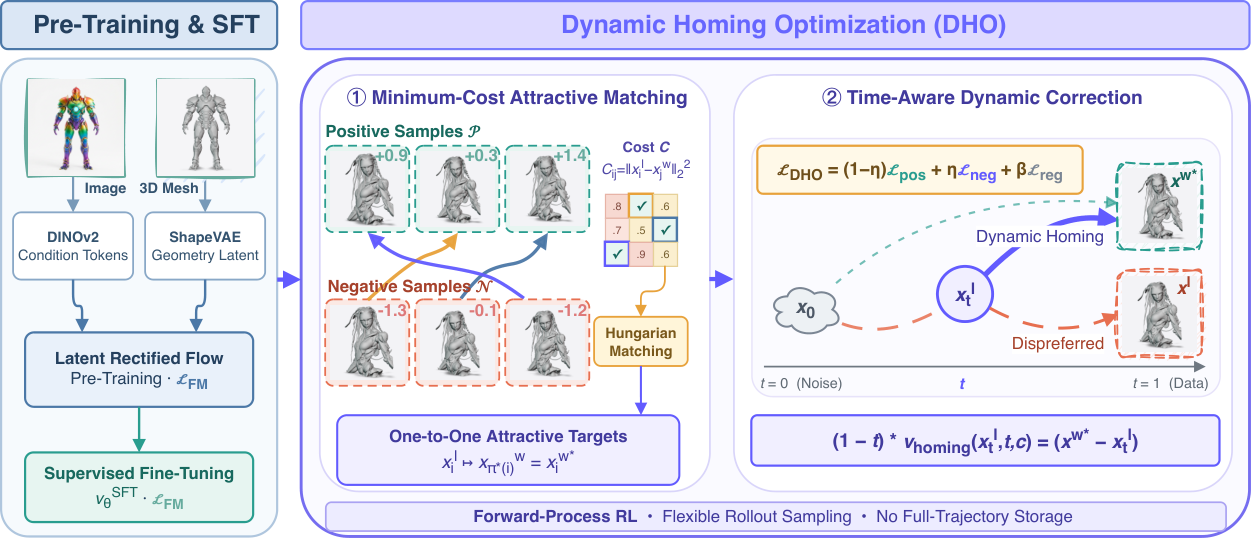
图3左侧用DINOv2图像条件和ShapeVAE几何潜变量训练流模型。在Hunyuan3D 2.1骨干上用5000个精选形状做SFT;后训练只改第一阶段,LATTICE细化器冻结。
- 2
同图采样、评分并分出正负结果
每张图像采样8个结果,Gemini 3.1 Pro读取参考图和6个规范视角,以重建保真、几何合理性、朝向3:2:1给出1至5级奖励。按组内均值和标准差计算优势,零优势样本不参与正负集合;这只是可见几何判断。
- 3
给负样本指定不同的正样本终点
图3中部以潜变量平方距离构造代价矩阵,通过匈牙利算法一对一匹配。同一条件内正负集合取相同数量;正样本过多优先高优势,负样本过多随机取。局部一对一减少争抢单个目标,但潜空间距离未必等于语义或拓扑距离。
- 4
在负样本路径上学习动态归航
在噪声与负终点之间插值到x_t,用到目标正终点的剩余位移除以1−t作为速度目标。实际损失用等价的有界残差形式,避免目标在终点附近数值发散;它不是沿着每条完整随机采样轨迹保存监督。
- 5
混合正样本拟合和参考约束
总目标由0.9正样本流匹配、0.1负样本归航及权重1的冻结参考速度均方约束组成,并做正优势加权。该约束没有计算策略KL。异步28张GPU采样、4张GPU训练,按版本控制样本新鲜度。
- 6
普通流积分生成,再做冻结细化
推理第一阶段50步ODE,第二阶段5步ODE,最终细化网格分辨率1536。证明中的固定匹配和速度场收缩是理想分析条件;实际神经网络更新、不断重配对及跨条件泛化仍需实验检验。
实验与证据
完整阅读正文、参考文献及附录A–C,核对证明假设、奖励提示、超参数与消融;视检原图3。未复现训练、人工评分或生成。
来源证据5000个形状做SFT,1000张图像做后训练;所比RL方法各5000步、AdamW学习率2.5e−6、batch2、bf16、组大小8。 第4节、附录B实现 ↗
我的解读训练起点和主要设置对齐有助于比较,但并非每种基线都获得相同程度的超参搜索,也不意味着奖励API调用成本相同。
来源证据GenMeshTest有200张未见图,3随机种子报告均值;每张图由3位专家匿名、随机顺序排序。 评估协议 ↗
我的解读US按同组方法数从U−1到0赋分;只能在对应比较表内理解,且缺少种子方差和置信区间。
来源证据第一阶段DHO ULIP/Uni3D/US为0.149/0.359/4.02,SFT为0.144/0.351/1.93,GRPO为0.147/0.357/3.02。 表1 ↗
我的解读在6方法排序组中支持DHO收益;嵌入相似度变化较小,不能单凭其数值推断全部几何细节正确。
来源证据加入相同第二阶段后DHO为0.150/0.360/4.26,SFT为0.143/0.352/1.91;LATTICEBench上DHO为0.140/0.326,OPD为0.138/0.321。 表1–2及跨基准评估 ↗
我的解读细化后的改善仍可观察;不同测试集或不同方法集合的US不混用,也不把冻结细化器收益全部归于DHO。
来源证据静态修正ULIP/Uni3D/两方法US为0.145/0.353/0.31,动态修正0.149/0.359/0.69。 附录B动态目标消融 ↗
我的解读目标随剩余时间调整有直接支持;0.69在此仅是二选排序平均分,不是生成成功率。
来源证据负样本权重0时US1.13,0.1时1.92,0.5时1.27;去参考约束ULIP0.140,保留权重1时0.149。 附录B权重消融 ↗
我的解读负样本修正并非越强越好,过度偏好移动可能破坏原有生成分布。
来源证据H20单阶段计时:第一阶段62秒,第二阶段81秒,均含相应预处理、编码/解码及转换。 附录B效率 ↗
我的解读顺序运行约143秒,不是单纯去噪核心时间;后训练GPU时、评分费用和部署吞吐仍需另算。
开放情况与使用许可
核对论文公开链接并检索官方实现入口,尚未核实该方法的独立训练代码或检查点。Hunyuan3D和LATTICE作为上游模型的开放状态不能替代Flow3D-Pro本身的开放证据。
LICENSEarXiv非独占托管许可;原图3仅作必要方法评论,版权归作者。方法实现和权重许可尚未核实,上游许可应分别检查。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
统一SFT起点、训练步数、奖励与细化设置下,DHO的几何嵌入分数和盲评排序均优于所测GRPO、DPO与NFT;静态/动态目标消融支持时间感知修正。
负样本项、参考模型约束和最小代价匹配均有消融,收益有具体机制证据。
反方 · 哪些结论还不够
US是同一次比较中按候选数定义的名次分,8.64、4.26和0.69来自不同候选集合,不能横向当作同尺度质量分。
三种子仅报告均值,缺少误差条;200张测试图与粗粒度VLM奖励不足以覆盖开放世界细结构、可制造性和材质正确性。
一对一匹配限制组内目标塌缩,并不证明全局多样性;论文证明也不等于实际训练过程的收敛保证。
综合判断
证据支持在既定几何骨干和奖励下改善形状偏好对齐,动态修正比纯正样本强化更有方法价值。尚不能把它视为完整资产生成、通用RL收敛或任意数据分布上的保证。
我会先做的验证
建议实验,未执行:固定相同GPU时和评分调用预算比较DHO、GRPO及正样本流匹配,在隐藏视角、薄壁、非规范朝向和多部件测试集上测几何误差、重复率及评分一致性;同时报告逐种子区间和预处理到网格的端到端时间,再接统一UV/PBR管线验证下游价值。