Fresco++:先稳定粗结构,再用跨视角共识恢复头像细节
从Fresco的UV一致性扩展到规范表面分组;收益发生在训练阶段
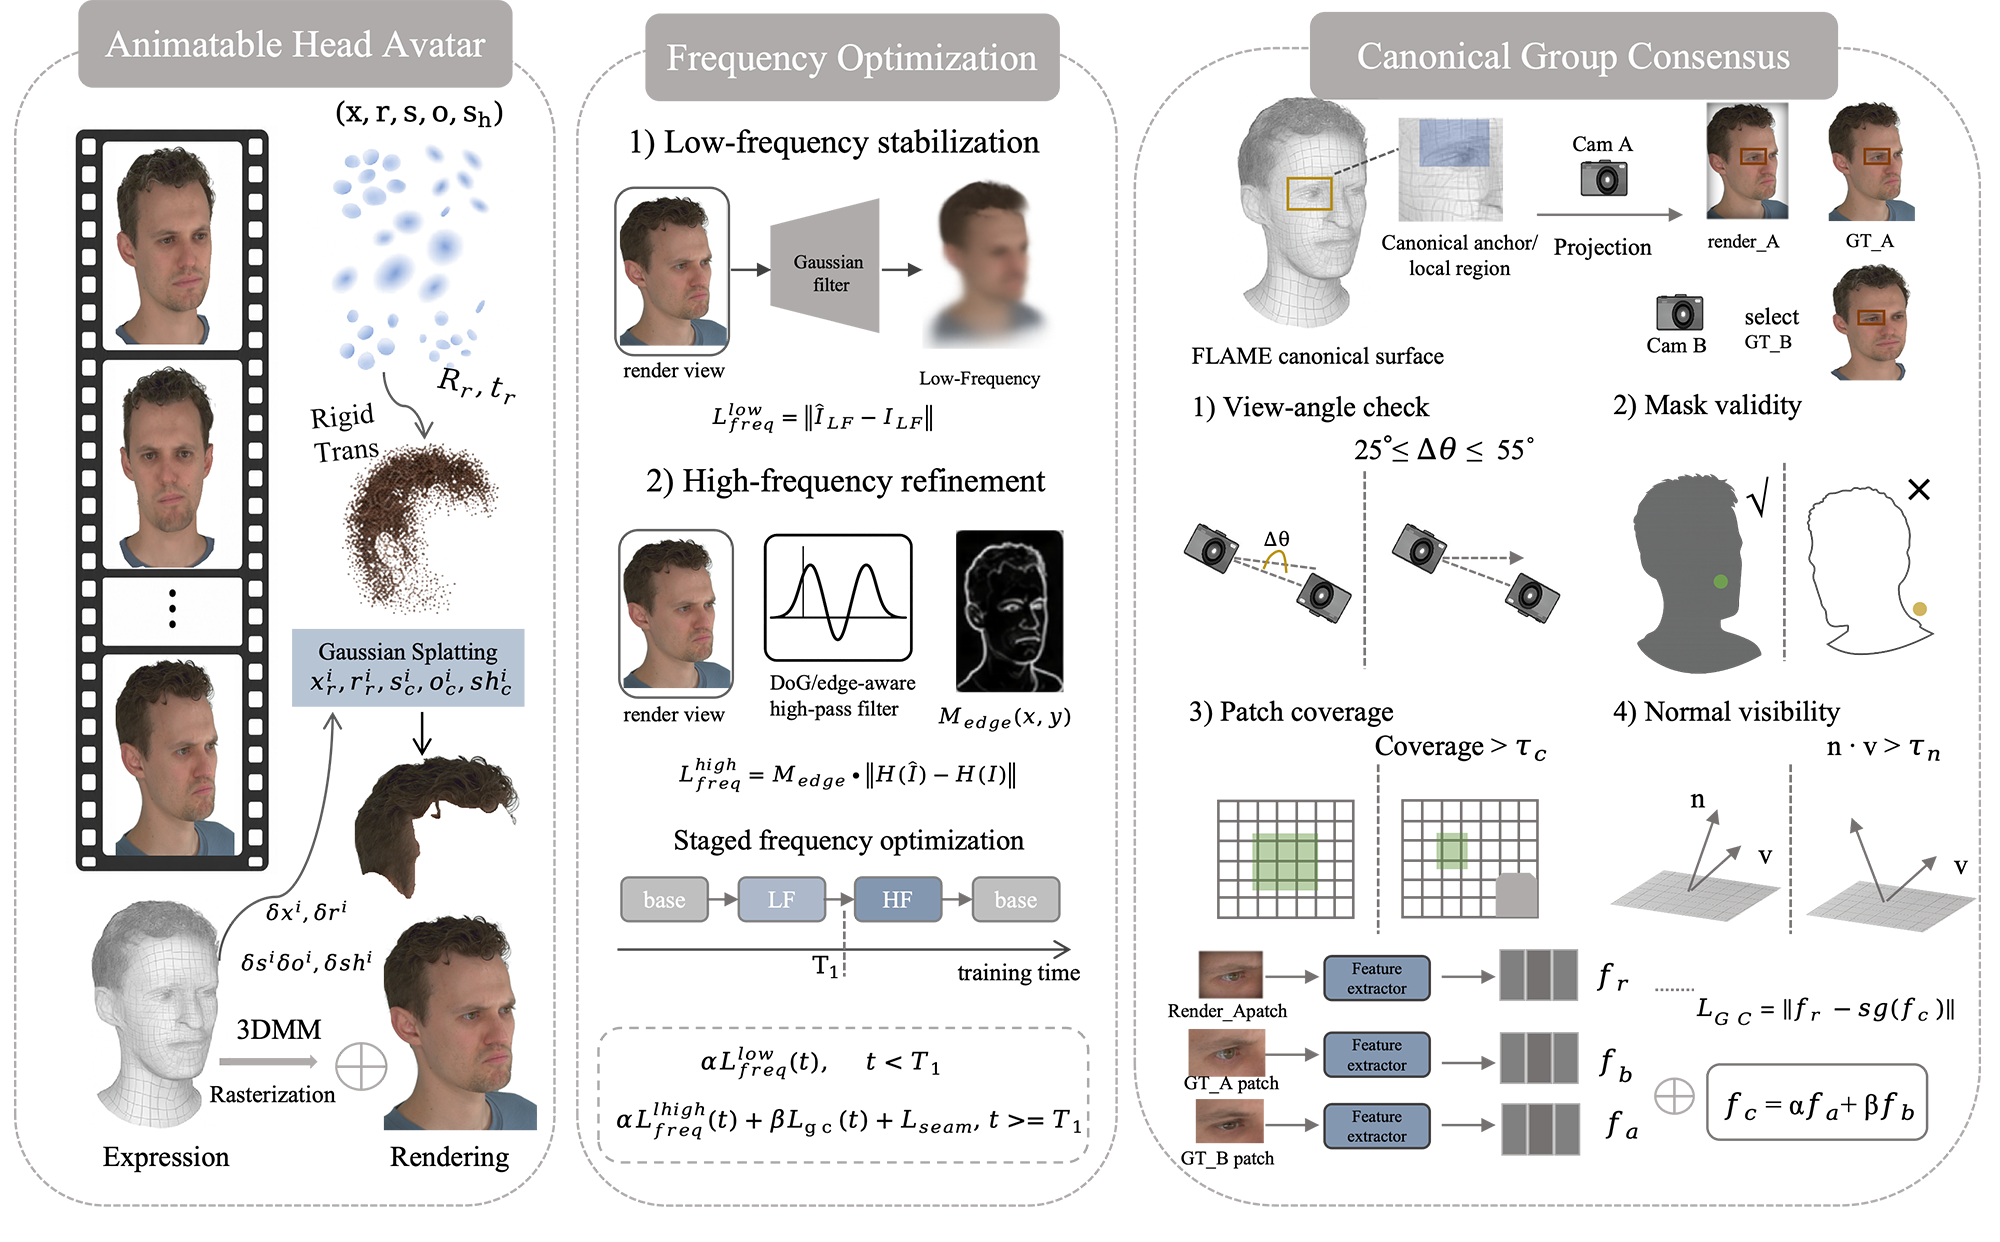
Fresco++为头像重建加入低到高频训练日程,以及Canonical Group Consensus。同步视角通过FLAME表面局部结构建立对应,过滤不可靠观察后,用真实图像特征共识监督当前渲染。
图解主要方法
图1右侧为什么只比较可靠真实观察的特征,而不让两个错误渲染互相监督?
- 1
先把频率监督安排好
图1中间先用高斯模糊图像的L1稳定低频,再用DoG带通、边缘权重和梯度差细化高频。实验100epochs中10–50开启低频及CGC,50–80引入高频,末段回到基础监督;不是一直把所有频率损失同权相加。
- 2
用规范结构而非像素建立对应
图1右侧以FLAME三角面身份形成canonical group,变形后取代表点投影到同步相机。保持局部结构身份,再抽取图像patch;不会直接要求不同视角像素颜色相同。
- 3
先筛可靠观察再汇总特征
检查正深度、图像边界、前景覆盖、法向朝向,并在可用时做深度遮挡检查。辅助视角相差25–55度;两张真实patch经冻结VGG16,以0.5权重形成停止梯度的目标,当前渲染特征靠近它。
- 4
保留原渲染器,衡量训练代价
辅助视角只取真实图像不额外渲染,因此推理流程不变。移植其他Gaussian表示时仍要适配规范结构关联,不能把“可迁移”误解成对所有表示无需工程接入。
实验与证据
已阅读v1完整正文及其公开附录、核对作者实验与必要原图;未独立复现实验。
来源证据八名NeRSemble对象,15相机训练、一相机留出;表I新视角32.18dB、LPIPS0.056,对Fresco31.80、0.058。 §IV / 表I ↗
我的解读是相同数据协议下的幅度改善,不是全场景泛化保证;跨身份表情迁移只有定性评价。
来源证据GaussianAvatars接入后训练7.39→10.90小时,峰值显存2231→2293MB;推理6.12→6.00ms。 表V ↗
我的解读推理差值很小,应解释为基本不变,而非算法加速;训练成本明显增长。
开放情况与使用许可
本文为Fresco扩展版本,有新增CGC与跨表示实验;本次未核实Fresco++实现或权重发布,不能用旧版代码开放状态替代。
LICENSEv1论文及原图为arXiv非独占托管许可;尚未核实Fresco++代码许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同基线下比较UV、CGC、完整方法,并迁移到GaussianAvatars和TensorGA,有助于区分特定表示与监督收益。
反方 · 哪些结论还不够
频率顺序分析只用Subject306,早期视觉例子用074;缺少跨种子显著性。图1局部简写与正文阶段设定需以正文实验参数为准。
综合判断
有针对性的头像优化升级;适合在已有管线做受控对照,不应包装成通用三维生成或材质系统。
我会先做的验证
未执行的验证方案:在相同总训练时间下比较原基线、UV和CGC;留出更多相机角度和表情,单列牙齿、发际线、遮挡与纹理跳变,并检查额外训练时间是否解释收益。