GenIA:在推理时把生成的三维资产重新对齐输入
保留SAM3D先验,用深度、可见性和渲染梯度修正位置与外观
GenIA在冻结SAM3D上加入深度约束的平移尺度估计、可见性注意力、跨观察融合和渲染引导。可选100步对象级细化优化外观latent、低秩解码适配器和位姿;动态场景依赖外部时序几何。
图解主要方法
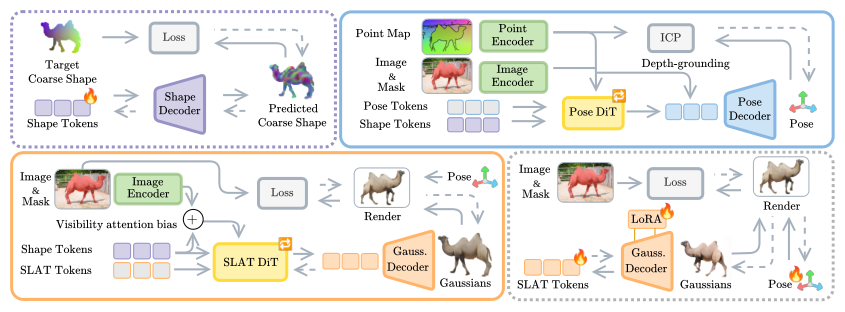
图2哪些模块冻结,哪些对象级变量会优化,如何防止输入拟合破坏未见背面?
- 1
先把物体放对位置
图2上方保留生成旋转,用掩码中心、角尺寸和中位深度初始化平移尺度,五次固定点更新后短ICP对齐。外部时序网格可注入形状token;固定拓扑建立跨帧对应,动态根旋转用多帧速度中位数聚合。
- 2
让可见体素找到观察它的图像patch
图2左下把体素投影到DINOv2 patch网格,可见RGB patch的注意力logit加5,仅作用条件分支。补偿RGB总注意力防止挤压mask/global token;附录承认补偿本身未测到显著质量收益。
- 3
在去噪中用渲染误差修方向
估计干净latent,解码高斯后用RGB、SSIM、LPIPS和深度损失修正流速度。每步按可见性融合多观察;被遮挡高斯停止该观察的梯度,避免未见面为解释前景而被掏空。
- 4
可选对象级细化并保护背面
图2右下用100步优化latent、rank4 DoRA解码适配器及旋转平移;尺度不再更新。latent锚与只惩罚未见高斯不透明度下降的约束保留补全。不是重新训练整个SAM3D,也不是完全不做优化。
实验与证据
已阅读v1完整正文及其公开附录、核对作者实验与必要原图;未独立复现实验。
来源证据表1(a)CO3D单视角SAM3D训练PSNR13.531、测试LPIPS0.524;GenIA加TTR为22.145、0.436。 表1(a) / 附录A.10 ↗
我的解读姿态均按论文协议细化;新视角质量改善应与输入视角拟合分开,且这些结果不是PBR渲染对照。
来源证据单视角CO3D峰值显存SAM3D18.0GB、GenIA19.7GB、TTR31.8GB;动态运行约为SAM3D单图25秒的13倍。 §5.1 / 图6 ↗
我的解读免数据集重训仍有显存与实例优化成本;动态时长包含ActionMesh,不能误写成实时。
开放情况与使用许可
作者项目页有交互资产展示与完整实验说明;本次未核实可下载GenIA实现或适配器权重,不将SAM3D上游开放性算作本方法已开源。
LICENSE论文及原图CC BY-NC-SA 4.0;上游SAM3D、ActionMesh和数据集另有许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
固定GT几何的外观消融与真实预测几何结果分列,有助于辨认外观机制本身及其对上游几何的依赖。
反方 · 哪些结论还不够
DAVIS无真实新视角,CLIP-I比较合成视角与输入外观;跟踪对照CoTracker3伪真值,并过滤40%–60%查询,不能声称真实跟踪准确率。
综合判断
将可见证据与不可见生成先验分工的有效方向;资产可用性仍受上游形状和标定制约。
我会先做的验证
未执行的验证方案:在同一GT/预测几何两组中逐项关闭注意力、渲染梯度和适配器,报告观测面与背面质量、深度误差、显存及材质重光照差异;不要只用CLIP-I。